quran-tajweed-phonetics
收藏资源简介:
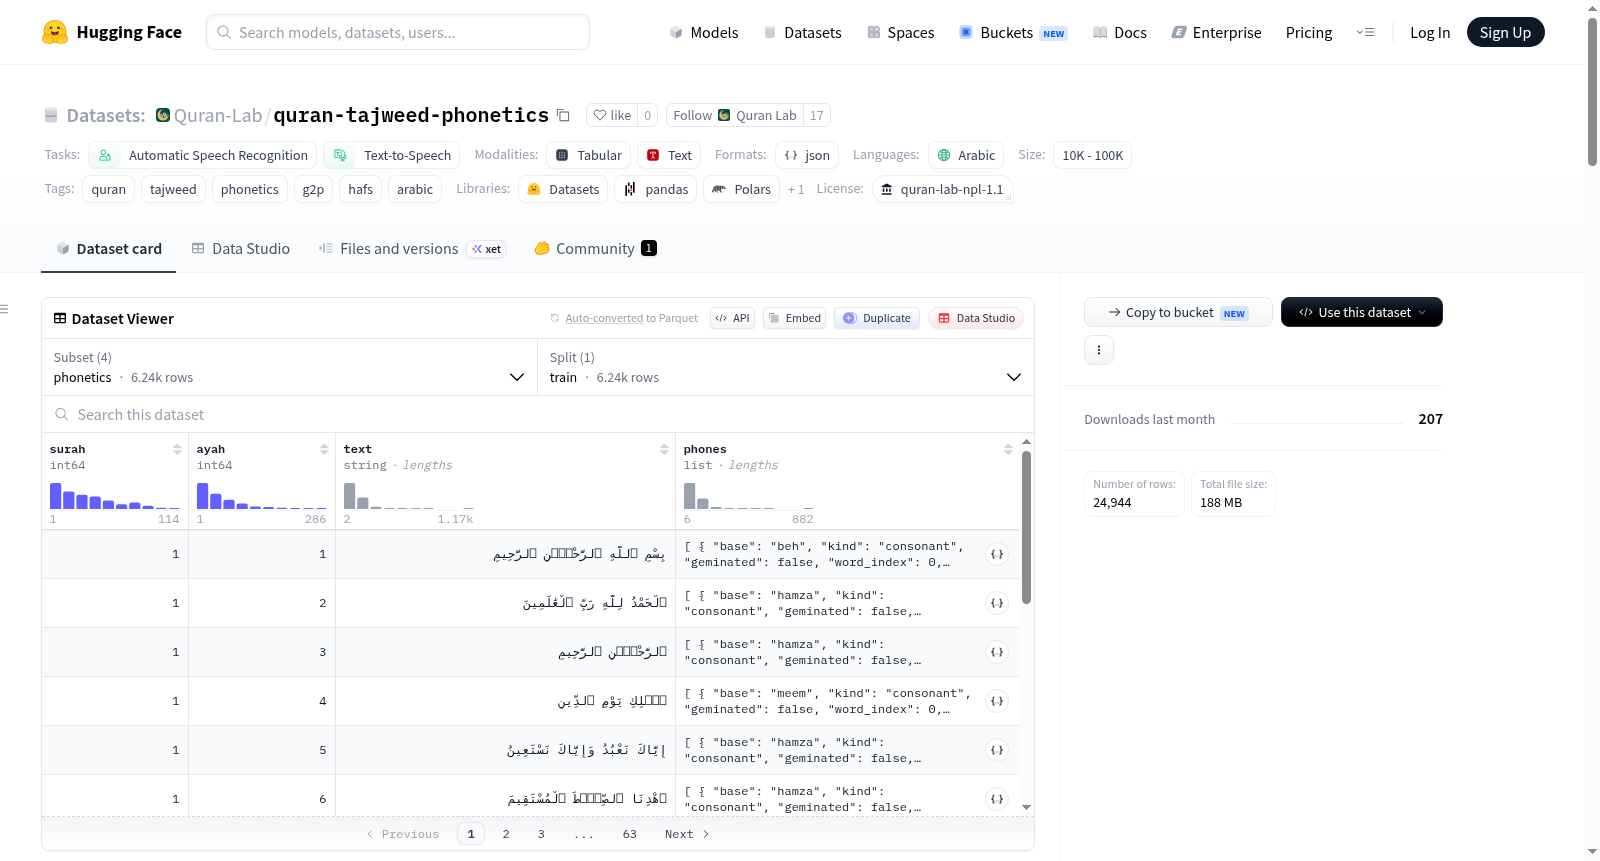
Quran Tajweed Phonetics 数据集是由 Quran Lab 构建和维护的《古兰经》完整语音层数据集,专用于 Hafs an Asim 传述体系(al-Shatibiyyah 路线)。该数据集包含 6,236 节经文(ayah)的 522,475 个音素(phone),每个音素携带其 tajweed 属性:包括 madd 类别及其传承长度范围、ghunna 等级、qalqalah 类别、tafkheem 等级及其程度、sakt 标记、十七种属性(sifat),以及产生该音素的规则编号。数据集的构建严格基于古典 tajweed 文献(如 Shatibiyyah 及其注释、al-Nashr、al-Tayyibah、al-Muqaddimah、Tuhfat al-Atfal 等约七十部著作),通过机器辅助索引和页面验证,确保每条规则都有明确的卷页引用。验证结果证明:与两个独立 mushaf 版本(Tanzil、KFGQPC)在全部 6,236 节经文上产生完全相同的音素;与约 8,900 个 tanween 位置的 mushaf 自身 dabt 完全一致;与 quran-tajweed 规则跨度数据集(60,057 条注释)对比,所有音素正确(仅一处例外为对方标注错误);与 Quranic Arabic Corpus 的形态学交叉检查无分歧。此外,正在进行盲审专家审查,已有独立专家通过筛选并对所有 208 条规则进行裁决。数据集包含多个文件:主文件 quran_phonetics.jsonl(每节经文一行,每个音素完整属性)、训练标签文件 quran_labels_v1.jsonl(长度标记的 tajweed token 和遗留重复字符串编码)、token 序列文件 ayah_tokens.jsonl、规则索引文件 rule_index.jsonl,以及词汇表文件和映射文件。每个音素的 schema 包括:base(音素基名)、kind(辅音/元音等)、geminated(是否重叠)、word_index(词索引)、tafkheem(是否加重)、tafkheem_rank(等级)、qalqalah(类别)、length(长度对象,包含允许范围、规范值和评分集)、rules(产生该音素的规则列表)、sifat(属性对象)。注意:长度值是基于传承的许可范围,并非实测值;规范值仅作为确定性默认值,在自由选择位置不应视为真实值。该数据集适用于自动语音识别(ASR)、文本转语音(TTS)、字素到音素(G2P)转换、tajweed 规则学习与验证、古兰经语音合成等任务。许可协议为 Quran-Lab No-Profit License 1.1,允许任何非商业用途,但要求共享相同许可,且不得从中获利(包括使用该数据集训练的模型)。
The Quran Tajweed Phonetics dataset is a complete phonetic layer dataset of the Quran, built and maintained by Quran Lab, dedicated to the Hafs an Asim transmission system (al-Shatibiyyah route). It contains 522,475 phones from 6,236 ayahs, each annotated with tajweed attributes: madd categories and their allowed length ranges, ghunna levels, qalqalah categories, tafkheem levels and degrees, sakt markers, the 17 attributes (sifat), and the rule numbers that produce each phone. The construction strictly follows classical tajweed literature (e.g., Shatibiyyah and its commentaries, al-Nashr, al-Tayyibah, al-Muqaddimah, Tuhfat al-Atfal, and about 70 other works) with machine-assisted indexing and page verification, ensuring each rule has explicit volume-and-page references. Verification results show: identical phones with two independent mushaf versions (Tanzil, KFGQPC) across all 6,236 ayahs; full consistency with mushafs own dabt on about 8,900 tanween positions; all phones correct when compared with the quran-tajweed rule span dataset (60,057 annotations), with only one exception due to the others annotation error; no discrepancy with the morphological analysis of the Quranic Arabic Corpus. Additionally, a blind expert review is ongoing, with independent experts having screened and adjudicated all 208 rules. The dataset includes multiple files: main file quran_phonetics.jsonl (one line per ayah, full attributes per phone), training label file quran_labels_v1.jsonl (length-marked tajweed tokens and legacy repeated string encoding), token sequence file ayah_tokens.jsonl, rule index file rule_index.jsonl, as well as vocabulary and mapping files. The schema for each phone includes: base (phone base name), kind (consonant/vowel, etc.), geminated (whether doubled), word_index (word index), tafkheem (whether emphasized), tafkheem_rank (degree), qalqalah (category), length (object containing allowed range, canonical value, and score set), rules (list of rules producing the phone), sifat (attribute object). Note: length values are permissible ranges based on transmission, not measured values; canonical values are only deterministic defaults and should not be taken as real values in free-choice positions. The dataset is suitable for automatic speech recognition (ASR), text-to-speech (TTS), grapheme-to-phoneme (G2P) conversion, tajweed rule learning and verification, and Quranic speech synthesis. The license is Quran-Lab No-Profit License 1.1, allowing any non-commercial use but requiring share-alike and prohibiting profit (including from models trained on this dataset).
古兰经 Tajweed 音标数据集(Quran Tajweed Phonetics)
数据集概述
这是一个覆盖《古兰经》完整音位层的数据集,基于哈夫斯安阿西姆(Hafs an Asim) 传述路线(tariq al-Shatibiyyah),包含 6,236 节经文和 522,475 个音位。每个音位均带有完整的 Tajweed 属性标注,包括 Madd 类别及其传述长度范围、Ghunna 等级、Qalqalah 类别、Tafkheem 及其等级、Sakt、十七个发音属性(sifat)以及产生该音位所依据的规则。
该数据集由 Quran Lab 构建和维护,是一个服务于《古兰经》的开源技术项目(waqf)。
构建与验证方法
- 从典籍索引:通过机器辅助阅读约 3,300 页古典文献,索引了所有候选规则,索引仅作为卡片目录,不以任何模型的说法为权威。
- 逐页核验引用:每条规则的引用均对照原书印刷本进行核查,包括书名、卷:页或诗句位置、该位置的主题以及逐字引用的正文,完整审计记录已提交至引擎仓库。
- 门控注册表:引擎源码、规则注册表和审查表必须相互一致,否则测试套件将失败。五个独立预言机、全语料行为审计和种子缺陷演练证明引擎忠实地实现了注册表。
- 盲审圣训链:一位持有 ijazah 的哈菲兹根据其自身师承对全部 208 条注册条目进行裁定,其独立性经过了盲筛测试验证。
- 方法论源自传统本身:即“传述与验证”(الرواية والدراية),与伊本·贾扎里构建《al-Nashr》的方法一致。
典籍依据
所有生成引擎中的规则均直接依据古典文献实现,并附有卷页引用,涉及约七十部著作,包括:
- al-Shatibiyyah 及其注释(فتح الوصيد、إبراز المعاني、سراج القارئ、الوافي)
- 伊本·贾扎里的 al-Nashr、al-Tayyibah 和 al-Muqaddimah
- 达尼的 al-Taysir 和 Jami al-Bayan
- Tuhfat al-Atfal 及后续 Tajweed 大师著作(如 Hidayat al-Qari)
传统传述的所有分歧(如 يبصط、ضعف、سلاسلا、آتاني、waqf raaat 等)均作为明确的、带引用的选择呈现。
验证结果
- 两个独立固定的 Mushaf 版本(Tanzil、KFGQPC)在全部 6,236 节经文中产生完全一致的音位
- 与 Mushaf 自身的 diacritical marks(约 8,900 个 tanween 位置)100% 一致
- 与 quran-tajweed 规则跨度数据集(60,057 条标注)比对:全部音位正确,仅一处例外(17:7)为该跨度文件本身的标注错误
- 所有 wasl 起始词与 Quranic Arabic Corpus 形态学交叉检查,零分歧
- 共 547 项测试、25 个突变体训练演练和冻结的确定性哈希
专家审查状态
一位经委员会考核的哈菲兹(持有 Hafs an Asim 书面 ijazah 和完整古兰经 Tajweed 证书)正在独立裁定引擎注册表中的全部 208 条规则。盲筛测试中植入的三处错误全部被其发现,零误报。审查进度可通过实时 SVG 徽章查看,每一条خطأ 裁定均对照所引古典文本进行公开裁决。
数据文件
| 文件 | 内容 |
|---|---|
quran_phonetics.jsonl |
旗舰文件:每节经文一行,每个音位完全归属 |
quran_labels_v1.jsonl |
训练标签:带长度标注的 Tajweed 标记及传统重复字符串编码 |
ayah_tokens.jsonl |
仅标记序列 |
tokens.txt、vocab_manifest.json |
234 个 Tajweed 词汇表(哈希清单) |
rule_index.jsonl |
每个承载规则的音位:规则 ID、长度集、元数据 |
bijection_old250.json |
到旧版 250 单元词汇表的热启动映射 |
音位模式与重要约定
每个音位对象包含:基础音素(base)、类别(kind,辅音/元音)、是否叠音(geminated)、词索引、Tafkheem 及其等级、Qalqalah 类别、长度信息(含 allowed 合法范围、scoring 已证范围、canonical 确定性默认值)、规则列表及十七个发音属性。
重要约定:长度是集合值规定而非观测值。allowed 为 Shatibiyyah 法律允许范围,scoring 为已验证超集,canonical 为确定性默认值。在传统允许诵读者选择的位置(如 munfasil、aared、leen),实际录音中实现的数值无法由该文本层提供,不应将 canonical 值视为自由选择位置的客观事实。
行数据以节末停顿(ayah-end waqf)进行音位化,句中停顿变体、rawm 和 ishmam 交替形式以及跨节连读标注均可通过引擎生成。
许可协议
采用 Quran-Lab No-Profit License 1.1:允许任何非商业用途免费使用,须保持相同许可共享,禁止从数据集或其衍生品(包括以其训练的模型)获取任何利润。
本数据集陈述的是该传述路线的规定;认证诵读者仍需通过 sanad 体系完成。
致谢
开源 Tajweed 音标先驱项目 quran-transcript 被用作验证的差分基线,全语料字符级一致率达 98.9%。本引擎从古典文献源头独立构建,不共享其代码。