
遇见数据集

energy-mcq-harder-lighteval-rag

收藏
Hugging Face2026-08-16 更新2026-08-17 收录
官方服务:

资源简介:

该数据集由Cemig发布,用于评估能源领域(包括巴西国家电力局ANEEL相关主题)的问答系统,特别是检索增强生成(RAG)管道的性能。包含645个多选题样本,每个问题提供7个选项,属于hard子集,随机猜测的基线准确率为0.1429。语言为葡萄牙语。评估时采用answer_extraction指标,即从模型生成的答案中提取选项字母。该数据集适用于测试模型在能源监管领域复杂多选题上的推理能力。

This dataset, released by Cemig, is used to evaluate question answering systems in the energy domain (including topics related to the Brazilian National Electric Energy Agency - ANEEL), particularly the performance of retrieval-augmented generation (RAG) pipelines. It contains 645 multiple-choice question samples, each with 7 options, belonging to the hard subset, with a random guess baseline accuracy of 0.1429. The language is Portuguese. Evaluation uses the answer_extraction metric, which extracts the option letter from the model-generated answer. This dataset is suitable for testing the reasoning ability of models on complex multiple-choice questions in the energy regulatory domain.

创建时间:
2026-08-16
原始信息汇总

数据集概述

该数据集记录了巴西Cemig公司RAG管线在LightEval基准上的评估结果,数据以葡萄牙语呈现。

核心内容

  • 任务类型: 多选题问答(MCQ),评估RAG管线在能源领域(ANEEL)的知识检索与生成能力
  • 数据来源: RAG管线通过OpenAI兼容端点接受LightEval评估,使用与纯模型相同的runner、任务和指标

实验设计

  • 基线(decoder-only): 无检索增强的模型(energy-gpt-regulatorio-v2)
  • RAG变体(rag-<encoder>[-<reranker>]): 结合检索器与可选的重新排序器(encoder为multilingual-e5-large-ft-v2,未使用reranker)
  • 检索参数: retriever_k=5,查询模式为task,上下文置于问题前

主要结论

实验 准确率
RAG + e5-large-ft-v2 77.83%
无RAG(基线) 38.60%

RAG显著提升了准确率(+39.23个百分点)。

关键参数

  • 模型: cemig-nlp-releases/energy-gpt-regulatorio-v2
  • 编码器: cemig-nlp-releases/multilingual-e5-large-ft-v2
  • 基准数据集: cemig-ceia/benchmark-energy-mcq-harder(子集:hard)
  • 样本数: 645,每个问题7个选项,随机基线准确率0.1429
  • 推理后端: vllm,bfloat16,GPU为DGX-H100-02(SLURM任务30157/30158)
  • 生成大小: 512

指标说明

  • 采用answer_extraction指标,从模型输出中提取带分隔符的字母(如“(D)”)作为答案
  • 注意:exact/prefix匹配指标不适用,因为标注答案为“ D”,而模型生成“(D)”,括号会导致匹配失效

附加信息

  • 结果数据存放在details/目录下的Parquet文件,包含每个样本的完整问题、提示、模型响应及提取结果,便于审计
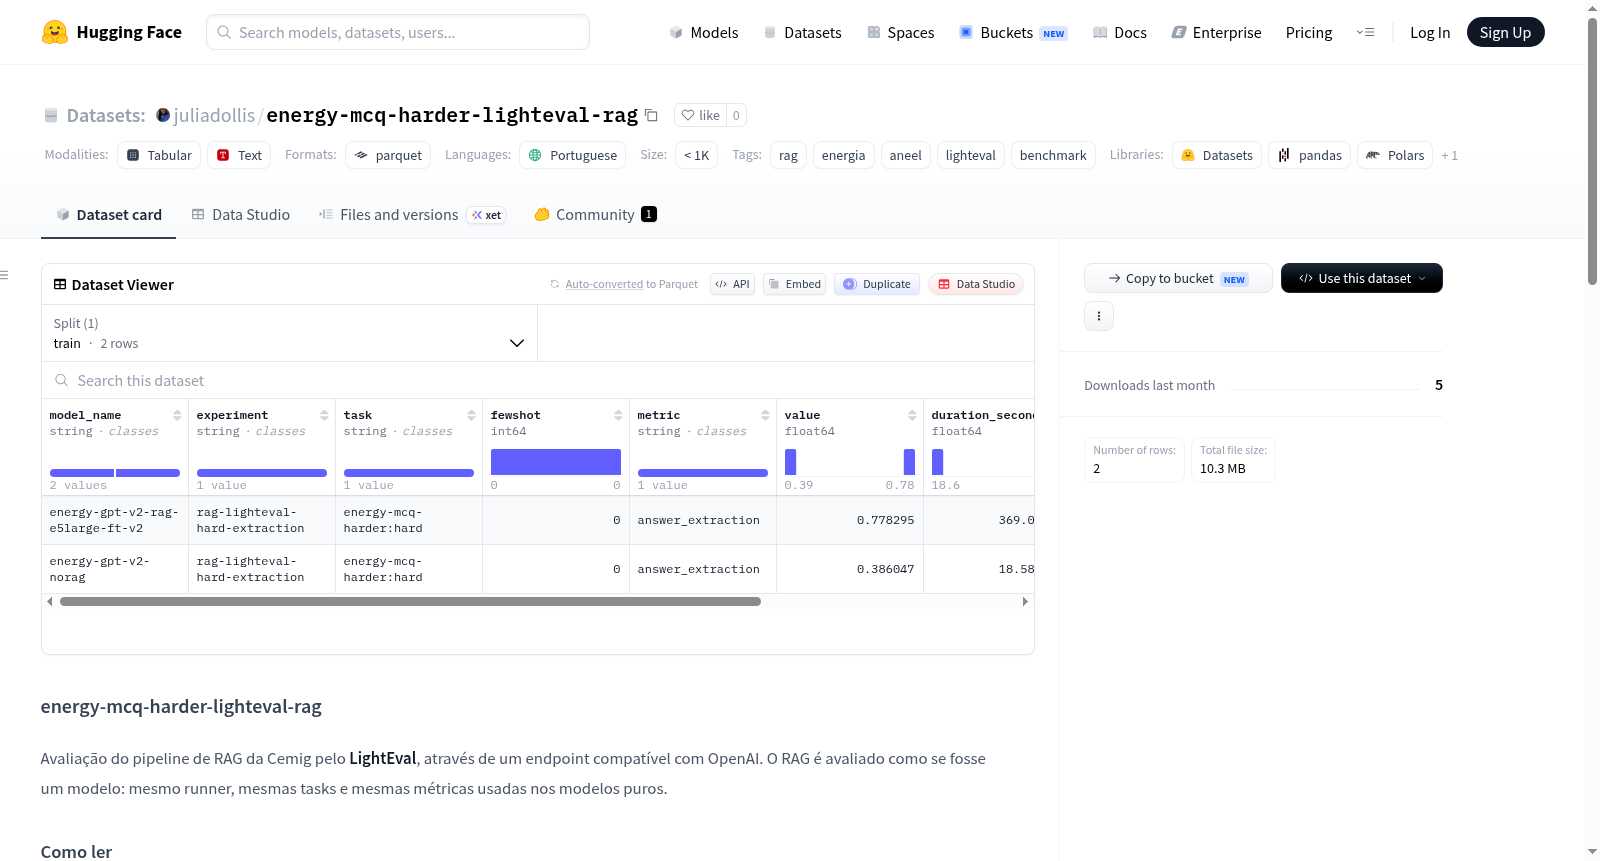
搜集汇总
数据集介绍
energy-mcq-harder-lighteval-rag 数据集图片
构建方式
该数据集源自巴西米纳斯吉拉斯州能源公司(Cemig)对其检索增强生成(RAG)流水线的系统评估,依托LightEval基准测试框架,通过兼容OpenAI的端点,将RAG系统视作独立模型进行评测。构建过程采用固定参数配置:以电力监管领域微调的语言模型作为生成器,多语言E5编码器作为检索器,设定检索数量k=5,并采用任务相关的查询模式与前置上下文的呈现方式。实验基于包含645个样本、7个选项的硬性子集,以答案抽取为评估指标,详细记录了每次实验的提示词、模型响应与提取结果,确保了评测的可复现性与审计性。
特点
该数据集的核心特色在于其直面RAG评估中的匹配挑战,明确指出精确匹配与前缀匹配在存在分隔符(如括号)时可能失真的问题,并推荐使用答案抽取方式以提升评估鲁棒性。数据集包含两种对比实验:未启用检索的基线与启用RAG的配置,后者引入微调重排序器,通过实验数据揭示RAG在电力领域问答中的显著增益(准确性从38.60%跃升至77.83%)。此外,逐样本细节以Parquet格式存储,赋予研究者审计任意特定响应的能力,极大增强了评测的透明度与可信度。
使用方法
使用该数据集时,研究者应优先采用answer_extraction指标解析模型输出,以避免因格式差异导致的误判。可通过查阅details目录下的Parquet文件,检查具体样本的输入提示、模型生成内容与提取结果,进行深度错误分析或案例研究。建议将实验配置(如检索器类型、重排序器、上下文位置等)作为可调参数,复现或扩展对比实验,以探索不同组件对RAG性能的影响。数据集的实验结果可直接用于报告RAG系统在电力能源领域基准上的表现,为优化检索策略与生成模型提供实证依据。
背景与挑战
背景概述
该数据集由巴西Cemig公司于近期创建,依托LightEval评测框架,旨在评估检索增强生成(RAG)管道在能源领域葡萄牙语问答任务中的性能。其核心研究问题在于量化RAG系统相对于纯生成模型的增益,所采用的模型为energy-gpt-regulatorio-v2与检索器multilingual-e5-large-ft-v2,构建于H100 GPU之上。该数据集填补了能源监管领域RAG基准测试的空白,为电力行业智能问答系统的优化提供了可复现的评测基准,对推动领域内检索与生成技术的联合研究具有重要影响力。
当前挑战
该数据集所解决的领域问题在于,能源监管文本问答通常面临知识密集、答案易受法律条文歧义影响的挑战,而传统生成模型易产生幻觉。数据集的构建挑战包括:精心设计含7个选项的645道难题,确保随机准确率仅为14.29%;对RAG与纯模型在同一评测管线下的公平比较,避免检索偏见;以及应对答案格式解析的复杂性,如模型输出带括号导致精确匹配失效的问题,需定制answer_extraction指标。
常用场景
经典使用场景
该数据集源自巴西Cemig能源公司,用于评估基于检索增强生成(RAG)的能源领域问答系统。其经典使用场景是作为基准测试集,全面衡量RAG管道在葡萄牙语能源法规问答上的性能。数据集包含645道高难度多选题,每道题有7个选项,覆盖能源分配、监管法规等专业领域,要求模型不仅具备广泛的知识,还需能精准检索并整合相关法规条文。通过对比有无检索的模型表现,可清晰揭示RAG在专业问答中的增益效果,适用于评测模型在特定垂直领域的知识检索与推理能力。
实际应用
在实际应用中,该数据集主要用于测试和优化能源企业的智能客服与法规查询系统。例如,Cemig公司可利用此基准验证其RAG管道在回答用户关于能源法规、电价政策等咨询时的准确率,从而确保系统能提供可靠、合规的信息。高准确率(77.83%)表明该数据集有助于筛选出高效的检索与生成组合,推动AI在能源行业落地,提高客户服务效率,并降低因信息错误带来的合规风险。
衍生相关工作
该数据集衍生的工作包括基于其评估结果对RAG组件的改良研究,如优化检索编码器、调整上下文注入位置或探索不同重排序策略。此外,其提供的逐样本详细日志(prompt、模型输出)支持了对错误模式的深入分析,催生了关于答案提取鲁棒性(如处理括号格式)的后续研究。该基准也被扩展用于对比不同语言模型(如decoder-only与RAG)的能力,推动了多模态、多领域评估体系的构建,在能源NLP领域具有标杆作用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

