
遇见数据集

overthelex/cz-court-decisions

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

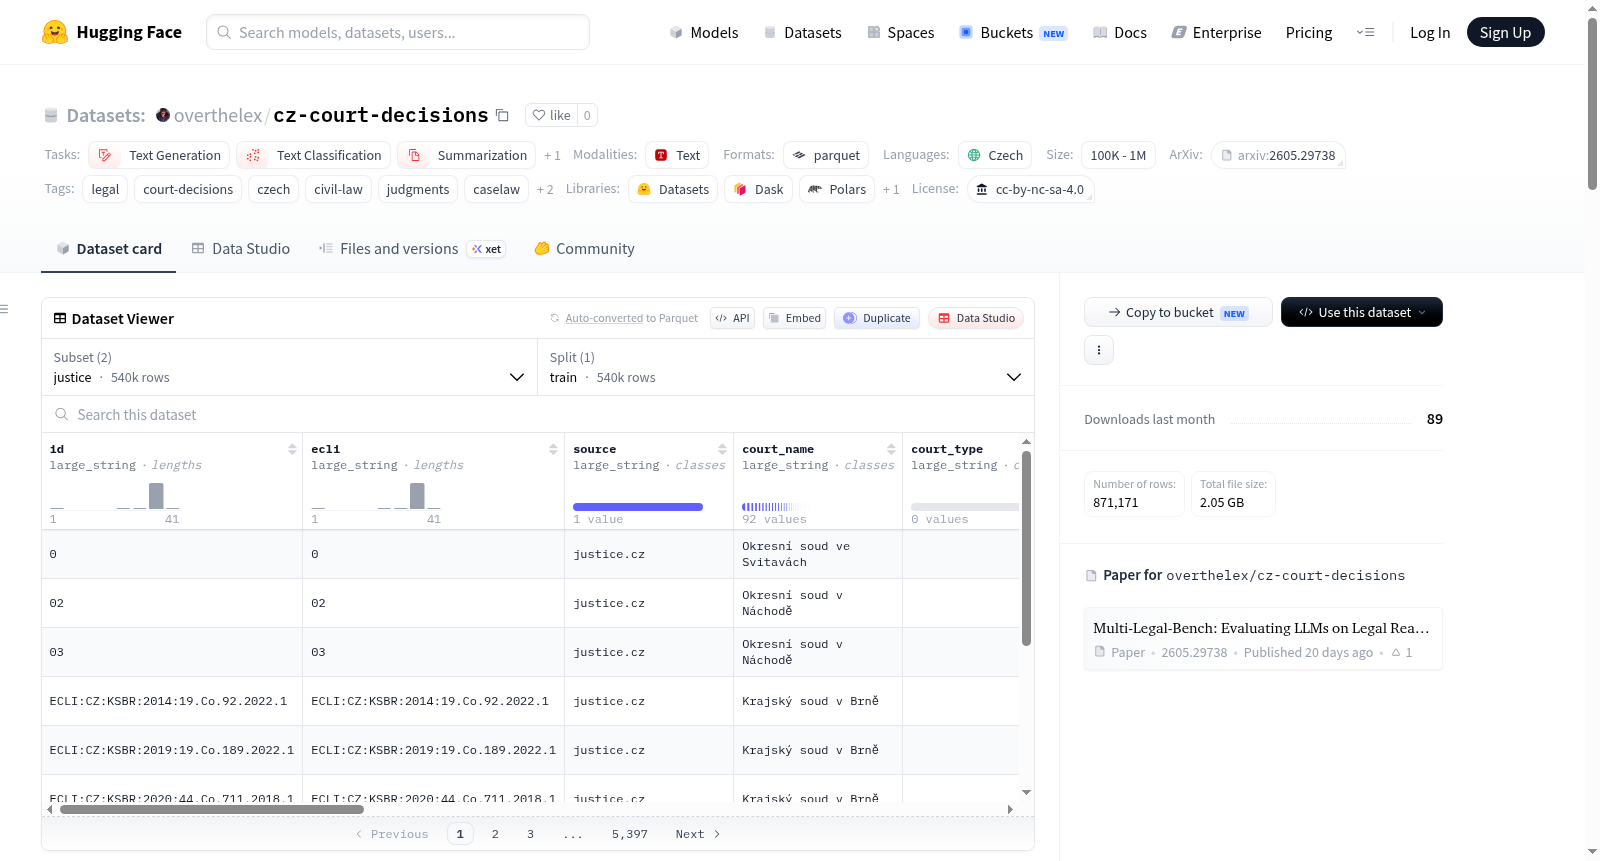
捷克法院判决数据集是最大的捷克法院判决公开数据集,包含871,171个判决全文,涵盖所有法院层级。数据集分为两个配置:justice配置包含539,622个来自地区、区域和高等法院的判决(2020-2026年),许可证为CC BY 4.0(允许商业使用);czcdc配置包含331,549个来自最高法院、最高行政法院和宪法法院的判决(1993-2023年),许可证为CC BY-NC-SA 4.0(非商业使用)。数据集的独特性在于包含了540,000个来自捷克司法部API的低级法院判决,这些数据在其他HuggingFace数据集中不存在。数据模式包括ID、ECLI标识符、来源、法院名称、案件编号、判决类型、判决日期、法官、主题、关键词、引用法律条款和全文等字段。数据质量高,无重复记录。该数据集在相关论文中引入,用于评估LLM在法律推理方面的能力。

The Czech Court Judgments Dataset is the largest publicly available Czech court judgment dataset, containing 871,171 full judgment texts covering all court hierarchies. The dataset is divided into two configurations: 1. The `justice` configuration includes 539,622 judgments from district, regional, and high courts spanning 2020 to 2026, licensed under CC BY 4.0 (permitting commercial use); 2. The `czcdc` configuration includes 331,549 judgments from the Supreme Court, Supreme Administrative Court, and Constitutional Court spanning 1993 to 2023, licensed under CC BY-NC-SA 4.0 (for non-commercial use only). A distinct feature of this dataset is the inclusion of 540,000 lower court judgments sourced from the Czech Ministry of Justice API, which are not present in other Hugging Face datasets. The data schema includes fields such as ID, ECLI identifier, source, court name, case number, judgment type, judgment date, judges, subject matter, keywords, cited legal provisions, and full text. The dataset has high data quality with no duplicate records. This dataset was introduced in a relevant academic paper for evaluating the legal reasoning capabilities of Large Language Models (LLMs).
提供机构:
overthelex
搜集汇总
数据集介绍
overthelex/cz-court-decisions 数据集图片
构建方式
捷克法院判决数据集(cz-court-decisions)是当前规模最大的捷克司法裁决开放语料库,涵盖全国各级法院共计871,171份判决全文。其构建依托两大核心来源:其一是通过捷克司法部公开API(rozhodnuti.justice.cz)爬取的下级法院(地区、区域及高等法院)在2020至2026年间发布的539,622份判决,适用CC BY 4.0许可协议;其二是整合了既有CzCDC 1.0语料库(涵盖最高法院、最高行政法院及宪法法院1993–2018年的237,723份判决)与Paulik/Zenodo补充的宪法法院后续数据(1993–2023年间的93,826份判决),共同构成包含331,549份经典法院判决的子集,适用CC BY-NC-SA 4.0许可。
使用方法
用户可通过HuggingFace的`datasets`库便捷加载该数据集。加载`justice`配置(默认)只需调用`load_dataset("overthelex/cz-court-decisions", "justice", split="train")`,即可获取下级法院判决;加载`czcdc`配置则使用`load_dataset("overthelex/cz-court-decisions", "czcdc", split="train")`,获取最高层级法院判决。数据集支持文本生成、文本分类、摘要与特征提取等多种自然语言处理任务,研究者可根据具体任务需求选择合适的配置与字段,尤其适用于多语言法律推理评估等前沿课题。
背景与挑战
背景概述
随着自然语言处理技术在法律领域的深入应用,构建高质量、大规模的司法裁决数据集成为推动法律智能发展的关键基石。Czech Court Decisions数据集于2026年由Volodymyr Ovcharov等人创建,依托捷克司法部API及多个学术源整合而成,收录了涵盖捷克各级法院(从地方法院到宪法法院)共计871,171份判决全文,是当前规模最大的捷克法院判决开放数据集。该数据集的核心研究问题在于填补低层级法院判决在公开资源中的巨大空缺,为法律文本生成、分类、摘要及特征提取提供丰富语料,其论文发表于arXiv(2605.29738),在跨法域法律推理评估领域具有重要影响力。
当前挑战
该数据集所解决的领域问题核心挑战在于:现有法律公开数据多集中于最高法院等高层级机构,而占司法实践绝大多数的地方及区域法院判决极度匮乏,导致法律NLP模型难以全面反映真实法律推理的复杂性与多样性。在构建过程中,面对的最大挑战是异构数据源的整合与统一,包括来自不同API格式、时间跨度(1993-2026)及法院层级的结构化元数据与自由文本的融合,同时要确保872K规模数据中的零重复率,并妥善处理不同来源(CC BY 4.0与CC BY-NC-SA 4.0)的许可证合规性问题,以及宪法法院数据的时间段分割与衔接。
常用场景
经典使用场景
在自然语言处理与法律人工智能的交叉领域中,捷克法院判决数据集(cz-court-decisions)作为迄今规模最大的捷克语司法文本公开资源,为法律文本理解与生成任务提供了坚实基础。研究者常利用其完整判决文本进行法律判决预测、案件要素抽取及法律语言模型预训练,涵盖从地方法院到宪法法院的多层级司法决策体系。该数据集收录超过87万份判决,其中约54万份来自下级法院的独家数据填补了现有资源空白,尤其适用于需要跨法院层级对比分析的司法一致性研究。
解决学术问题
该数据集有效解决了捷克法律NLP研究中长期存在的下级法院数据缺失问题,为评估大语言模型在民法体系下的法律推理能力提供了大规模、多层级、多时期的基准语料。基于该数据集的学术工作已推动法律判决摘要生成、法律条文引用关系抽取和司法观点演变分析等前沿课题的进展。其引入的Multi-Legal-Bench评估框架更首次实现了跨语言、跨法系的法律推理能力标准化测评,对验证生成式模型在法律领域的适用性边界具有重要方法论价值。
实际应用
在实际应用层面,该数据集支撑了捷克司法系统的智能化升级,包括辅助法官进行相似案例检索、自动化判决草案生成以及法律文书质量一致性检查。商业法律科技公司可基于CC BY 4.0授权的下级法院数据开发合规审查工具,而学术机构则利用非商业授权的最高法院数据开展判例法实证研究。数据集中包含的标准化ECLI标识符、案件编号及引用条款字段,使得构建跨境判决关联网络成为可能,服务于欧盟法律协调化进程。
数据集最近研究
最新研究方向
捷克司法判决数据集(cz-court-decisions)以其超过87万份完整判决文本的庞大规模,成为法律自然语言处理领域的前沿基石。该数据集首次整合了捷克各级法院的判决,特别是来自司法部API的逾54万份下级法院文书,填补了此前公开数据集的空白。结合近期多语言法律推理基准(Multi-Legal-Bench)的研究,该数据集被用于评估大型语言模型在跨法域、跨语言和跨法律传统上的推理能力,推动了法律人工智能从粗粒度分类向细粒度逻辑推演的进化。其双授权模式(CC BY 4.0与CC BY-NC-SA 4.0)兼顾了商业应用与学术研究的合规需求,为欧洲大陆法系司法透明化与智能辅助裁判系统的研究提供了不可替代的语料支柱。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

