
dpdl-benchmark/colorectal_histology
收藏官方服务:
资源简介:
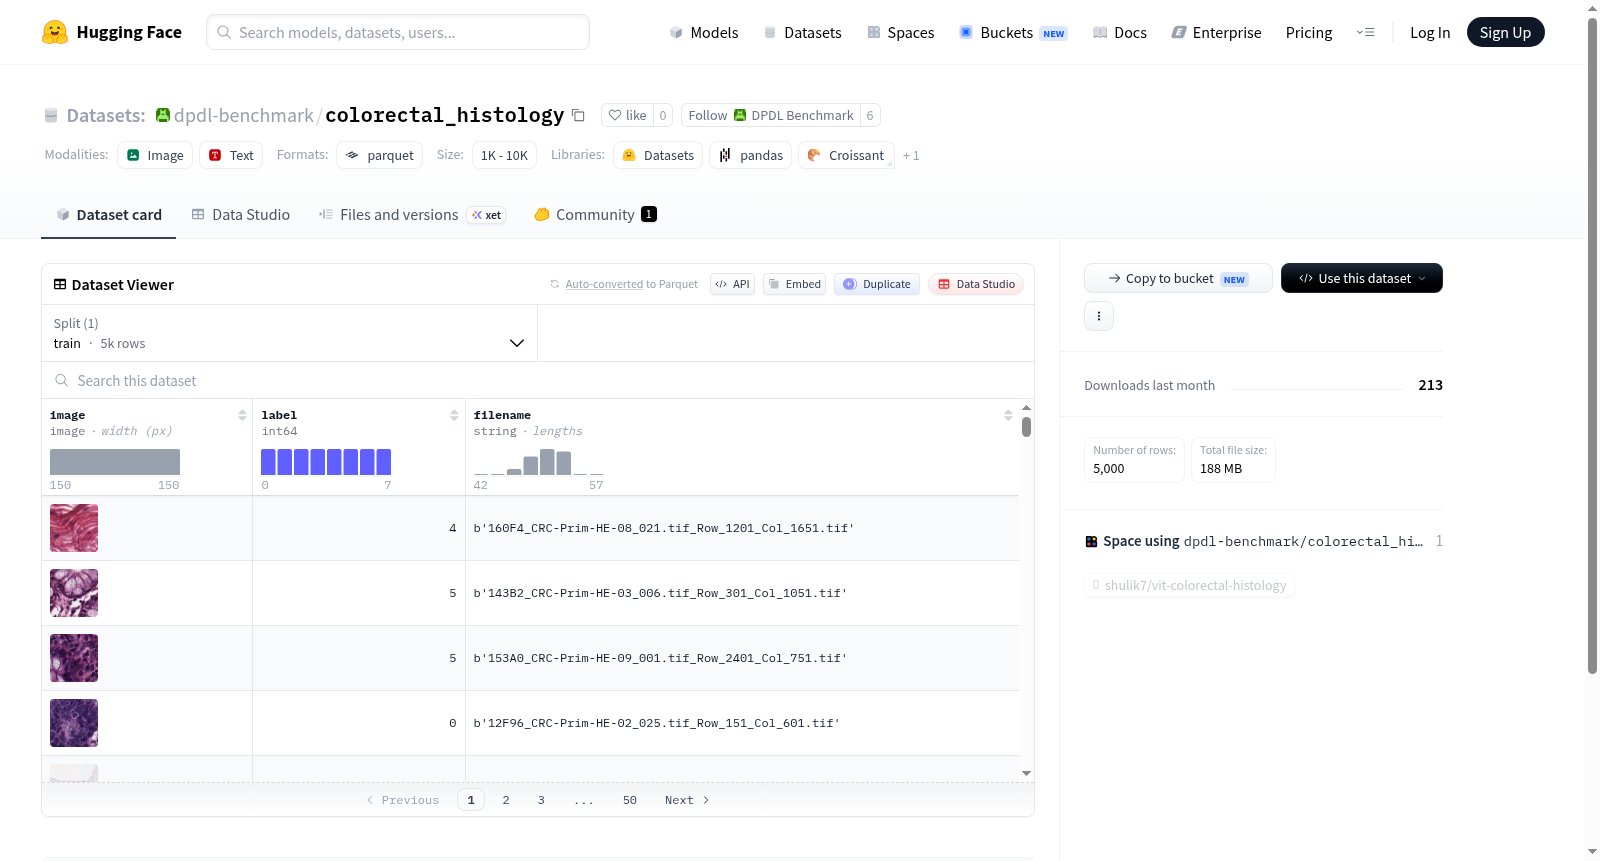
--- dataset_info: features: - name: image dtype: image - name: label dtype: int64 - name: filename dtype: string splits: - name: train num_bytes: 187810055.0 num_examples: 5000 download_size: 187678009 dataset_size: 187810055.0 configs: - config_name: default data_files: - split: train path: data/train-* ---
数据集信息: ## 特征 1. 图像(image):数据类型为图像 2. 标签(label):数据类型为64位整数(int64) 3. 文件名(filename):数据类型为字符串(string) ## 数据集拆分 - 拆分名称:训练集(train),占用字节数:187810055.0,样本数量:5000 ## 统计信息 下载大小:187678009,数据集总大小:187810055.0 ## 配置项 - 配置名称:默认配置(default),数据文件配置: - 对应拆分:训练集(train),数据路径:data/train-*
提供机构:
dpdl-benchmark原始信息汇总
数据集概述
数据集特征
- image:图像数据,数据类型为图像。
- label:标签数据,数据类型为整数(int64)。
- filename:文件名,数据类型为字符串。
数据集划分
- train:训练集,包含5000个样本,总大小为187810055字节。
数据集大小
- 下载大小:187678009字节。
- 数据集总大小:187810055字节。
配置信息
- config_name:default
- data_files:
- split:train
- path:data/train-*
搜集汇总
数据集介绍
构建方式
结直肠组织病理学数据集(dpdl-benchmark/colorectal_histology)的构建基于临床结直肠组织切片的高分辨率显微图像采集。每张图像均经过专业病理学家的精确标注,赋予其对应的组织学类别标签。数据集共包含5000个训练样本,每个样本由图像、整数型标签及原始文件名三要素构成,并以标准化的图像格式存储,确保了数据的一致性与可复现性。
使用方法
使用该数据集时,可通过Hugging Face Datasets库直接加载,指定配置名为'default',并自动读取训练拆分中的所有数据。加载后的数据集对象包含'image'、'label'和'filename'三个字段,其中'image'为PIL图像对象,可直接输入至深度学习框架(如PyTorch或TensorFlow)进行模型训练。用户亦可依据实际需求,对数据集进行随机划分,生成验证与测试子集,以完成完整的模型开发与性能评估流程。
背景与挑战
背景概述
结直肠癌作为全球范围内发病率和死亡率均位居前列的恶性肿瘤,其早期诊断与精准治疗高度依赖病理组织学的准确判读。近年来,深度学习技术在医学图像分析领域展现出巨大潜力,然而高质量、标准化且规模适中的病理图像数据集仍是推动该领域发展的关键瓶颈。dpdl-benchmark/colorectal_histology数据集正是在此背景下应运而生,由相关研究机构于近年创建,旨在为结直肠组织病理图像的分类任务提供基准测试平台。该数据集包含5000张标注清晰的结直肠组织学图像,涵盖多种组织学亚型,其核心研究问题聚焦于如何利用深度神经网络模型自动区分正常与癌变组织,并实现细粒度分类。自发布以来,该数据集已成为评估结直肠病理图像分析算法性能的重要基准,对推动计算病理学从实验研究向临床辅助诊断转化具有显著影响力。
当前挑战
该数据集所解决的领域问题主要集中于结直肠组织病理图像的自动分类,其核心挑战在于病理图像固有的复杂性:组织形态学异质性高、染色差异大、细胞密度不均以及背景噪声干扰等因素均严重影响模型判别能力。此外,不同组织学亚型之间边界模糊,部分类别样本数量不均衡,进一步加剧了分类难度。在数据集构建过程中,研究者面临多重挑战:首先,病理图像的标注需要资深病理学家逐张审核,耗时且主观性强,标注一致性难以保证;其次,图像采集过程中不同扫描仪和染色协议引入的颜色与纹理变异,需通过标准化预处理流程加以缓解;最后,数据集的规模相对有限,仅含5000张训练样本,难以充分覆盖临床实践中出现的罕见病变模式,可能限制模型泛化能力与鲁棒性。
常用场景
经典使用场景
在计算病理学领域,组织病理学图像的自动分类是一项基础而关键的任务。dpdl-benchmark/colorectal_histology数据集专为结直肠组织学图像的分类而设计,包含5000张标注了不同组织类型的图像样本。该数据集的经典使用场景在于训练深度学习模型,以区分结直肠组织中的多种组织学结构,如腺体、间质、平滑肌等。研究者常将其作为基准数据集,用于评估卷积神经网络(CNN)或视觉Transformer在组织病理图像分类上的性能,从而推动医学图像分析算法的发展。
解决学术问题
该数据集主要解决了结直肠癌病理诊断中组织学亚型自动识别的学术难题。传统上,病理学家依赖显微镜下的人工阅片进行诊断,过程耗时且易受主观因素影响。通过提供标准化、多类别的组织学图像,该数据集为开发高精度自动分类模型提供了基础,有助于减少诊断中的观察者间变异。其意义在于推动了计算病理学从定性分析向定量分析的转变,为后续的弱监督学习、迁移学习及多模态融合研究奠定了数据支撑,显著提升了病理图像分析的客观性与可重复性。
实际应用
在临床实践中,基于该数据集训练的模型可被集成到数字病理辅助诊断系统中,帮助病理学家快速筛查结直肠组织切片,自动标注可疑区域。例如,在结直肠癌的术前活检或术后病理评估中,模型能实时区分正常腺体与癌变组织,提高诊断效率。此外,该数据集的实际应用还延伸至医学教育领域,用于训练医学生识别不同组织学形态。在药物研发中,它也可用于评估药物对结直肠组织结构的影响,加速病理学相关的药物筛选流程。
数据集最近研究
最新研究方向
在结直肠组织病理学领域,dpdl-benchmark/colorectal_histology数据集正成为推动深度学习模型在医学图像分析中应用的关键资源。该数据集包含5000张标注的组织病理学图像,覆盖多种结直肠组织类别,为肿瘤微环境解析和自动化诊断系统的开发提供了标准化基准。当前前沿研究方向聚焦于利用该数据集训练高精度卷积神经网络与Transformer架构,以区分良恶性病变、预测分子亚型,并与临床预后指标关联。结合全球结直肠癌高发病率的现实,该数据集在提升早期筛查效率、减少病理医生工作负荷方面具有显著影响,其开放性和可复现性也促进了跨机构协作与算法公平性评估。
以上内容由遇见数据集搜集并总结生成


