
遇见数据集

terminal_bench_2_a3_rl_laion_exp_rpt_ghactions_v3_20_8B_20260829_084542

收藏
Hugging Face2026-08-30 更新2026-08-31 收录
官方服务:

资源简介:

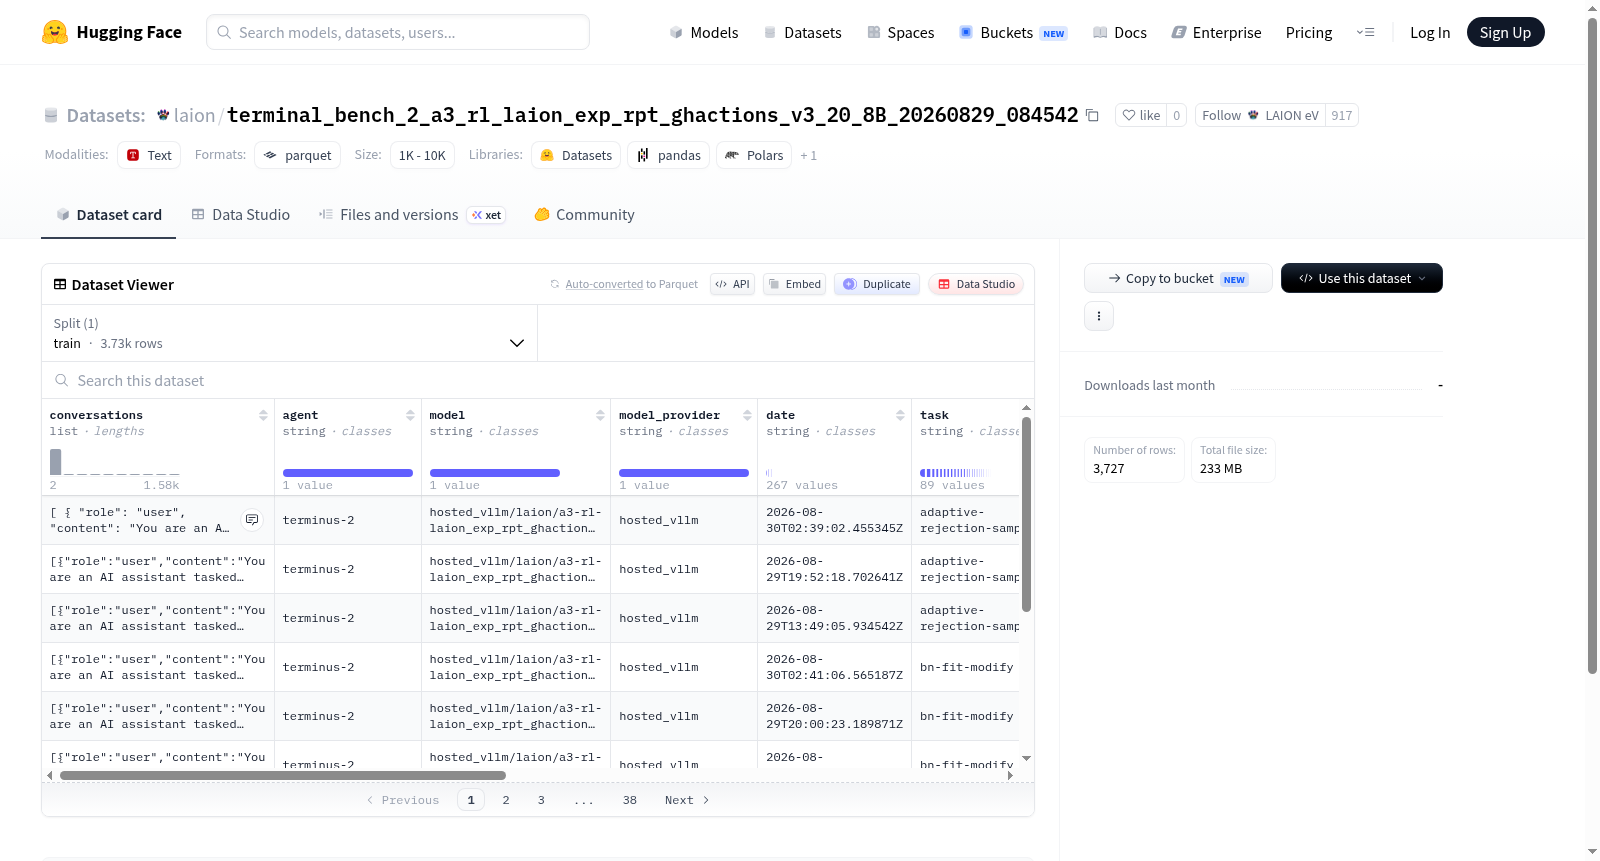
该数据集包含多轮对话交互记录,每条数据包括一个完整的对话序列(conversations),其中每轮对话包含角色(role)和内容(content)。此外,还记录了参与对话的智能体(agent)、使用的模型(model)和模型提供商(model_provider)、日期(date)、任务(task)、回合(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及跟踪来源(trace_source)。数据集共包含3727个训练样本,总大小约288MB。该数据集适用于对话系统评估、多智能体交互分析、模型行为追踪等任务。

The dataset contains multi-turn dialogue interaction records, each data including a complete conversation sequence (conversations) with role and content for each turn. Additionally, it records the agent, model, model provider, date, task, episode, run ID, trial name, result, verifier output, and trace source. The dataset has 3,727 training samples with a total size of approximately 288MB. It is suitable for tasks such as dialogue system evaluation, multi-agent interaction analysis, and model behavior tracking.

提供机构:
LAION eV
创建时间:
2026-08-30
原始信息汇总

数据集概述

该数据集名为 laion/terminal_bench_2_a3_rl_laion_exp_rpt_ghactions_v3_20_8B_20260829_084542,托管于 Hugging Face。

数据规模

  • 总大小:约 288.34 MB(下载大小约 233.20 MB)
  • 样本数量:3,727 条(训练集)

数据特征

每个样本包含以下字段:

字段名 类型 说明
conversations 列表(含 rolecontent 字符串) 对话记录,包含角色与内容
agent 字符串 智能体标识
model 字符串 使用的模型
model_provider 字符串 模型提供商
date 字符串 日期
task 字符串 任务名称
episode 字符串 回合编号
run_id 字符串 运行 ID
trial_name 字符串 试验名称
result 字符串 结果
verifier_output 字符串 验证器输出
trace_source 字符串 追踪来源

数据划分

  • 该数据集仅包含一个划分:train,包含全部 3,727 条样本。

数据内容特点

  • 数据涉及终端环境下的基准测试任务(terminal_bench),可能包含强化学习(RL)相关的实验数据。
  • 文件名中提及 20_8B,暗示可能涉及 80 亿参数规模的模型实验。
  • 包含对话记录、智能体行为、任务执行结果等结构化信息,适用于分析智能体在终端任务中的表现。
搜集汇总
数据集介绍
terminal_bench_2_a3_rl_laion_exp_rpt_ghactions_v3_20_8B_20260829_084542 数据集图片
构建方式
该数据集源自终端基准测试任务,通过强化学习与语言模型交互过程采集构建。数据收集依托GitHub Actions等自动化执行环境,在真实终端操作场景中记录智能体与环境的完整对话轨迹。每条样本涵盖角色交替的对话序列、执行代理信息、模型标识及提供商、任务描述、运行批次标识等结构化元数据,并附有任务结果与验证器输出,确保数据可追溯性与实验可复现性。数据分割为训练集,包含3727条样本,总数据量约288MB。
特点
数据集以多维度结构化特征为核心,涵盖对话内容、代理环境、模型来源及任务属性等字段。其独特之处在于融合了执行轨迹与结果验证信息,每一轮交互均与具体任务和运行上下文绑定,形成层级分明的实验记录。训练集规模适中,适合用于微调终端操作类语言模型,且数据字段设计兼顾了运行标识、试验名称等细粒度追踪维度,便于进行消融实验与性能归因分析。
使用方法
使用时可将数据集加载为HuggingFace Dataset对象,按'conversations'字段提取多轮对话作为指令微调语料,结合'agent'、'model'等元数据字段进行条件过滤或分组分析。'result'与'verifier_output'字段可用于构建偏好对或作为奖励模型训练的监督信号。该数据集适用于终端交互智能体的行为克隆、策略优化及评估基准构建,研究者可按需重构样本格式以适配不同的训练框架。
背景与挑战
背景概述
该数据集名为 terminal_bench_2_a3_rl_laion_exp_rpt_ghactions_v3_20_8B_20260829_084542,由LAION机构于2026年8月29日创建,旨在评估和训练8B参数规模的语言模型在终端交互任务中的智能体能力。作为Terminal-Bench系列的第二代,该数据集聚焦于基于GitHub Actions的重复性真实终端操作,涵盖任务执行、结果验证及轨迹追踪,为强化学习(RL)提供多轮对话式的训练样本,其核心研究问题在于提升模型在复杂命令行环境中的自主决策与操作能力。该数据集对智能体领域具有开创性影响,为后续研究提供了标准化基准,尤其在自动化运维、软件开发和系统管理等领域展现了广泛应用前景。
当前挑战
该数据集面临的挑战集中于两大维度。领域问题上,终端操作任务要求模型具备长期上下文理解、多步规划及错误恢复能力,远超常规对话系统,需应对动态命令反馈与工具调用不确定性,其核心难点在于实现跨任务泛化,避免在特定环境上的过拟合。构建过程中,数据采集面临真实终端操作的复杂性与高成本,需借助GitHub Actions自动化工具持续收集多轮对话,并确保数据多样性、平衡性和质量;同时,对3727个样本进行人工或半自动标注,涉及结果准确性与一致性验证,且需解决数据偏差与隐私问题。此外,数据集规模相对较小,可能限制模型训练效果,需要后续扩充或与其他数据集协同使用,以提升鲁棒性。
常用场景
经典使用场景
该数据集聚焦于终端交互环境中智能体的行为轨迹与结果记录,其核心场景在于训练和评估基于大语言模型的自主代理系统。通过轨迹数据,研究者可构建监督式微调或强化学习的训练样本,使模型学会在真实命令行环境中执行任务、调用工具并完成复杂指令。此类数据对于提升模型在终端操作层面的鲁棒性和泛化能力具有重要意义,尤其适用于开发能够自主完成软件部署、系统维护及DevOps流程的智能体。
解决学术问题
该数据集有效弥补了终端任务领域高质量交互数据匮乏的现状,为研究提供了可复现的基准。它解决了智能体在长尾命令解析、多步推理及错误恢复等学术难题中训练数据不足的问题,促进了环境交互学习、策略优化及行为克隆等方向的理论发展。其细致的轨迹标注(如运行标识、验证器输出)为评估智能体的决策过程提供了量化依据,推动了终端智能体测评体系的规范化。
衍生相关工作
围绕该数据集,衍生出多项开拓性工作,包括开发更具实效的终端交互训练框架、设计基于结果反馈的奖励模型以及探索多轮对话中的策略优化算法。研究学者已基于此类数据发布多篇关于智能体轨迹压缩、工具调用规划及跨环境迁移学习的论文。此外,该数据集中验证器输出与任务结果字段的设计理念也启发了后续研究对代理任务完成质量进行自动化评估的方法论创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

