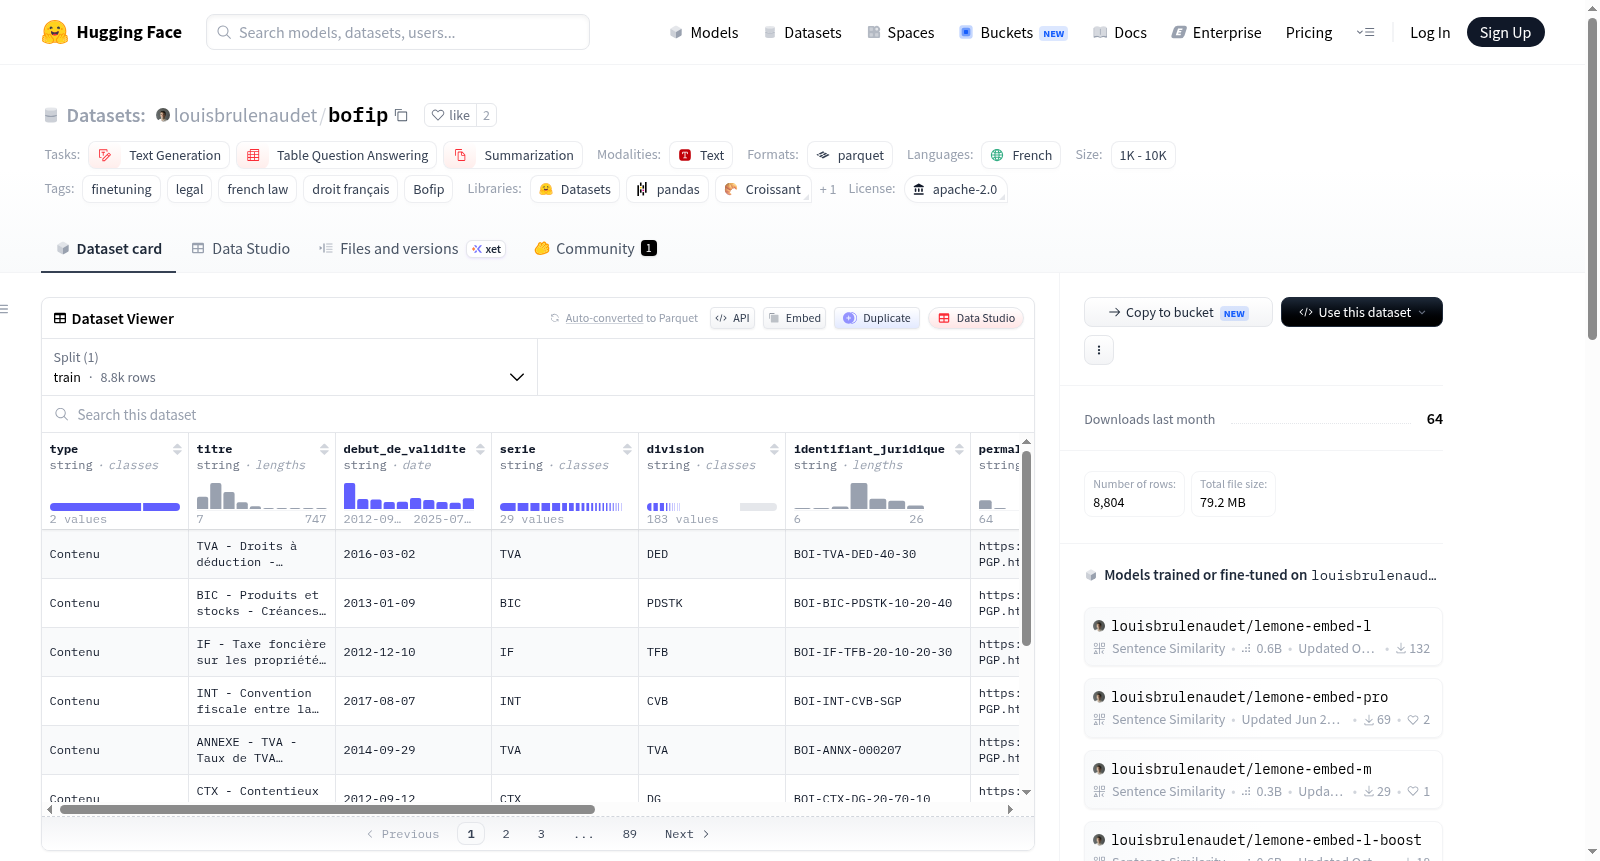
louisbrulenaudet/bofip
收藏资源简介:
该项目专注于微调预训练语言模型,以创建适用于法律实践的高效准确模型。微调是通过进一步训练模型参数,使其适应特定任务或领域的过程。数据集生成过程涉及使用一系列指令来生成JSON文件,每个字典包含instruction、input和output字段。数据集的语言为法语,标签包括finetuning、legal、french law等。
该项目专注于微调预训练语言模型,以创建适用于法律实践的高效准确模型。微调是通过进一步训练模型参数,使其适应特定任务或领域的过程。数据集生成过程涉及使用一系列指令来生成JSON文件,每个字典包含instruction、input和output字段。数据集的语言为法语,标签包括finetuning、legal、french law等。
数据集概述
基本信息
- 许可证: Apache-2.0
- 语言: 法语
- 多语言性: 单语种
- 标签: 微调, 法律, 法国法律, 法国税法, Bofip
- 数据来源: 原始数据
- 数据集名称: Bulletin officiel des finances publiques - impôts
- 任务类别: 文本生成, 表格问答, 摘要, 对话
- 数据规模: 1K<n<10K
数据集生成
-
数据格式: JSON文件,包含多个字典
-
字段:
instruction: 字符串,表示与元素相关的指令input: 字符串,表示元素的输入细节output: 字符串,表示元素的输出信息
-
指令列表: python instructions = [ "Compose lintégralité de la publication sous forme écrite.", "Écris la totalité du contenu de la publication.", "Formule la totalité du texte présent dans la publication.", "Produis lintégralité de la publication en écriture.", "Développe la publication dans son ensemble par écrit.", "Génère lensemble du texte contenu dans la publication.", "Formule le contenu intégral de la publication en entier.", "Rédige la totalité du texte de la publication en entier.", "Compose lintégralité du contenu textuel de la publication.", "Rédige lensemble du texte qui constitue la publication.", "Composez lintégralité de la publication sous forme écrite.", "Écrivez la totalité du contenu de la publication.", "Formulez la totalité du texte présent dans la publication.", "Développez la publication dans son ensemble par écrit.", "Générez lensemble du texte contenu dans la publication.", "Formulez le contenu intégral de la publication en entier.", "Rédigez la totalité du texte de la publication en entier.", "Composez lintégralité du contenu textuel de la publication.", "Écrivez la publication dans son intégralité en termes de texte.", "Rédigez lensemble du texte qui constitue la publication.", "Composer lintégralité de la publication sous forme écrite.", "Écrire la totalité du contenu de la publication.", "Formuler la totalité du texte présent dans la publication.", "Produire lintégralité de la publication en écriture.", "Développer la publication dans son ensemble par écrit.", "Générer lensemble du texte contenu dans la publication.", "Formuler le contenu intégral de la publication en entier.", "Rédiger la totalité du texte de la publication en entier.", "Composer lintégralité du contenu textuel de la publication.", "Rédiger lensemble du texte qui constitue la publication.", "Quelles sont les dispositions de la publication ?", "Quelles dispositions sont incluses dans la publication ?", "Quelles sont les dispositions énoncées dans la publication ?", "Quel est le texte intégral de la publication ?", "Quelle est la lettre de la publication ?" ]