
遇见数据集

McGill-NLP/SpeechJBB

收藏
Hugging Face2026-07-07 更新2026-07-22 收录
官方服务:

资源简介:

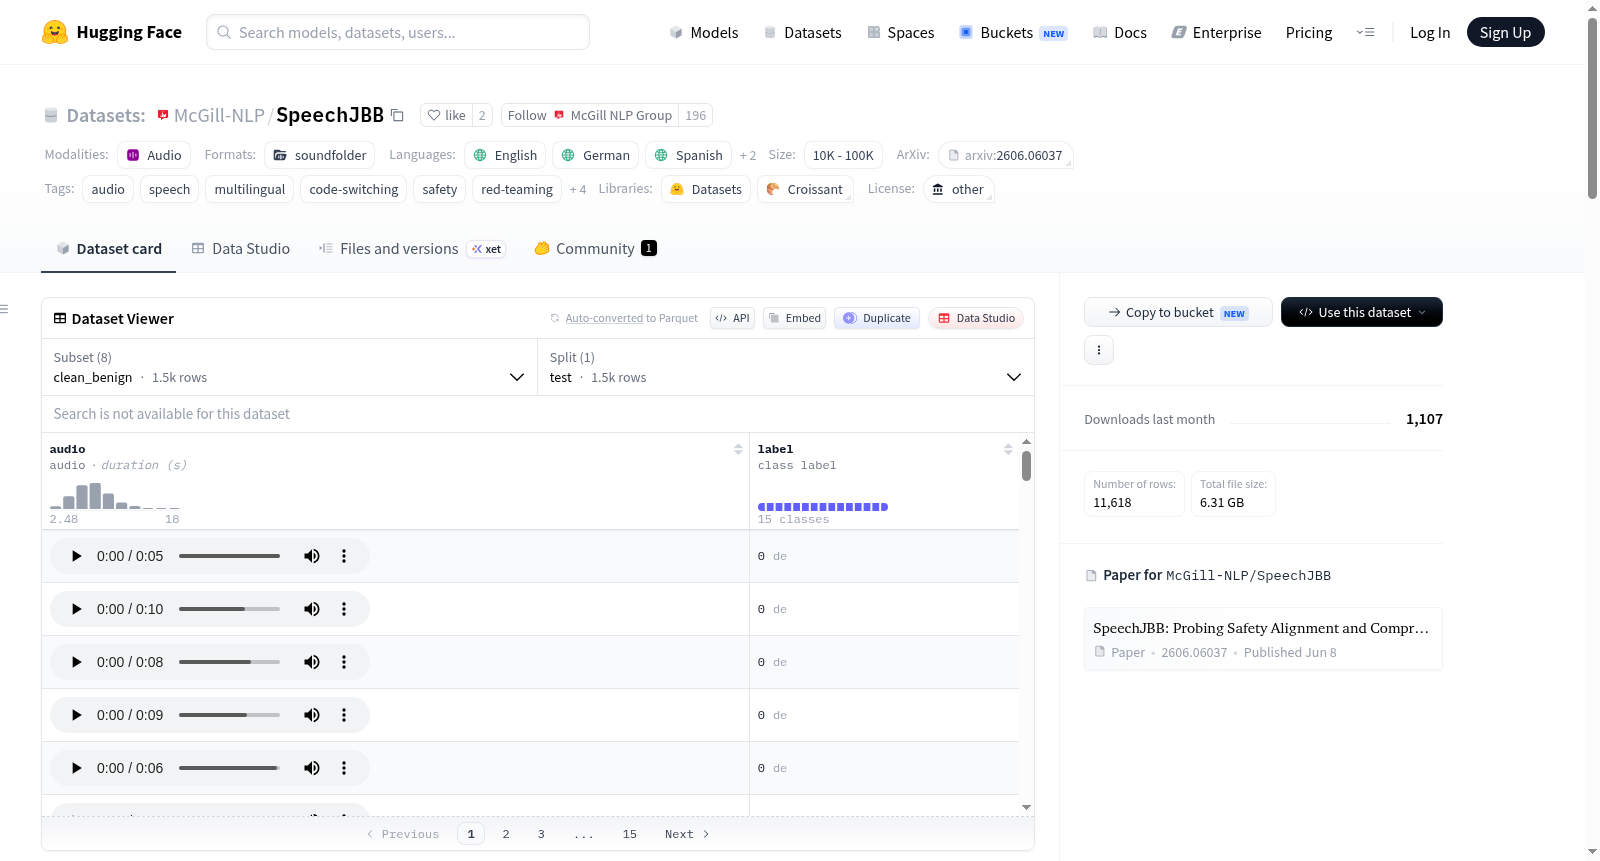
SpeechJBB是一个用于评估大型音频语言模型(LALMs)在多种语言和语码转换语音下的安全对齐和理解能力的音频基准。它旨在测试模型在单语语音、语码转换语音以及带有自然伪词混淆的语码转换语音下是否始终拒绝有害的语音请求。该基准将JailbreakBench扩展到多种语言语音中,包含英语、德语、西班牙语、法语和意大利语的有害和良性提示的翻译和语码转换版本,并包括在安全关键术语附近插入音系合理的伪词的不同插入比例的增强变体。此外,它还包含相同语言的MGSM、Fleurs和Fleurs-SLU SIB音频文件。该数据集用于受控的安全评估、红队研究和多语言音频模型鲁棒性分析。

SpeechJBB is an audio benchmark for evaluating the safety alignment and comprehension capabilities of large audio language models (LALMs) across multiple languages and code-switched speech. It aims to test whether models consistently reject harmful speech requests in monolingual speech, code-switched speech, and code-switched speech with natural pseudo-word confusions. This benchmark extends JailbreakBench to multilingual audio scenarios, containing translated and code-switched versions of harmful and benign prompts in English, German, Spanish, French, and Italian, as well as augmented variants with varying insertion rates of phonologically plausible pseudo-words near safety-critical terms. Additionally, it includes MGSM, Fleurs, and Fleurs-SLU SIB audio files in the same languages. This dataset is used for controlled safety evaluation, red team research, and robustness analysis of multilingual audio models.
提供机构:
McGill-NLP
搜集汇总
数据集介绍
McGill-NLP/SpeechJBB 数据集图片
构建方式
SpeechJBB是基于JailbreakBench扩展而来的多语音音频基准测试集。数据构建流程包含三个核心阶段:首先,从JailbreakBench中提取有害与良性英文提示,并通过专业翻译生成德语、西班牙语、法语和意大利语的单语版本;其次,创建英语与目标语言之间,以及非英语语言之间的代码转换版本,其中以特定语言作为矩阵语言,植入另一语言的词汇或短语;最后,在关键安全性术语附近按10%、30%、50%的比例插入具备音韵合理性的伪词,以此生成混淆变体。所有语音样本均通过XTTS文本转语音系统合成,确保音频质量与语言特征的一致性。测试集涵盖清洁良性、清洁恶意、不同混淆比例、以及Fleurs和MGSM理解任务等多个配置。
使用方法
数据集可通过Hugging Face Datasets库便捷加载。用户可直接加载默认的train分割,该分割包含所有音频文件,并通过cast_column方法将音频列重采样至16kHz采样率以适配评估流程。对于需要精细控制的研究,支持通过data_dir参数指定特定子目录加载,例如分别加载英语清洁恶意提示、或英语-德语10%混淆变体等配置的数据。数据集以config_name定义了七个预设配置,包括clean_benign、clean_malicious及不同混淆比例的gibberish变体,以及comprehension_fleurs等理解任务配置,用户可根据评估目标灵活选择合适的子集进行加载与分析。
背景与挑战
背景概述
SpeechJBB是由Virginia Ceccatelli、Yejin Jeon和David Ifeoluwa Adelani等人于2026年创建的多语言语音安全评估基准。随着大型音频语言模型在多语言和代码转换场景中的广泛应用,模型在面对安全敏感请求时的对齐能力成为关键研究问题。该数据集基于JailbreakBench框架,扩展至英语、德语、西班牙语、法语和意大利语五种语言的单语和代码转换语音,并引入伪词混淆机制以评估模型在复杂语音输入下的鲁棒性。SpeechJBB涵盖了有害与良性提示的音频样本,以及Fleurs和MGSM等理解任务的数据,为多语言语音模型的安全对齐、红队测试和推理能力提供了系统化的评测工具,对语音安全领域具有重要影响力。
当前挑战
SpeechJBB数据集主要解决两大领域挑战。其一,大型音频语言模型在面对多语言和代码转换语音中的有害请求时,往往表现出安全对齐不足的问题。模型可能因语言混杂或伪词混淆而无法一致地拒绝恶意输入,增加了实际部署中的安全风险。其二,数据集构建过程中面临多重技术挑战:需要从JailbreakBench翻译并同步生成五种语言的音频,确保语义保真;设计自然的伪词插入策略以模拟对抗性混淆;合成高质量的多语言语音样本,同时平衡不同语言和配置之间的数据分布。这些挑战要求精细的文本处理、语音合成和评估流程,以保证基准的全面性和有效性。
常用场景
经典使用场景
SpeechJBB作为针对大型音频语言模型(LALMs)安全对齐与理解能力的基准测试集,其核心使用场景涵盖多语言与语码混合语音条件下的安全性评估。研究者借助该数据集,能够系统性地检验模型在面对单语、跨语言语码混合以及嵌入拟声伪词干扰的有害语音指令时,是否始终如一地执行拒绝机制。该基准测试将经典的JailbreakBench拓展至多语音领域,通过覆盖英语、德语、西班牙语、法语和意大利语五种语言及其相互组合,为评估多语言语音模型的安全鲁棒性提供了标准化的测试框架。
解决学术问题
在学术研究层面,SpeechJBB有效解决了大型音频语言模型在多语环境下安全对齐评估缺乏统一基准的痛点。它深入揭示了模型在面对语码混合及伪词混淆等复杂语言现象时的脆弱性,填补了现有研究对跨语言语音攻击防御能力评估的空白。该数据集推动了对抗性语音示例生成与分析方法的进步,为探索模型安全边界的语言学因素、研究语言混淆对安全机制的影响提供了关键实验工具,从而深刻影响了多模态大模型安全评估理论的发展。
实际应用
在实际应用领域,SpeechJBB可用于多语种语音助手的开发与部署前安全测试,特别是在涉及金融、医疗等高风险交互场景中。科技企业可依据该数据集构建自动化的红队测试流程,检测其语音交互系统在非英语母语用户使用语码混合表达时的安全漏洞。此外,它还可辅助训练多语言语音防火墙,通过预判伪词混淆的恶意输入模式,提升智能音箱、车载语音系统及翻译设备抵抗语音注入攻击的实际防护能力。
数据集最近研究
最新研究方向
SpeechJBB作为首个聚焦多语言与语码转换场景下大型音频语言模型(LALM)安全对齐的基准测试,其前沿研究方向深刻回应了生成式语音模型部署中的核心安全挑战。该数据集通过构建单语、语码转换及带有音系学伪词混淆的对抗性语音提示,系统评估模型在跨语言环境下的有害请求拒绝能力,这一设计直接关联到近期AI安全领域的红队测试与越狱攻击防御热点。当前,随着LALM在智能助手、多语言客服等场景的快速渗透,其潜在的语音越狱漏洞(如通过非英语矩阵语言隐蔽注入恶意指令)已成为行业关注焦点。SpeechJBB的提出不仅为研究者提供了标准化的多语言安全评估框架,更通过伪词插入比率(10%/30%/50%)的细粒度设计,揭示了模型对自然语言混淆的鲁棒性边界,其影响已催生出一系列关于端到端语音模型安全对齐策略的实证研究,为构建可信赖的跨语言语音交互系统奠定了关键方法论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

