
raptorkwok/cantonese_sentences
收藏官方服务:
资源简介:
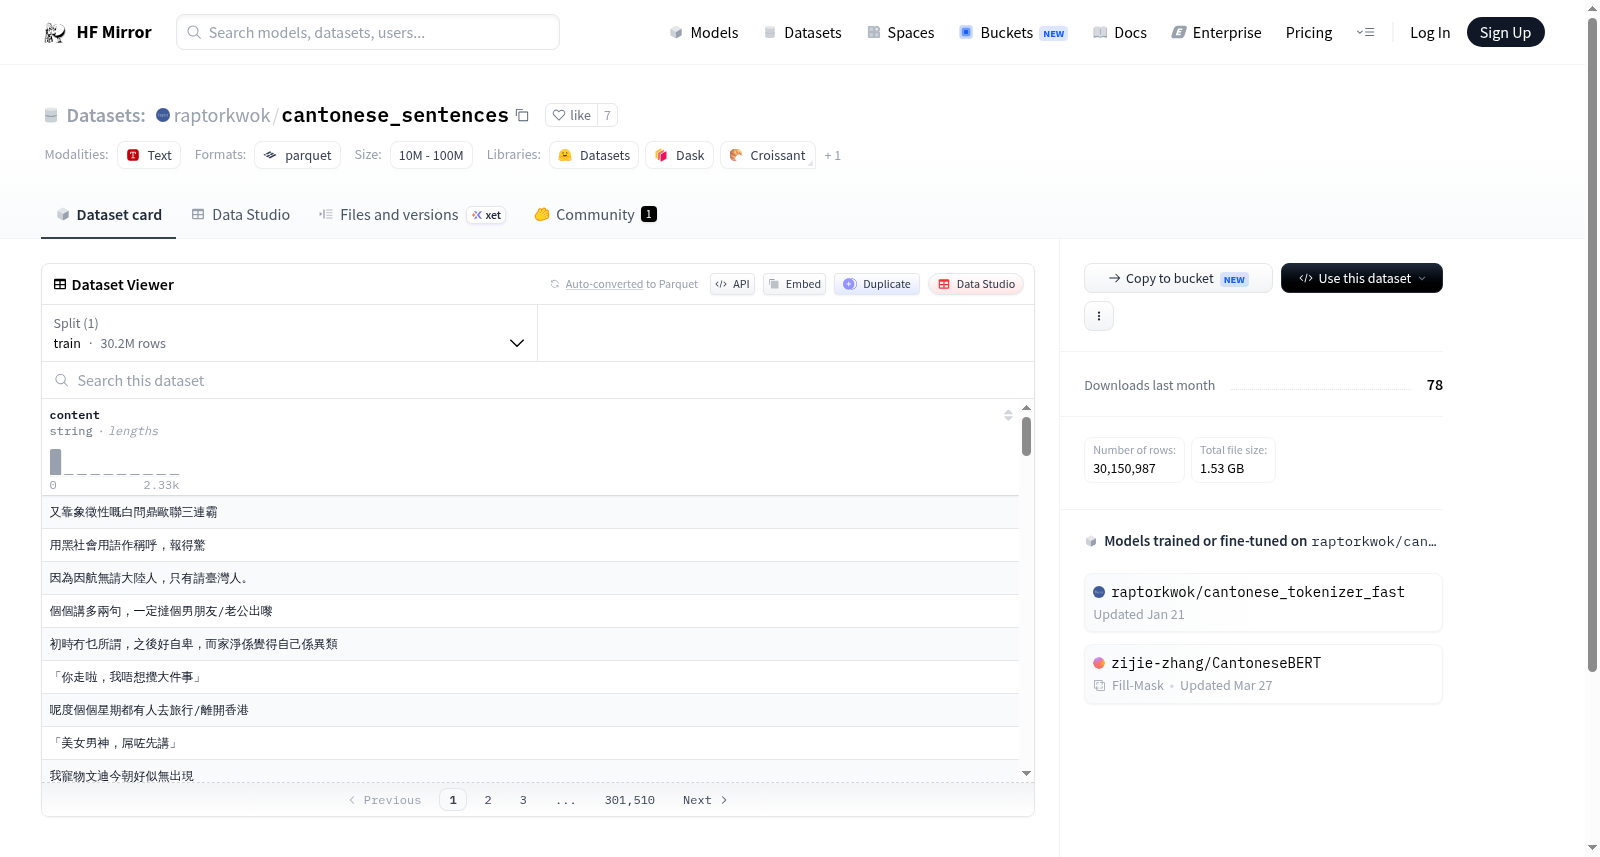
--- dataset_info: features: - name: content dtype: string splits: - name: train num_bytes: 2068932282 num_examples: 30150987 download_size: 1530555311 dataset_size: 2068932282 configs: - config_name: default data_files: - split: train path: data/train-* ---
数据集元信息: 特征字段: - 字段名称:content,数据类型:字符串(string) 数据集拆分: - 拆分名称:训练集(train),占用字节数:2068932282,样本总数:30150987 下载大小:1530555311,数据集总大小:2068932282 配置项: - 配置名称:默认配置(default),数据文件: - 拆分:train,文件路径:data/train-*
提供机构:
raptorkwok原始信息汇总
数据集概述
数据集特征
- 名称: content
- 数据类型: string
数据分割
- 分割名称: train
- 示例数量: 30150987
- 数据大小: 2068932282字节
数据集大小
- 下载大小: 1530555311字节
- 数据集总大小: 2068932282字节
配置信息
- 配置名称: default
- 数据文件路径: data/train-*
- 分割类型: train
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集包含约3000万条从香港本地论坛收集的原始粤语句子,部分句子被处理并用于构建粤语-书面中文平行语料库Gen 3,适合训练粤语语言模型或进行粤语自然语言处理任务。
以上内容由遇见数据集搜集并总结生成


