BookCorpus
收藏资源简介:
BookCorpus是一个流行的大型文本语料库,特别适用于无监督学习的句子编码器/解码器。然而,BookCorpus不再被分发。
BookCorpus is a widely recognized large-scale text corpus, particularly suitable for unsupervised learning in sentence encoders/decoders. However, BookCorpus is no longer distributed.
数据集概述
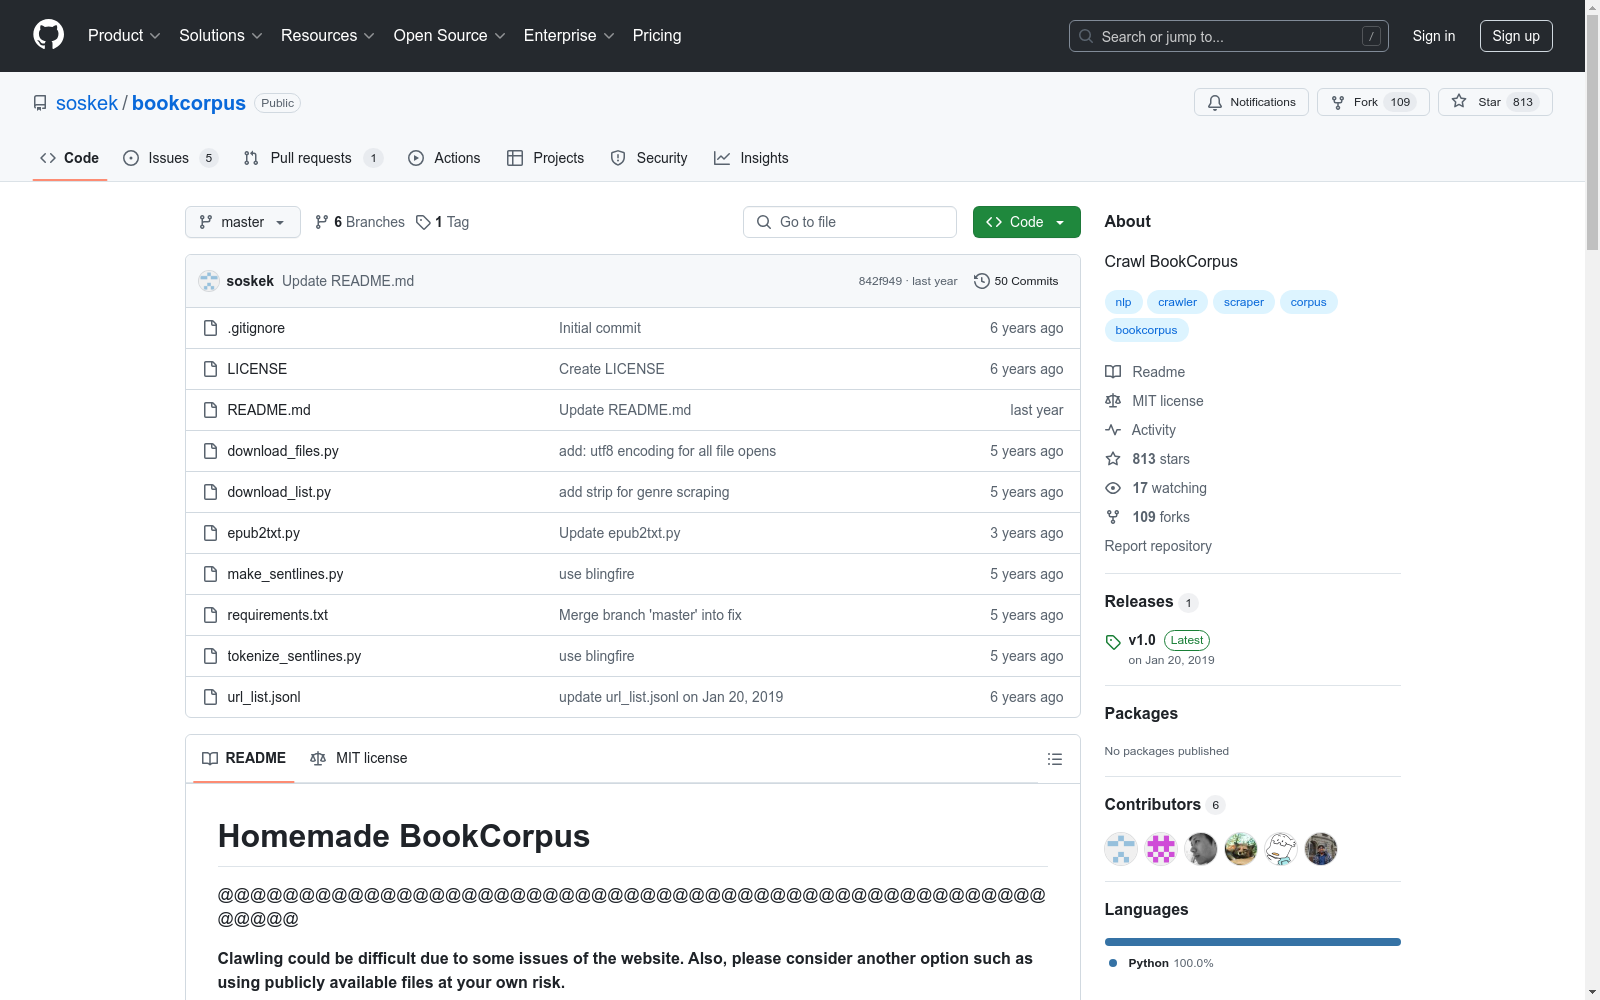
数据集名称: Homemade BookCorpus
数据来源: 该数据集通过爬虫从smashwords.com收集数据,这是原始BookCorpus的来源。
数据内容: 收集的句子可能与原始数据集部分不同,但数量大致相同或更多。使用新数据集时,应明确指出其为复制品。
数据集使用方法
-
准备URL列表: 使用提供的
url_list.jsonl文件,该文件包含了2019年1月19-20日收集的书籍URL列表。 -
下载文件: 使用
download_files.py脚本下载书籍文件。优先下载txt格式,否则尝试从epub格式提取文本。使用--trash-bad-count参数过滤掉字数与官方统计差异较大的epub文件。 -
后处理: 使用
make_sentlines.py脚本将下载的文本文件转换为每行一个句子的格式。若需进一步使用Microsoft的BlingFire进行分词,可运行tokenize_sentlines.py脚本。
注意事项
- 使用此代码时,请遵守smashwords.com的条款,并注意版权和相关法律。
- 预期会有一些错误,如
Failed: epub and txt,但成功下载的文件数量远多于失败数量。
技术要求
- 推荐使用Python3
- 需要安装
beautifulsoup4,progressbar2,blingfire,html2text,lxml等库。
引用信息
若使用此代码,请引用:
@misc{soskkobayashi2018bookcorpus, author = {Sosuke Kobayashi}, title = {Homemade BookCorpus}, howpublished = {url{https://github.com/soskek/bookcorpus}}, year = {2018} }