
BioRED-plus-BioInfer
收藏官方服务:
资源简介:
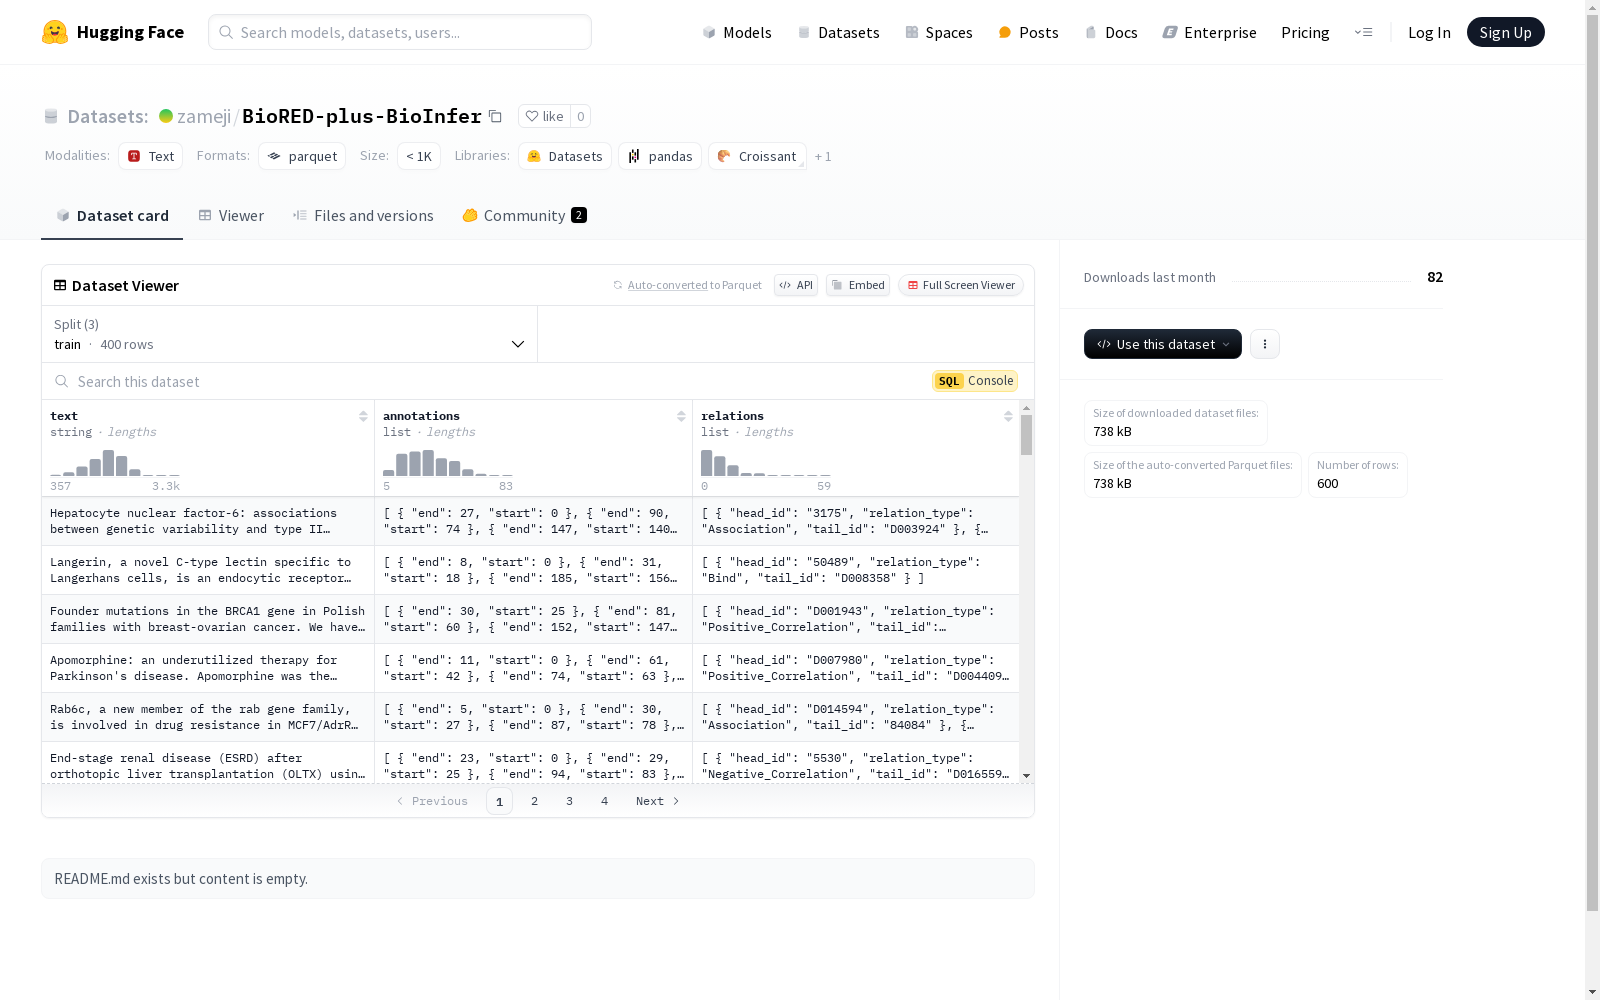
该数据集包含文本、注释和关系三个主要特征。文本特征为字符串,注释特征包含开始和结束位置的整数,关系特征包含头部ID、关系类型和尾部ID的字符串。数据集分为训练集、验证集和测试集,分别包含400、100和100个样本。数据集的总下载大小为737735字节,总数据集大小为1559069字节。
This dataset includes three primary features: text, annotation, and relationship. The text feature is of string type. The annotation feature contains integers indicating the start and end positions. The relationship feature comprises strings for head ID, relationship type, and tail ID. The dataset is divided into training, validation, and test sets, which hold 400, 100, and 100 samples respectively. The total download size of the dataset is 737,735 bytes, while the overall size of the full dataset is 1,559,069 bytes.
创建时间:
2024-11-29
原始信息汇总
BioRED-plus-BioInfer 数据集概述
数据集信息
特征
- text: 类型为
string,表示文本内容。 - annotations: 包含以下子特征:
- end: 类型为
int64,表示结束位置。 - start: 类型为
int64,表示起始位置。
- end: 类型为
- relations: 包含以下子特征:
- head_id: 类型为
string,表示头部实体ID。 - relation_type: 类型为
string,表示关系类型。 - tail_id: 类型为
string,表示尾部实体ID。
- head_id: 类型为
数据分割
- train: 包含 400 个样本,大小为 1024532 字节。
- validation: 包含 100 个样本,大小为 269817 字节。
- test: 包含 100 个样本,大小为 264720 字节。
数据集大小
- 下载大小: 737735 字节
- 数据集总大小: 1559069 字节
配置
- config_name:
default- 数据文件路径:
- train:
data/train-* - validation:
data/validation-* - test:
data/test-*
- train:
- 数据文件路径:
搜集汇总
数据集介绍
构建方式
BioRED-plus-BioInfer数据集的构建基于生物医学领域的文本数据,旨在捕捉生物实体之间的复杂关系。该数据集通过系统地标注生物医学文献中的实体及其相互关系,形成了一个结构化的知识库。具体而言,数据集中的每条记录包含文本片段、实体的标注信息以及实体间的关系类型,确保了数据的高质量和专业性。
特点
BioRED-plus-BioInfer数据集的显著特点在于其专注于生物医学领域的实体关系抽取,涵盖了多种实体类型及其复杂关系。数据集的标注信息包括实体的起始和结束位置,以及实体间的关系类型,如‘head_id’和‘tail_id’,这些特征使得该数据集在生物医学信息抽取任务中具有极高的应用价值。
使用方法
BioRED-plus-BioInfer数据集适用于多种自然语言处理任务,特别是生物医学领域的实体识别和关系抽取。用户可以通过加载数据集的训练、验证和测试部分,利用其中的文本和标注信息进行模型训练和评估。数据集的结构化设计使得其易于集成到现有的机器学习框架中,为研究者提供了便捷的数据处理和分析工具。
背景与挑战
背景概述
BioRED-plus-BioInfer数据集是由相关领域的研究人员和机构创建,旨在推动生物医学文本中的实体关系抽取研究。该数据集的构建时间可追溯至近年,其核心研究问题聚焦于从生物医学文献中自动提取实体间的关系,这对于加速生物医学知识的发现与整合具有重要意义。主要研究人员或机构通过整合BioRED和BioInfer两个数据集,进一步扩展了其应用范围,提升了数据集在生物医学信息学领域的影响力。
当前挑战
BioRED-plus-BioInfer数据集在构建过程中面临诸多挑战。首先,生物医学文本的复杂性和专业性使得实体识别和关系抽取任务异常艰巨。其次,数据集的构建需要整合多个来源的数据,确保数据的一致性和准确性,这增加了数据清洗和处理的难度。此外,如何有效地标注和分类实体间的关系,以及确保标注的一致性和可扩展性,也是该数据集面临的重要挑战。
常用场景
经典使用场景
BioRED-plus-BioInfer数据集在生物医学领域中被广泛应用于关系抽取任务,特别是在识别和分类生物实体之间的相互作用关系方面。该数据集通过提供丰富的文本和详细的标注信息,使得研究者能够训练和评估模型在生物医学文本中自动识别实体及其关系的准确性。
解决学术问题
该数据集解决了生物医学文本中实体关系抽取的学术难题,为研究者提供了一个标准化的基准,用于评估和比较不同模型的性能。通过提供精确的标注和多样化的关系类型,BioRED-plus-BioInfer推动了生物医学信息学领域的发展,有助于提高生物医学文献的自动化处理能力。
衍生相关工作
基于BioRED-plus-BioInfer数据集,研究者们开发了多种先进的自然语言处理模型,用于生物医学文本的实体识别和关系抽取。这些模型不仅在学术界引起了广泛关注,还在实际应用中展示了显著的性能提升。此外,该数据集还激发了相关领域的研究,如多模态学习、跨领域知识迁移等,进一步推动了生物医学信息学的创新。
以上内容由遇见数据集搜集并总结生成


