
遇见数据集

KRAFTON/Raon-OpenTTS-Pool

收藏
Hugging Face2026-05-21 更新2026-04-05 收录
官方服务:

资源简介:

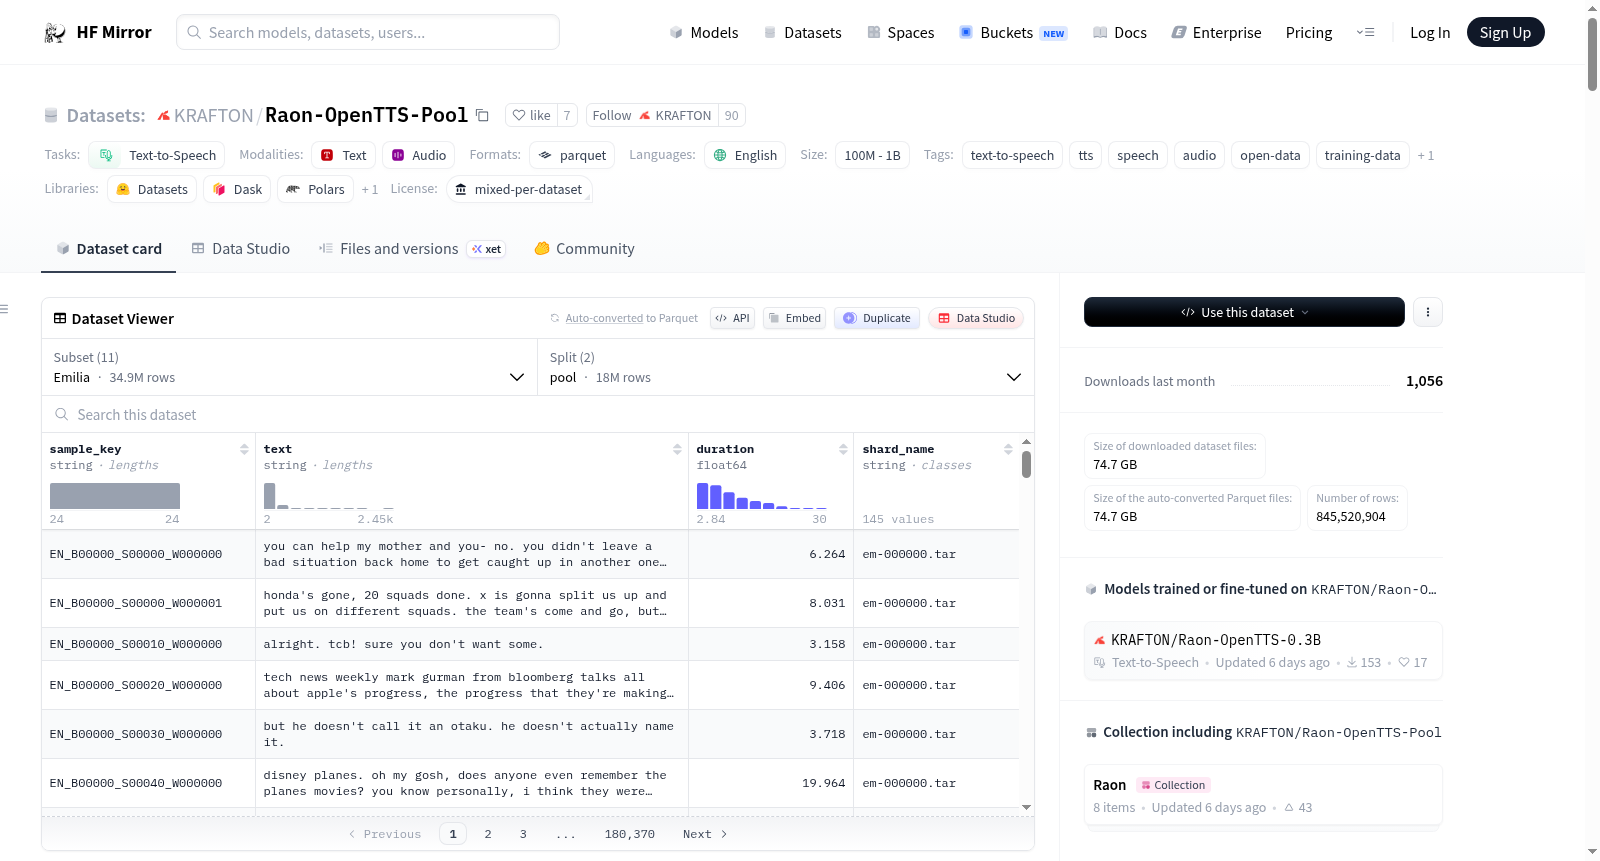
Raon-OpenTTS-Pool是一个用于文本到语音(TTS)训练的大规模开放英语语音语料库,由8个公开可用的语音语料库和一组网络来源的录音构建而成。它是Raon-OpenTTS训练数据的基础,Raon-OpenTTS是一个开放TTS模型,其性能与最先进的封闭数据系统相当。该数据集包含615K小时的语音音频、239.7M个语音片段,所有音频以16 kHz单声道Opus(64 kbps)格式存储在WebDataset tar分片中。数据集还包括一个经过质量过滤的子集Raon-OpenTTS-Core,包含510.1K小时和194.5M个片段。数据来源限制为公开可用的英语语音数据集,每个音频片段限制在30秒或更短,以减少对齐错误、多说话人内容和非语音伪影。现有公共数据集(如LibriHeavy、Emilia、VoxPopuli等)未经修改直接包含,音频标准化为16 kHz单声道Opus 64 kbps以提高存储效率。Raon-YouTube-Commons部分通过专用预处理流程从YouTube-Commons重建。

Raon-OpenTTS-Pool is a large-scale open English speech corpus for text-to-speech (TTS) training, constructed from 8 publicly available speech corpora and a set of web-sourced recordings. It serves as the foundational training data for Raon-OpenTTS, an open-source TTS model whose performance is on par with state-of-the-art closed-data systems. This dataset contains 615K hours of speech audio and 239.7M speech segments, with all audio stored in WebDataset tar shards in 16 kHz mono Opus (64 kbps) format. The dataset also includes a quality-filtered subset named Raon-OpenTTS-Core, which consists of 510.1K hours and 194.5M segments. All data sources are restricted to publicly available English speech datasets, and each audio segment is limited to 30 seconds or shorter to reduce alignment errors, multi-speaker content, and non-speech artifacts. Existing public datasets such as LibriHeavy, Emilia, VoxPopuli and others are included unmodified, and audio is standardized to 16 kHz mono Opus 64 kbps to improve storage efficiency. The Raon-YouTube-Commons subset is reconstructed from YouTube-Commons via a dedicated preprocessing pipeline.
提供机构:
KRAFTON
搜集汇总
数据集介绍
KRAFTON/Raon-OpenTTS-Pool 数据集图片
构建方式
在语音合成领域,大规模高质量数据集的构建是推动技术发展的关键基石。Raon-OpenTTS-Pool的构建采用了系统化的集成与标准化策略,其核心在于汇聚了八个公开可用的英语语音语料库及一组网络采集的录音,总计涵盖615千小时的语音音频与2.397亿个语音片段。构建过程中,所有语音片段被限制在30秒以内,以降低对齐误差并减少多说话人内容与非语音伪影的影响。现有公共数据集如LibriHeavy、VoxPopuli等均以原始形式纳入,并通过统一转换为16kHz单声道Opus格式以实现存储效率。特别地,针对YouTube-Commons来源的数据,设计了一套包含源分离、说话人日志、语音活动检测与自动转录的专用预处理流程,从而重构出高质量的Raon-YouTube-Commons子集。
特点
该数据集展现出显著的大规模与高质量并重的特征。其总体规模达到615千小时,为当前公开语音合成数据集中最为庞大的资源之一。数据集通过精心设计的质量过滤流程,衍生出Raon-OpenTTS-Core这一精选子集,保留了约85%的数据,确保了核心训练素材的纯净度。过滤机制融合了基于Whisper的单词错误率评估、DNSMOS的感知语音质量估计以及Silero VAD的语音活动比率分析,通过综合排名剔除质量最低的15%样本。这种多维度过滤策略在多样化的评估基准测试中展现出最优的整体性能。数据集采用WebDataset分片格式存储,每个样本包含音频文件与包含文本、时长及来源的元数据文件,便于高效流式加载与分布式处理。
使用方法
为有效利用该数据集进行模型训练,用户需遵循结构化的数据加载流程。首先,可通过Hugging Face的`datasets`库加载特定子数据集或全部数据集的元数据,这些元数据以Parquet格式提供,包含样本键、文本、时长及分片名称等信息。其次,音频内容存储于WebDataset的tar分片中,需先使用`snapshot_download`下载至本地,再通过`webdataset`库进行流式读取。每个tar分片内,音频以Opus格式存储,对应的JSON文件则提供文本标注。若仅需使用经过质量过滤的Core子集进行训练,可在加载音频流时,依据从元数据中提取的Core样本键集合进行过滤。对于因许可限制未包含在内的GigaSpeech与SPGISpeech数据集,提供了专用脚本,在用户接受相应许可后,可自动下载并转换为与本数据集一致的格式,以便整合训练。
背景与挑战
背景概述
Raon-OpenTTS-Pool是KRAFTON AI于2026年发布的大规模开放英语语音语料库,专为文本到语音(TTS)模型训练而构建。该数据集整合了包括LibriHeavy、Emilia、VoxPopuli在内的11个公开语音数据集,并融合了来自YouTube-Commons的网络音频资源,总计涵盖615千小时的语音音频和239.7百万个语音片段。其核心研究问题在于解决高质量、大规模TTS训练数据的稀缺性,通过统一格式与标准化处理,为开放TTS模型的发展提供了坚实的数据基础,显著推动了语音合成领域向更高效、更鲁棒的方向演进。
当前挑战
Raon-OpenTTS-Pool面临的挑战主要集中于两方面:在领域问题层面,文本到语音任务需应对语音质量、口音多样性、背景噪声抑制以及语音-文本对齐精度等复杂问题,确保合成语音的自然度与清晰度;在构建过程中,数据集整合了多源异构数据,需克服音频格式统一、许可证兼容性管理以及大规模数据预处理的技术障碍,例如通过语音活动检测、说话人分离和自动转录流程来净化网络来源的音频,并应用基于WER、DNSMOS和VAD的模型过滤机制以提取高质量子集,这些步骤均涉及计算资源与算法优化的双重考验。
常用场景
经典使用场景
在语音合成技术领域,大规模高质量训练数据是模型性能的基石。Raon-OpenTTS-Pool作为目前规模最大的公开英语语音语料库之一,其最经典的使用场景是作为端到端神经语音合成模型的训练基础。研究人员利用其超过61.5万小时的语音音频和2.397亿个语音片段,能够训练出具有自然韵律和丰富音色表现力的TTS系统。该数据集特别适用于训练需要海量数据支撑的现代生成式语音模型,如基于Transformer架构或扩散模型的语音合成系统,这些模型通过学习数据集中多样的发音风格和声学特征,能够生成接近人类自然语音的合成结果。
解决学术问题
该数据集有效解决了语音合成研究中长期存在的几个关键学术问题。首先,它通过整合多个公开数据集并实施统一的质量过滤标准,缓解了高质量训练数据稀缺的困境,为研究社区提供了标准化的基准资源。其次,其包含的Raon-OpenTTS-Core子集通过多维度质量筛选机制,为研究数据清洗和样本选择策略提供了实证基础,有助于探索数据质量与模型性能之间的量化关系。更重要的是,该数据集支持开放科学理念,使研究者能够复现和比较不同算法在相同数据条件下的表现,推动了语音合成技术的透明化发展和公平评估体系的建立。
衍生相关工作
该数据集的发布催生了一系列重要的衍生研究工作。最直接的相关成果是RAON-OpenTTS开源模型系列,这些模型在多项基准测试中达到了与闭源商业系统相当的性能水平。研究社区基于该数据集开展了数据高效利用方法的探索,包括少样本适应、零样本语音克隆等前沿方向。在数据质量评估领域,学者们借鉴其过滤管道设计了更精细的语音样本评分体系。跨语言迁移学习研究则利用该英语数据集作为预训练基础,加速低资源语言的语音合成模型开发。这些工作共同构成了当前开放语音合成生态系统的核心组成部分,持续推动着该领域的技术进步。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

