Rubilax/goat
收藏资源简介:
--- license: mit task_categories: - question-answering language: - ru tags: - sociology size_categories: - 1K<n<10K dataset_info: - config_name: single_choice_sociology features: - name: input dtype: string - name: A dtype: string - name: B dtype: string - name: C dtype: string - name: D dtype: string - name: answer dtype: class_label: names: '0': A '1': B '2': C '3': D - config_name: multiple_choice_sociology features: - name: input dtype: string - name: answer dtype: string - config_name: word_generation_sociology features: - name: input dtype: string - name: answer dtype: string - config_name: word_generation_literature features: - name: input dtype: string - name: answer dtype: string - config_name: matching_sociology features: - name: input dtype: string - name: answer dtype: string - config_name: matching_literature features: - name: input dtype: string - name: answer dtype: string configs: - config_name: single_choice_sociology data_files: - split: test path: "single_choice/test/sociology_test.csv" - split: dev path: "single_choice/dev/sociology_dev.csv" - config_name: multiple_choice_sociology data_files: - split: test path: "multiple_choice/test/sociology_test.csv" - split: dev path: "multiple_choice/dev/sociology_dev.csv" - config_name: word_generation_sociology data_files: - split: test path: "word_generation/test/sociology_test.csv" - split: dev path: "word_generation/dev/sociology_dev.csv" - config_name: word_generation_literature data_files: - split: test path: "word_generation/test/literature_test.csv" - split: dev path: "word_generation/dev/literature_dev.csv" - config_name: word_generation_sociology data_files: - split: test path: "word_generation/test/sociology_test.csv" - split: dev path: "word_generation/dev/sociology_dev.csv" - config_name: word_generation_literature data_files: - split: test path: "word_generation/test/literature_test.csv" - split: dev path: "word_generation/dev/literature_dev.csv" - config_name: matching_sociology data_files: - split: test path: "matching/test/sociology_test.csv" - split: dev path: "matching/dev/sociology_dev.csv" - config_name: matching_literature data_files: - split: test path: "matching/test/literature_test.csv" - split: dev path: "matching/dev/literature_dev.csv" ---
许可证:MIT许可证 任务类别: - 问答 语言: - 俄语(ru) 标签: - 社会学 样本规模: - 1000 < 样本量 < 10000 数据集信息: - 配置名称:single_choice_sociology 特征: - 字段名:输入(input),数据类型:字符串 - 字段名:A,数据类型:字符串 - 字段名:B,数据类型:字符串 - 字段名:C,数据类型:字符串 - 字段名:D,数据类型:字符串 - 字段名:答案(answer),数据类型:类标签(class_label),其名称映射为:'0'对应'A','1'对应'B','2'对应'C','3'对应'D' - 配置名称:multiple_choice_sociology 特征: - 字段名:输入(input),数据类型:字符串 - 字段名:答案(answer),数据类型:字符串 - 配置名称:word_generation_sociology 特征: - 字段名:输入(input),数据类型:字符串 - 字段名:答案(answer),数据类型:字符串 - 配置名称:word_generation_literature 特征: - 字段名:输入(input),数据类型:字符串 - 字段名:答案(answer),数据类型:字符串 - 配置名称:matching_sociology 特征: - 字段名:输入(input),数据类型:字符串 - 字段名:答案(answer),数据类型:字符串 - 配置名称:matching_literature 特征: - 字段名:输入(input),数据类型:字符串 - 字段名:答案(answer),数据类型:字符串 配置: - 配置名称:single_choice_sociology 数据文件: - 划分:测试集,路径:"single_choice/test/sociology_test.csv" - 划分:开发集,路径:"single_choice/dev/sociology_dev.csv" - 配置名称:multiple_choice_sociology 数据文件: - 划分:测试集,路径:"multiple_choice/test/sociology_test.csv" - 划分:开发集,路径:"multiple_choice/dev/sociology_dev.csv" - 配置名称:word_generation_sociology 数据文件: - 划分:测试集,路径:"word_generation/test/sociology_test.csv" - 划分:开发集,路径:"word_generation/dev/sociology_dev.csv" - 配置名称:word_generation_literature 数据文件: - 划分:测试集,路径:"word_generation/test/literature_test.csv" - 划分:开发集,路径:"word_generation/dev/literature_dev.csv" - 配置名称:word_generation_sociology 数据文件: - 划分:测试集,路径:"word_generation/test/sociology_test.csv" - 划分:开发集,路径:"word_generation/dev/sociology_dev.csv" - 配置名称:word_generation_literature 数据文件: - 划分:测试集,路径:"word_generation/test/literature_test.csv" - 划分:开发集,路径:"word_generation/dev/literature_dev.csv" - 配置名称:matching_sociology 数据文件: - 划分:测试集,路径:"matching/test/sociology_test.csv" - 划分:开发集,路径:"matching/dev/sociology_dev.csv" - 配置名称:matching_literature 数据文件: - 划分:测试集,路径:"matching/test/literature_test.csv" - 划分:开发集,路径:"matching/dev/literature_dev.csv"
数据集概述
许可证
- MIT许可证
任务类别
- 问答
语言
- 俄语
标签
- 社会学
数据集大小
- 1K<n<10K
数据集配置
单选社会学
- 配置名称: single_choice_sociology
- 特征:
- input: string
- A: string
- B: string
- C: string
- D: string
- answer:
- class_label:
- 0: A
- 1: B
- 2: C
- 3: D
- class_label:
- 数据文件:
- 测试集: single_choice/test/sociology_test.csv
- 开发集: single_choice/dev/sociology_dev.csv
多选社会学
- 配置名称: multiple_choice_sociology
- 特征:
- input: string
- answer: string
- 数据文件:
- 测试集: multiple_choice/test/sociology_test.csv
- 开发集: multiple_choice/dev/sociology_dev.csv
单词生成社会学
- 配置名称: word_generation_sociology
- 特征:
- input: string
- answer: string
- 数据文件:
- 测试集: word_generation/test/sociology_test.csv
- 开发集: word_generation/dev/sociology_dev.csv
单词生成文学
- 配置名称: word_generation_literature
- 特征:
- input: string
- answer: string
- 数据文件:
- 测试集: word_generation/test/literature_test.csv
- 开发集: word_generation/dev/literature_dev.csv
匹配社会学
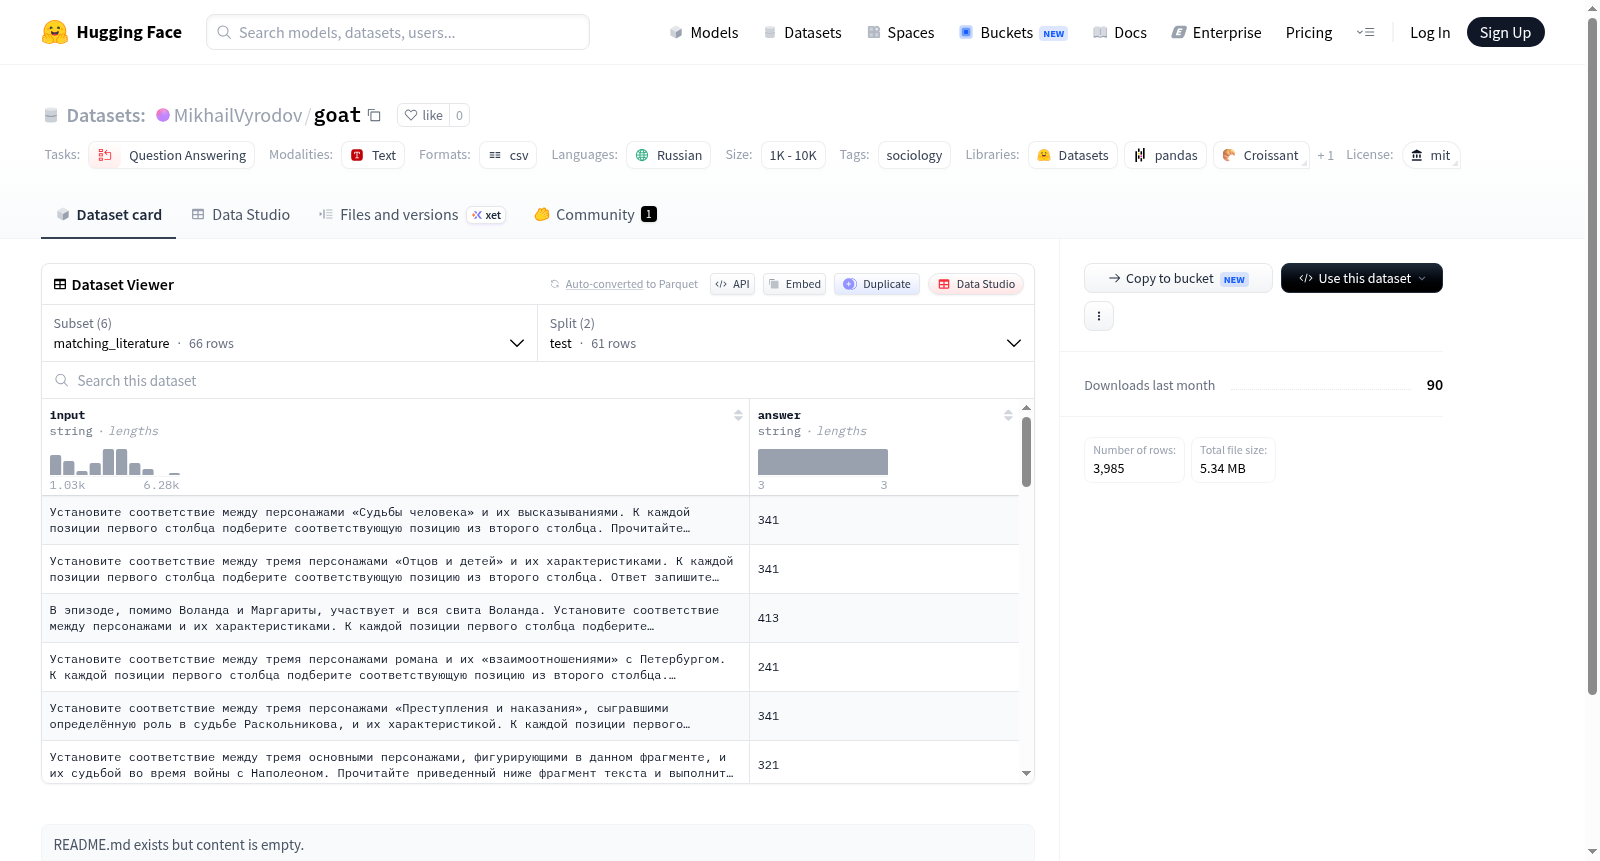
- 配置名称: matching_sociology
- 特征:
- input: string
- answer: string
- 数据文件:
- 测试集: matching/test/sociology_test.csv
- 开发集: matching/dev/sociology_dev.csv
匹配文学
- 配置名称: matching_literature
- 特征:
- input: string
- answer: string
- 数据文件:
- 测试集: matching/test/literature_test.csv
- 开发集: matching/dev/literature_dev.csv