HoloFaceIllusion-Bench-EEG
收藏资源简介:
HoloFaceIllusion-Bench-EEG是一个大规模的整体面部错觉刺激基准数据集,旨在测试人类与深度神经网络(DNN)在构形面部处理上的对齐性,并用于配对的脑电图(EEG)解码器评估。该数据集完全使用纯经典计算机视觉技术(dlib + OpenCV Poisson + Reinhard LAB)构建,未使用任何神经网络或生成式AI创建像素。数据集包含两个子集:v1.0(基于撒切尔错觉,源自Thompson 1980范式)和v1.2(基于部分-整体错觉,源自Tanaka 2004模板范式),两者均源自相同的FFHQ-1024源数据。v1.0子集包含26,317个身份,每个身份在4种条件下(直立正常、直立撒切尔化、倒置正常、倒置撒切尔化)生成图像,共计105,268张PNG图像,数据量约134 GB。v1.2子集采用模板设计,包含955个模板,每个模板对应9个目标(每个目标由3个不同供体的面部特征组成),测试眼睛、鼻子、嘴巴3个特征,每个(目标,特征)对在4种条件下(整体目标、整体干扰项、部分目标、部分干扰项)生成图像,共计103,140张PNG图像,数据量约72.7 GB。数据集以WebDataset格式组织,每个样本包含多张PNG图像和对应的元数据JSON文件。该数据集适用于整体面部处理能力基准测试(跨视觉Transformer、CNN、视觉语言模型等检查点)、EEG配对刺激设计(用于分析N170/N250等事件相关电位差异)、表征相似性分析(比较刺激、模型和大脑的表征差异矩阵)以及微调生物启发式面部模型。数据集采用CC BY-NC-SA 4.0许可证,仅限学术和非商业用途,并继承了FFHQ源数据的西方高加索人种偏差,因此不建议直接用于未经审核的人口统计公平性关键应用。
HoloFaceIllusion-Bench-EEG is a large-scale holistic face illusion stimulus benchmark dataset designed to test the alignment between humans and deep neural networks (DNNs) on configural face processing, and for paired electroencephalogram (EEG) decoder evaluation. This dataset is constructed entirely using pure classical computer vision techniques (dlib + OpenCV Poisson + Reinhard LAB), without utilizing any neural networks or generative AI for pixel generation. The dataset contains two subsets: v1.0 (based on the Thatcher illusion, derived from the Thompson 1980 paradigm) and v1.2 (based on the part-whole illusion, derived from the Tanaka 2004 template paradigm), both sourced from the same FFHQ-1024 dataset. The v1.0 subset includes 26,317 identities, with images generated for each identity under four conditions: upright normal, upright Thatcherized, inverted normal, and inverted Thatcherized, totaling 105,268 PNG images with an approximate data size of 134 GB. The v1.2 subset adopts a template-based design, containing 955 templates, each corresponding to 9 targets (each target is composed of facial features from 3 distinct donors), testing three features: eyes, nose, and mouth. For each (target, feature) pair, images are generated under four conditions: whole target, whole distractor, part target, and part distractor, totaling 103,140 PNG images with an approximate data size of 72.7 GB. The dataset is organized in WebDataset format, with each sample containing multiple PNG images and corresponding metadata JSON files. This dataset is suitable for holistic face processing benchmarking across checkpoints of Vision Transformer, CNN, vision-language models and other architectures, paired EEG stimulus design for analyzing event-related potential differences such as N170/N250, representational similarity analysis to compare representational difference matrices of stimuli, models and brains, as well as fine-tuning biologically inspired face models. The dataset is licensed under CC BY-NC-SA 4.0 for academic and non-commercial use only. It inherits the Western Caucasian demographic bias from the FFHQ source dataset, so it is not recommended for direct use in unvetted applications critical to demographic fairness.
HoloFaceIllusion-Bench-EEG 数据集概述
基本信息
- 许可证: CC BY-NC-SA 4.0
- 任务类别: 图像分类、图像到图像
- 语言: 英语
- 标签: 人脸、视觉、心理物理学、撒切尔错觉、部分-整体错觉、整体人脸处理、脑电图、基准测试、生物启发
- 数据规模: 100K < n < 1M
- 数据集名称: HoloFaceIllusion-Bench-EEG
数据集简介
这是一个大规模的整体人脸错觉刺激基准数据集,用于测试人类与深度神经网络在构型人脸处理上的对齐程度,以及用于配对脑电解码器评估。所有图像均使用纯经典计算机视觉方法(dlib + OpenCV Poisson + Reinhard LAB)构建,未使用任何神经网络或生成式AI创建像素。
数据集包含两个子数据集,共享相同的FFHQ-1024源(Karras 2019)和相同的经典CV构建理念,以独立的config_name组织在同一个Hugging Face仓库中。
| 版本 | 范式 | 身份/模板 | 图像数 | 大小 |
|---|---|---|---|---|
| v1.0 (撒切尔) | Thompson 1980 仅眼部 | 26,317个身份 | 105,268张PNG | 134 GB |
| v1.2 (部分-整体) | Tanaka 2004 基于模板 | 955个模板 × 9个目标 | 103,140张PNG | 72.7 GB |
| v1.1 (复合) | Young 1987 | — | 计划中 | — |
v1.0 — 撒切尔错觉(Thompson 1980)
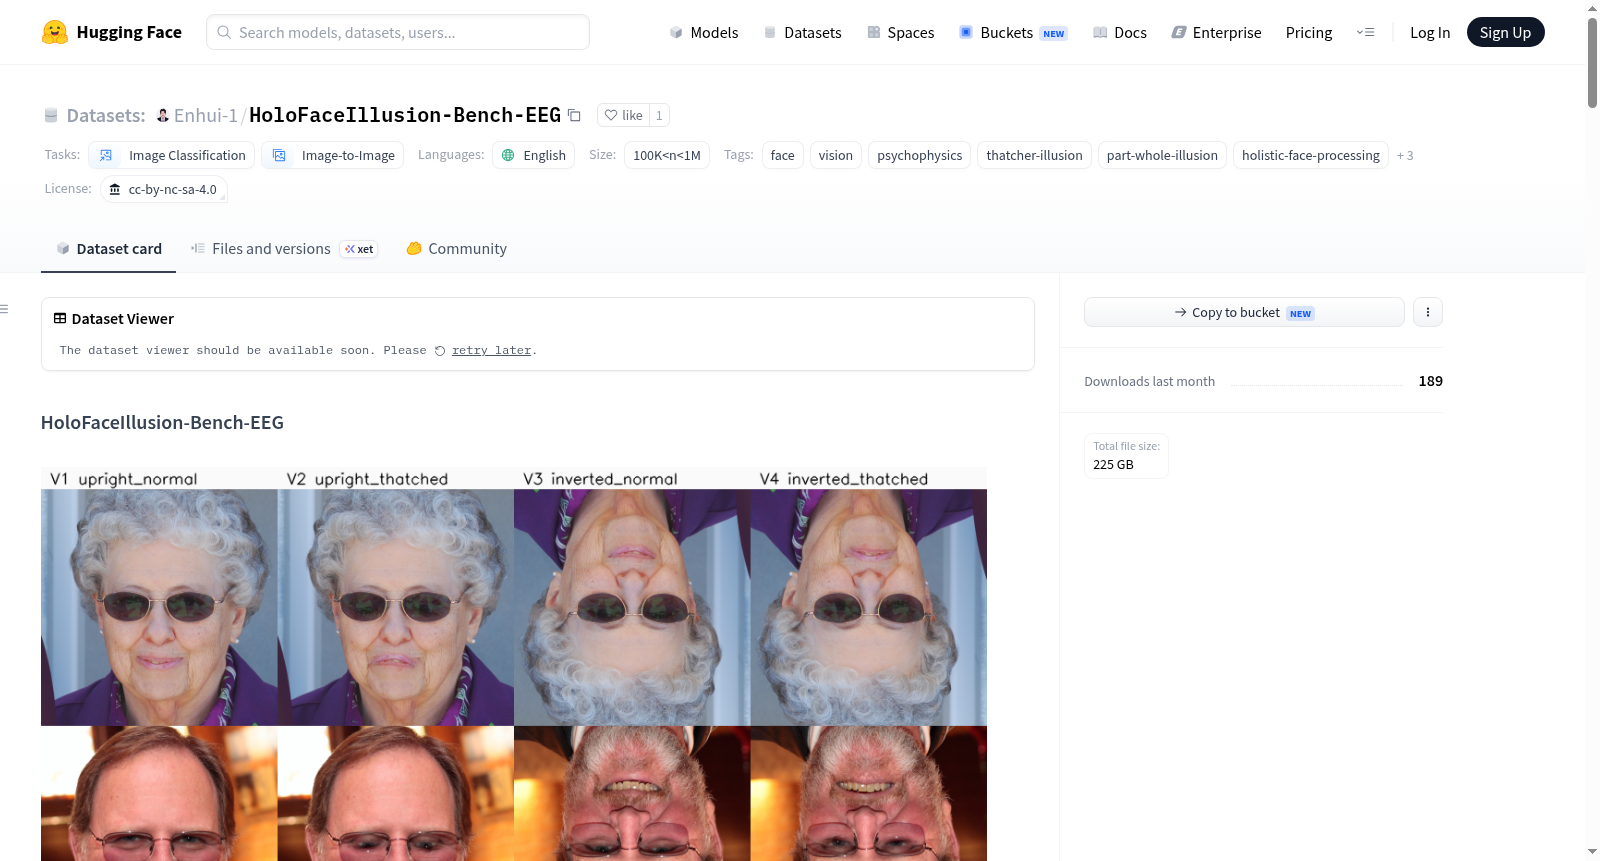
范式: 对每张人脸,将眼睛和嘴巴在原地旋转180°(仅眼部变体,眉毛保持不动)。正立的撒切尔化人脸看起来怪异,倒置版本则几乎正常。
数据详情
| 项目 | 说明 |
|---|---|
| 身份数量 | 26,317个(通过dlib过滤的FFHQ身份,通过率37.6%) |
| 每个身份的条件 | 4种(V1正立正常、V2正立撒切尔化、V3倒置正常、V4倒置撒切尔化) |
| Tar分片 | 70个(每个约1.9 GB),命名为00000.tar...69000.tar |
| 像素基线ISI | 1.000(V3 = V1旋转180°,V4 = V2旋转180°) |
Tar布局(webdataset格式,每个身份一个样本)
ffhq_NNNNN/V1_upright_normal.png ffhq_NNNNN/V2_upright_thatched.png ffhq_NNNNN/V3_inverted_normal.png ffhq_NNNNN/V4_inverted_thatched.png ffhq_NNNNN/landmarks.json
规模对比(比此前撒切尔数据集大约1,300倍)
| 来源 | 身份数量 | 是否发布 |
|---|---|---|
| Jacob et al. 2021 Nat Comm | 20 | 是(OSF) |
| Dobs et al. 2023 PNAS | 40-100 | 是(OSF) |
| HoloFaceIllusion-Bench-EEG v1.0 | 26,317 | 是(本数据集) |
构建方法: dlib HOG+SVM检测 + 68点Kazemi-Sullivan landmarks + 质心对称边界框旋转 + 鬼影联合掩膜 + Poisson NORMAL_CLONE。
v1.2 — 部分-整体错觉(Tanaka 2004 基于模板)
范式: 采用单一的面部轮廓模板,将来自三个不同个体的面部特征粘贴到模板中。干扰项则用另一个目标的相同特征替换其中一个特征。
数据详情
| 项目 | 说明 |
|---|---|
| 模板数量 | 955个(对24,374个成人FFHQ人脸进行k-means人口统计学聚类) |
| 每个模板的目标 | 9个(每个目标包含3个不同捐赠者的特征) |
| 测试的特征 | 3种(眼睛/鼻子/嘴巴) |
| 每个(目标,特征)的条件 | 4种(V1整体目标、V2整体干扰、V3部分目标、V4部分干扰) |
| 总样本数 | 25,785个(模板,目标,特征)三元组 |
| 总图像数 | 103,140张 |
| Tar分片 | 20个(v1.2/partwhole_00.tar...partwhole_19.tar,每个约3.8 GB) |
Tar布局(webdataset格式,一个样本 = 模板 × 目标 × 特征)
ffhq_NNNNN/tNN_feature/V1.png (整体目标) ffhq_NNNNN/tNN_feature/V2.png (整体干扰) ffhq_NNNNN/tNN_feature/V3.png (灰色背景上的部分目标) ffhq_NNNNN/tNN_feature/V4.png (灰色背景上的部分干扰) ffhq_NNNNN/tNN_feature/meta.json (目标捐赠者、干扰捐赠者、ssim_v1v2)
构建方法: 每个特征的2点相似性变换(保留捐赠者形状)+ 掩膜联合 + Reinhard LAB重新着色 + MIXED_CLONE Poisson + 拉普拉斯细节保留层 + 通过lwr/upr face proportion < 3.85的婴儿过滤器。
数据集创建目的
整体人脸处理是大脑将人脸作为整合整体进行处理的倾向性,这是人类面孔知觉最稳健的行为标志。本基准测试针对三种经典错觉:
| 错觉 | 测试内容 | 状态 |
|---|---|---|
| 撒切尔(Thompson 1980) | 对局部特征在人脸上下文中朝向的敏感性 | ✅ v1.0 |
| 复合人脸(Young 1987) | 半脸整合 | 📋 v1.1计划中 |
| 部分-整体(Tanaka & Farah 1993) | 特征辨别依赖于整体人脸上下文 | ✅ v1.2 |
该基准测试提供受控的配对刺激(V1/V2错觉对比,V3/V4基线对照),规模比已发表的心理物理刺激集大100-1300倍,足够用于表征相似性分析、神经网络层探测和脑电解码器配对。
预期用途
- 整体处理基准测试: 跨模型检查点(视觉Transformer、CNN、视觉-语言模型)测量每层/每个检查点的ISI/PWI
- 脑电图配对刺激设计: V1/V2对用于N170/N250 ERP差异;V3/V4用于早期视觉基线
- 表征相似性分析: 配对V1-V4 RDM与模型RDM及大脑RDM对比
- 微调: 在整体处理任务上微调生物启发的人脸模型
明确不适用于
- 从头训练通用人脸识别(请使用VGGFace2/MS1MV2/WebFace260M)
- 商业应用(CC BY-NC-SA 4.0 — 仅限非商业用途)
- 未经进一步审计的人口统计公平性关键应用(FFHQ存在西方白种人偏差;本数据集继承此偏差)
许可证
CC BY-NC-SA 4.0 — 继承自FFHQ。学术/非商业用途;若重新分发修改版本需保持相同许可。