
遇见数据集

kepeng/MeasL-150K-V1

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

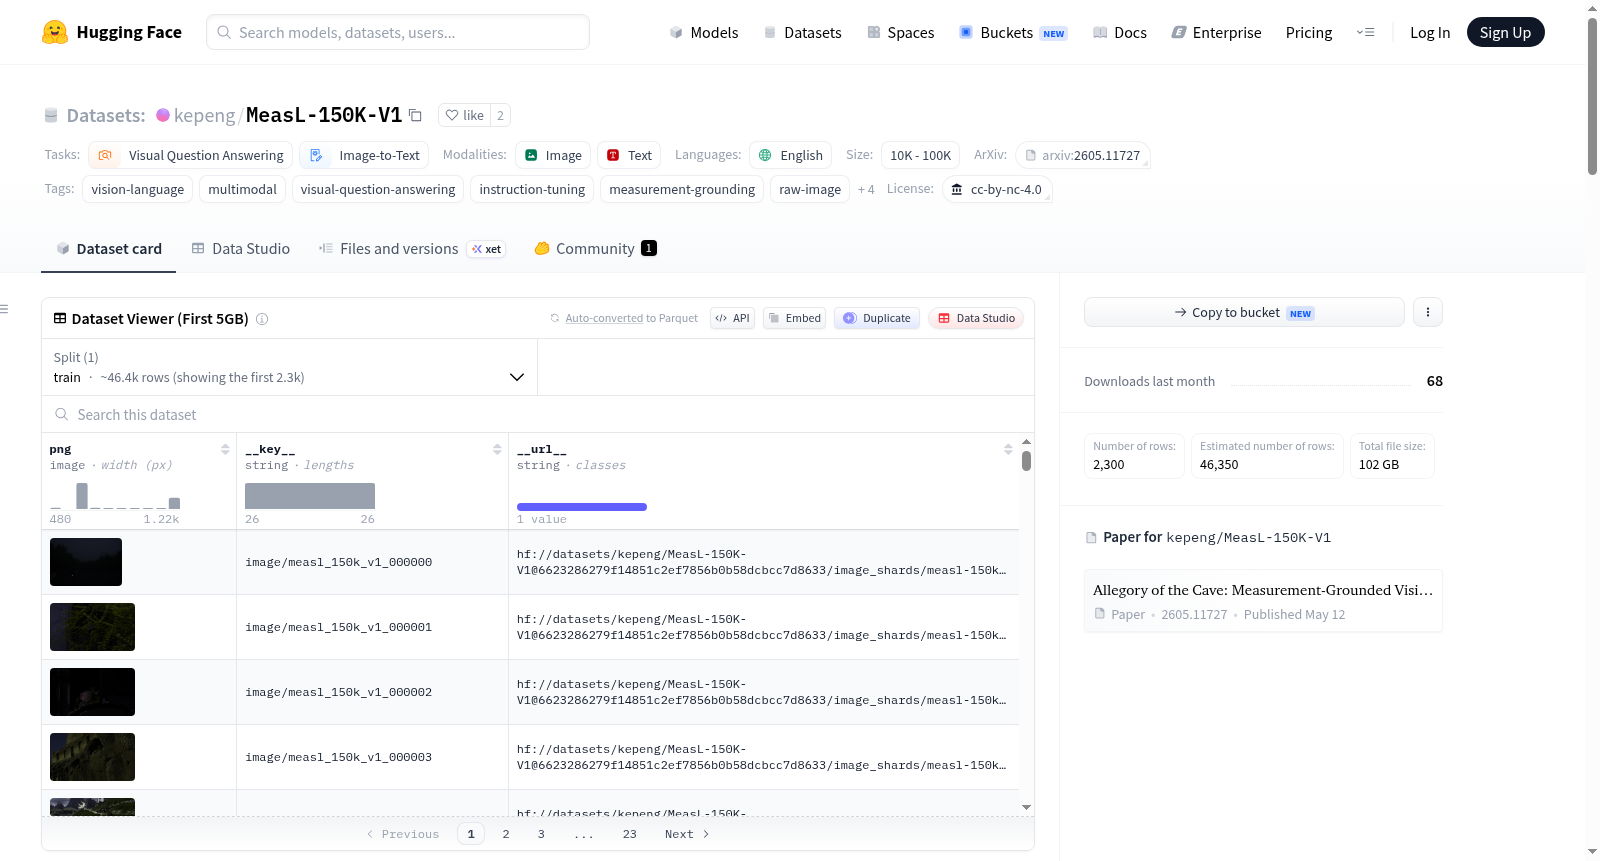
MeasL-150K-V1是官方PRSIMVL指令调优语料库,用于测量基础视觉推理。它与MeasL-Bench-V1评估协议对齐,并发布用于可重复的非商业研究。数据集包含152,517个指令调优示例和48,000个发布图像文件,主要用于多模态监督微调(SFT),以支持测量XYZ和元数据基础推理。该语料库已去除了与MeasL-Bench-V1的严格基准重叠,确保在指令调优中的可重复性,而非用于基准评估。数据集基于约700K自动注释候选构建,经过质量评分后保留518,433条记录,最终平衡了来源和问题结构,并打包为发布本地图像。

MeasL-150K-V1 is the official PRSIMVL instruction-tuning corpus for measurement-grounded visual reasoning. It is aligned with the MeasL-Bench-V1 evaluation protocol and released for reproducible non-commercial research. The dataset contains 152,517 instruction-tuning examples and 48,000 release image files, primarily used for multimodal SFT for Meas.-XYZ and metadata-grounded reasoning. It is decontaminated against MeasL-Bench-V1, intended for reproducible instruction tuning, not benchmark evaluation. The corpus was built from approximately 700K auto-annotated candidates, with 518,433 records after quality scoring, and the final examples were balanced by source and question structure, packaged with release-local images.
提供机构:
kepeng
搜集汇总
数据集介绍
kepeng/MeasL-150K-V1 数据集图片
构建方式
MeasL-150K-V1数据集作为PRSIMVL项目官方发布的指令微调语料,专为基于测量锚定的视觉推理任务而构建。其构建流程始于对约70万条自动标注候选样本的筛选,经质量评分后保留518,433条记录,最终通过平衡数据来源与问题结构,精炼为152,517个高质量训练实例。为确保数据纯净性,所有样本均经过基准去污处理,以剔除与评估基准MeasL-Bench-V1的重叠内容。数据以JSONL格式提供,每条记录包含符合多模态对话规范的提示与目标响应,以及指向原始图像路径的索引信息。图像文件以未压缩的tar分片形式存储,每片容纳5000张,便于跨平台存取与实验复现。
使用方法
使用MeasL-150K-V1数据集需先通过Hugging Face仓库获取资源,包括主JSONL文件与图像tar分片。推荐在项目根目录下运行下载命令,将数据存放至指定目录后,通过循环解压各tar分片释放图像至`image/`文件夹。若需独立使用数据集,可创建符号链接`training_data/image`指向解压后的图像目录,以确保JSONL中的相对路径正确解析。数据集注册了两个别名`MEASL/TRAIN_150K_V1`与`MEASL/TRAIN_150K_V1_EXTRA`,用于在训练配置中便捷引用。用户可参考`configs/qwen3_vl_150k_llmmeta_vit_proxy/`下的启动脚本进行模型微调,并鼓励在扩展或修改后发布新语义版本,如MeasL-150K-V2。
背景与挑战
背景概述
在视觉与语言多模态研究领域,将物理测量信息与视觉推理深度融合是近年来的重要方向,旨在使模型具备对图像中物体尺寸、比例等量化属性的精确理解能力。针对这一前沿问题,由项目团队于2025年发布的MeasL-150K-V1数据集,由Kepeng Xu等研究人员依托PRSIMVL项目构建,核心研究问题是推动多模态大模型在测量基准下的指令微调与推理能力。该数据集包含152,517条精心标注的指令微调样本和48,000张原始图像,基于约70万条自动标注候选样本经过质量筛选与平衡处理而成,并与MeasL-Bench-V1评估基准严格去污,为可重复的非商业研究提供了高质量训练资源,其相关论文发表于arXiv(2605.11727),对多模态测量推理领域具有重要引领作用。
当前挑战
该数据集所解决的领域问题挑战在于,现有视觉语言模型普遍缺乏对物体尺寸、绝对空间度量等精确测量信息的感知与推理能力,难以在真实应用场景中完成如“该物体宽度是否超过30厘米”等受测量约束的视觉问答任务。此外,数据集构建过程中面临多重挑战:从约70万条自动标注候选中经质量评分筛选至约51.8万条,再平衡至最终的15.2万条,需兼顾数据多样性、来源均衡性与标注一致性;包装发布时需将4.8万张图像分割为多个tar包,以规避HuggingFace平台单目录文件数量限制,并确保路径解析的可靠性;同时,必须实施严格的基准去污策略,防止训练数据与评测集重叠,保证模型评估的公正性。
常用场景
经典使用场景
在视觉语言理解领域,测量驱动的视觉推理始终是一块亟待开垦的沃土。MeasL-150K-V1作为PRSIMVL项目的核心指令微调语料库,专为训练多模态大语言模型在原始图像或元数据条件下的测量推理能力而设计。该数据集包含超过15万条高质量指令样本,每一个样本都融合了视觉图像与测量相关的对话结构,使模型能够学习理解物体尺寸、空间距离、比例关系等量化信息。经典的使用方式是将其作为多模态监督微调(SFT)的训练基准,研究者通过加载这批样本对主流视觉语言模型进行参数更新,从而显著提升模型在测量类视觉问答任务上的表现。这一数据集的出现,填补了传统视觉问答数据集在物理量感知与度量理解层面的空白,为精细化视觉推理研究提供了坚实的语料支撑。
解决学术问题
长期以来,多模态大模型在常识问答与场景描述上表现惊艳,却在涉及真实物理尺度的测量推断任务中暴露出严重短板,例如无法准确判断两棵树的相对高度或一张桌子的实际宽度。MeasL-150K-V1的提出系统性地回应了这一学术困境,它通过构建大规模、去污染、能覆盖多种提问结构的测量指令数据集,使模型得以在训练过程中建立视觉特征与度量语义之间的牢固映射。该数据集解决了两个核心学术问题:其一,如何消除视觉语言模型在测量推理中的系统性偏差,让模型学会从原始图像中提取可量化的空间信息;其二,如何设计去污染的训练与评测分离策略,确保模型能力的提升能被公正而可重复地评估。正因如此,MeasL-150K-V1在视觉语言领域的度量理解分支中扮演了奠基性角色,引领了多模态模型从感知走向量化的学术潮流。
实际应用
在工业与生活场景中,能够基于图像自动推断物体尺寸与空间关系的智能系统具有广阔的应用前景。MeasL-150K-V1所赋能的多模态模型,可被部署于智能家居的自动化测量估测模块,例如通过一张厨房照片估算水槽宽度或冰箱容积;亦可用于辅助医学影像分析,根据照片中解剖标记的尺度推断病灶大小。在电商领域,模型可依据用户上传的商品实拍图,自动估算衣物的肩宽或鞋子的长度,从而帮助消费者匹配尺码。此外,建筑与室内设计行业能够借助该数据集训练的模型,从施工现场图片中判断墙体间距或管道长度,降低人工测量成本与误差。这些实际应用都得益于MeasL-150K-V1所培养的模型对测量信号的敏感性与泛化能力,使得视觉理解从“图中有什么”升级为“图中东西有多大”。
数据集最近研究
最新研究方向
MeasL-150K-V1作为PRSIMVL项目的重要组成部分,专注于测量基视觉推理这一前沿方向,旨在通过大规模指令微调数据集推动多模态大模型在物理世界精确感知与度量理解能力的突破。该数据集围绕152,517个精心构建的指令微调样本与48,000张原始图像展开,与MeasL-Bench-V1评估基准严格去污染,确保研究的可复现性。在视觉语言模型向精细化、可量化认知演进的浪潮中,MeasL-150K-V1填补了现有数据集在空间测量、尺度感知与物理属性量化方面的空白,为构建能够真正理解图像中几何与物理关系的高级AI系统奠定了关键数据基础,其影响辐射至智能机器人、自动驾驶、医学影像分析等需要精准视觉度量的应用领域。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

