遇见数据集

github_fetch_huggingface_terminal_9083-legal-abstracts

收藏
Hugging Face2026-08-24 更新2026-08-25 收录
官方服务:

资源简介:

Legal Rulings Abstracts 是一个编译文本数据集,旨在将美国联邦法院裁决的摘要与讨论这些裁决的学术摘要进行配对。该数据集由 NovaLake 数据平台团队从两个公开来源数据集(Court Rulings Corpus 和 Academic Abstracts Archive)整合而成。数据集采用 CC BY-NC 4.0 许可证,仅限非商业研究和教育用途。数据内容涵盖法院裁决摘要和对应的学术摘要,适用于法律文本关联分析、摘要匹配、跨领域信息检索等任务。

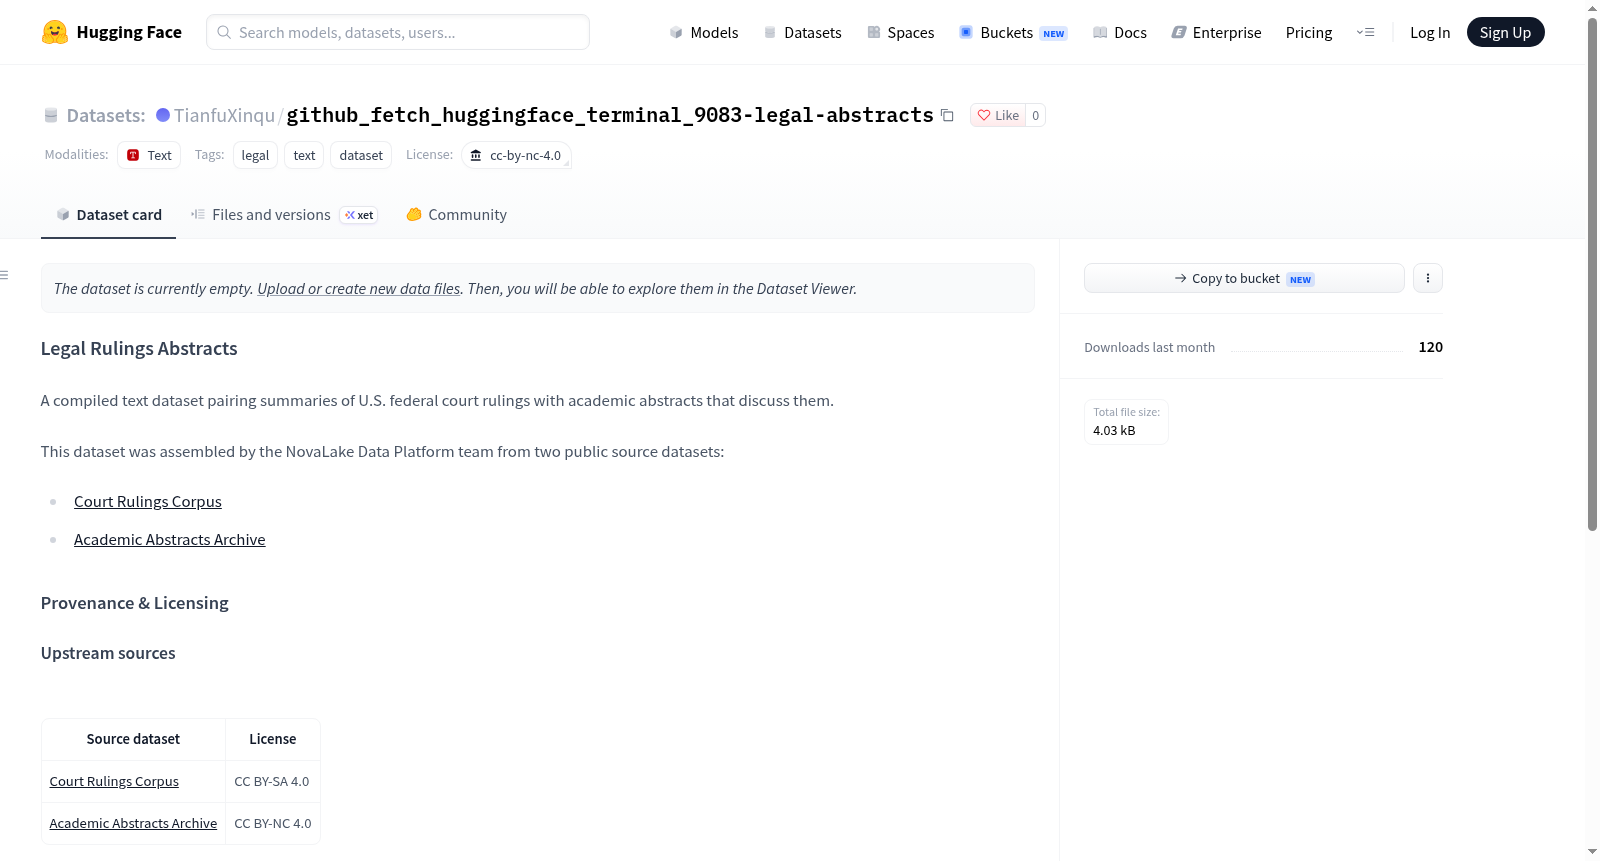
Legal Rulings Abstracts is a compiled text dataset designed to pair abstracts of U.S. federal court rulings with academic abstracts discussing those rulings. The dataset was assembled by the NovaLake data platform team from two publicly available datasets (Court Rulings Corpus and Academic Abstracts Archive). It is licensed under CC BY-NC 4.0, restricted to non-commercial research and educational use. The data includes court ruling abstracts and corresponding academic abstracts, suitable for legal text correlation analysis, abstract matching, cross-domain information retrieval, and other tasks.

创建时间:
2026-08-14
原始信息汇总

Legal Rulings Abstracts 数据集概述

数据集简介

Legal Rulings Abstracts 是一个文本数据集,将美国联邦法院裁决的摘要与讨论这些裁决的学术论文摘要进行配对组合而成。该数据集由 NovaLake 数据平台团队从两个公开源数据集汇编而来。

数据来源

数据集由以下两个上游来源组合而成:

  • Court Rulings Corpus(法院裁决语料库):提供美国联邦法院裁决摘要,采用 CC BY-SA 4.0 许可协议
  • Academic Abstracts Archive(学术摘要档案库):提供相关学术论文摘要,采用 CC BY-NC 4.0 许可协议

许可信息

有效许可

CC BY-NC 4.0(知识共享署名-非商业使用 4.0 国际许可协议)

由于上游来源中的 Academic Abstracts Archive 以 CC BY-NC 4.0 协议发布,根据 NovaLake 治理规则,任何包含非商业(NC)许可上游来源的派生数据集,其整体使用性质须视为非商业用途。

商业使用限制

不允许商业使用。 该组合数据集不得用于商业目的,仅可用于非商业研究和教育用途。

数据集标签

  • 许可协议:cc-by-nc-4.0
  • 领域标签:法律(legal)、文本(text)、数据集(dataset)
搜集汇总
数据集介绍
github_fetch_huggingface_terminal_9083-legal-abstracts 数据集图片
构建方式
本数据集根植于法律信息学与跨学科文本挖掘的迫切需求,通过整合美国联邦法院判决摘要与相关学术论文摘要,构建了一个融合司法实践与学术论述的双语料资源。其构建路径依托NovaLake数据平台,系统性地汇集了两个公开源数据集:法院判决语料库(Court Rulings Corpus)与学术摘要档案(Academic Abstracts Archive)。在组装过程中,团队遵循严格的溯源与许可合规原则,依据上游源许可的兼容性,将判决摘要与讨论该判决的学术摘要进行配对,形成具有内在逻辑关联的文本对。该构建方式不仅保留了原始语料的独立性,还通过配对机制揭示了司法裁决与学术评论之间的互动关系,为法律文本的跨领域研究提供了结构化基础。
特点
该数据集的核心特征在于其跨域配对结构与明确的许可约束。每一条数据实例均由美国联邦法院判决摘要与对应的学术论文摘要组成,形成法律实务与学术分析之间的直接映射,便于研究者探索司法论证与学术批判之间的语义关联。数据集覆盖法律与学术文本两大领域,兼具专业性与跨学科性,适用于法律论证挖掘、摘要生成、文本匹配等任务。在许可方面,由于上游学术摘要档案采用CC BY-NC 4.0许可,本数据集整体遵循非商业性使用原则,仅限非商业研究与教育用途,体现了对数据源许可的严格尊重与合规治理。
使用方法
使用者可通过HuggingFace平台直接加载本数据集,借助datasets库或类似工具进行访问与解析。数据以文本对形式组织,每条样本包含判决摘要与学术摘要两个字段,便于直接用于监督学习或对比学习任务。在应用层面,研究者可将其用于训练法律文本摘要模型、评估判决与学术文献的语义相似度,或构建法律问答系统的检索模块。由于许可限制,所有使用行为须严格限定于非商业目的,包括学术研究、教学实验及非营利性项目。使用时应明确标注数据来源与许可信息,并在衍生作品中保留原始署名,以确保合规性与学术诚信。
背景与挑战
背景概述
法律文本的自动化理解与跨文档关联始终是计算法学与自然语言处理交叉领域的核心议题。NovaLake数据平台团队于近年构建的Legal Rulings Abstracts数据集,将美国联邦法院裁决摘要与探讨这些裁决的学术论文摘要进行配对整合,旨在为法律文本的语义对齐、跨域检索及判例影响力分析提供结构化资源。该数据集融合了司法实践与学术研究两个维度的文本,回应了法律信息学中判例与学术文献之间缺乏显式关联的空白,对法律检索系统、判例引用分析及法律论证挖掘等研究方向具有基础性支撑意义。
当前挑战
该数据集所面对的核心领域挑战在于法律文本与学术文本之间的语义鸿沟与体裁异质性,前者以判决要旨和司法推理为主,后者以研究问题、方法论述与批判性评价为特征,二者在词汇分布、论证结构与信息粒度上存在显著差异,使得跨域对齐与联合建模尤为困难。构建过程中,数据来源的许可兼容性构成另一重挑战,上游学术摘要数据集采用非商业许可,导致衍生数据集在治理层面被整体限定为非商业用途,限制了其应用边界。此外,配对关系的判定标准与覆盖完整性亦影响数据集的规模与代表性。
常用场景
经典使用场景
在法律信息学与计算语言学交叉领域,法律判决摘要与学术文献的配对数据长期稀缺。该数据集将美国联邦法院判决摘要与探讨这些判决的学术论文摘要进行配对,为法律文本的语义对齐研究提供了结构化资源。其经典使用场景在于训练和评估跨域文本匹配模型,例如判断某一学术摘要是否与特定判决相关,或生成判决的学术解读。研究者可利用该数据集进行法律论证挖掘、摘要生成以及跨文档推理任务,推动法律人工智能从单一文本处理向多源知识融合演进。
实际应用
在法律实务与教育场景中,该数据集可支撑智能法律检索系统,帮助律师或法官快速定位与特定判决相关的学术评述,辅助判例分析与论证构建。同时,它可用于构建法律学术推荐引擎,为研究人员推送与近期判决相关的文献摘要。在法律教育领域,该数据集能驱动案例教学工具,自动关联判决与学术解读,提升教学效率。此外,非商业研究机构可利用其进行法律政策评估与司法趋势监测。
衍生相关工作
该数据集衍生了多项经典工作,包括基于对比学习的法律文本匹配模型、判决摘要与学术摘要的联合嵌入方法,以及跨域主题建模框架。部分研究进一步利用该数据集训练生成式模型,自动撰写判决的学术评论摘要。在评估方面,它催生了法律跨文档推理基准测试,推动了法律领域预训练语言模型的微调与评测。这些工作共同拓展了法律人工智能在知识融合与文本生成方面的边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务