Fake News Dataset
收藏资源简介:
该数据集源自Kaggle竞赛,包含用于训练和测试假新闻检测模型的文章。数据集包括train.csv和test.csv文件,其中train.csv包含文章的唯一ID、标题、作者、文本和标签(1表示假新闻,0表示可靠新闻),而test.csv文件结构类似但不包含标签属性。
This dataset originates from a Kaggle competition, containing articles intended for training and testing fake news detection models. The dataset includes two files: train.csv and test.csv. The train.csv file contains the unique ID, title, author, text content, and label of each article, where 1 represents fake news and 0 represents reliable news. The test.csv file has a similar structure but does not include the label attribute.
虚假新闻检测器数据集
描述
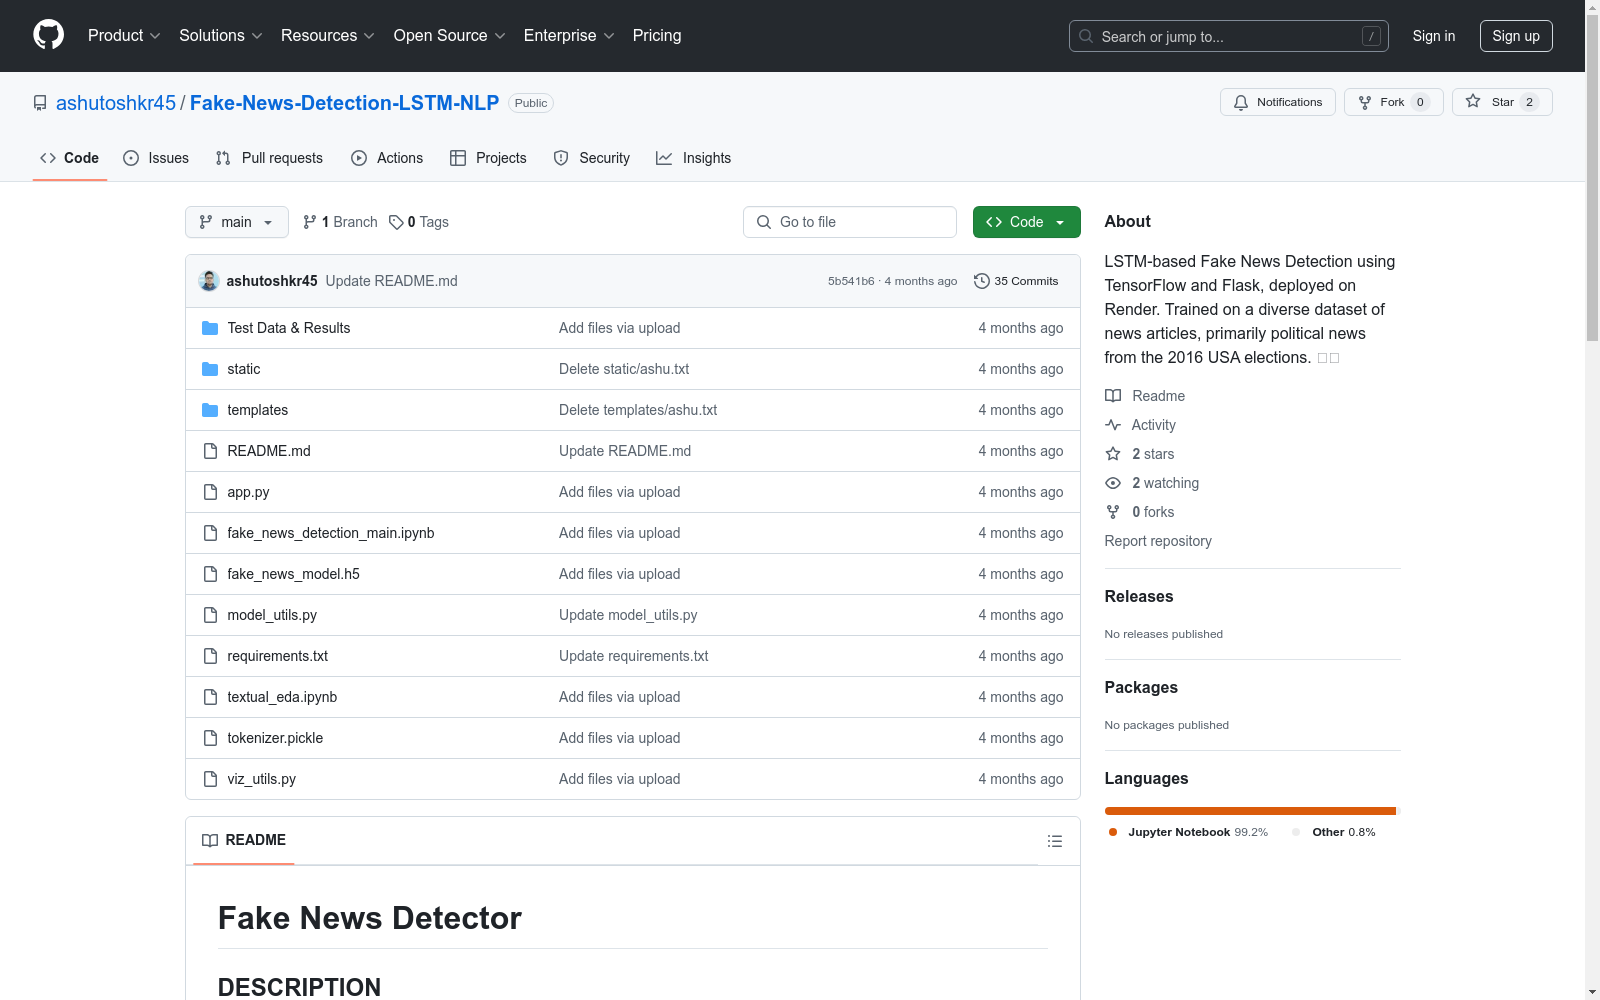
该项目旨在使用深度学习模型检测虚假新闻,主要关注政治新闻,特别是2016年美国大选期间的新闻。模型处理文章的标题、作者和文本,将它们分类为可靠或虚假。
数据集
数据集来源于Kaggle竞赛,包含以下文件:
- train.csv: 包含以下属性的文章:
id: 新闻文章的唯一IDtitle: 新闻文章的标题author: 新闻文章的作者text: 文章的文本(可能不完整)label: 标签,指示文章是否可能不可靠(1表示虚假,0表示可靠)
- test.csv: 类似于
train.csv,但没有label属性。
技术方面
数据可视化和探索
textual_eda.ipynb: 执行探索性数据分析,可视化标签分布、文章长度、作者统计和词云。
模型构建和训练
fake_news_detection_main.ipynb: 涉及文本预处理、分词、序列填充和模型创建。使用词汇量5000,序列长度30,嵌入向量维度50。
模型部署
- Flask App: 使用Flask、HTML和CSS构建的Web应用。处理用户输入,预测新闻文章的可靠性并显示结果。
结果
模型在分割的测试集上达到了99%的准确率,证明了其在检测虚假新闻方面的有效性。
结论
该项目成功展示了一个高准确率的虚假新闻检测模型。Jupyter笔记本详细记录了数据处理和模型开发阶段。test.csv文件也包含在仓库中,模型在该数据上表现更好,因为数据域相似。