
遇见数据集

mdroth/huggingface-course_section-5_zst

收藏
Hugging Face2023-07-29 更新2024-03-04 收录
官方服务:

资源简介:

该数据集主要用于Hugging Face课程第5节中,作为The Pile数据集的子数据集的替代品。数据集来源包括PubMed-200k-RTC和LegalText-classification两个Kaggle数据集。用户无需从Kaggle下载这些数据集,可以直接通过提供的URL链接使用。

This dataset is primarily intended for use in the 5th session of the Hugging Face course, serving as a replacement for the subset of The Pile dataset. It is sourced from two Kaggle datasets: PubMed-200k-RTC and LegalText-classification. Users do not need to download these datasets from Kaggle and can directly utilize them via the provided URL links.

提供机构:
mdroth
原始信息汇总

数据集概述

数据集名称

  • 名称:section 5 zst datasets
  • 别名:Hugging Face course section 5 .zst datasets

许可协议

  • 协议:Apache-2.0

任务类别

  • 类别:text-classification

语言

  • 语言:en

数据来源

  • PubMed-200k-RTC: https://www.kaggle.com/datasets/matthewjansen/pubmed-200k-rtc/download?datasetVersionNumber=5
  • LegalText-classification: https://www.kaggle.com/datasets/shivamb/legal-citation-text-classification/download?datasetVersionNumber=1

使用方法

  • 加载数据集的Python代码示例: python import zstandard from datasets import load_dataset url = "https://huggingface.co/datasets/mdroth/PubMed-200k-RTC/resolve/main/data/LegalText-classification_train_min.jsonl.zst" load_dataset("json", data_files=url, split="train")

  • 可用数据文件链接:

    • LegalText-classification_train.jsonl.zst: https://huggingface.co/datasets/mdroth/PubMed-200k-RTC/resolve/main/data/LegalText-classification_train.jsonl.zst
    • LegalText-classification_train_min.jsonl.zst: https://huggingface.co/datasets/mdroth/PubMed-200k-RTC/resolve/main/data/LegalText-classification_train_min.jsonl.zst
    • PubMed-200k-RTC_train.jsonl.zst: https://huggingface.co/datasets/mdroth/PubMed-200k-RTC/resolve/main/data/PubMed-200k-RTC_train.jsonl.zst
    • PubMed-200k-RTC_train_min.jsonl.zst: https://huggingface.co/datasets/mdroth/PubMed-200k-RTC/resolve/main/data/PubMed-200k-RTC_train_min.jsonl.zst
搜集汇总
数据集介绍
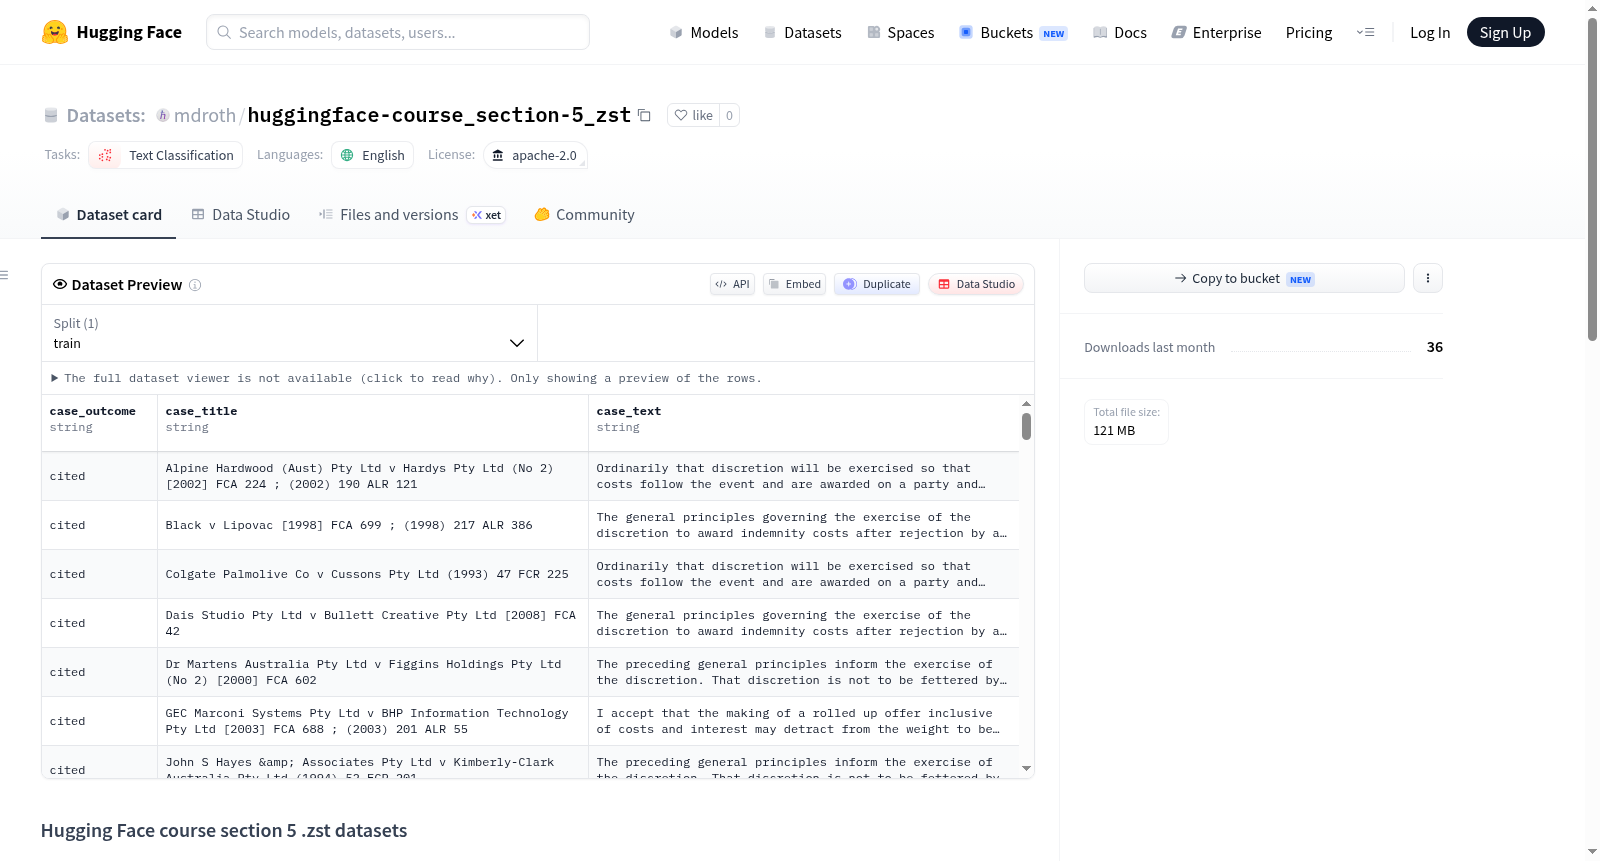
mdroth/huggingface-course_section-5_zst 数据集图片
构建方式
该数据集隶属于Hugging Face课程第五章节,旨在作为EleutherAI的The Pile数据集子集的即插即用替代品。其数据源源自Kaggle平台上的两个经典文本分类数据集:PubMed-200k-RTC与LegalText-classification。构建过程中,原始数据经过标准化预处理,并采用Zstandard(zst)压缩算法进行高效存储,最终以JSON Lines格式封装为压缩文件,确保数据在保持原始语义的同时,实现存储空间与加载效率的优化。
使用方法
使用该数据集时,用户需借助Python环境中的zstandard与datasets库。通过load_dataset函数,指定数据格式为'json',并传入对应的zst文件URL作为data_files参数,即可实现高效加载。例如,加载LegalText-classification的精简训练集时,直接调用load_dataset('json', data_files='...LegalText-classification_train_min.jsonl.zst', split='train')。此方法免去了本地下载与预处理的繁琐步骤,实现了数据集的即用即取,极大提升了开发与实验的便捷性。
背景与挑战
背景概述
在自然语言处理领域,大规模、高质量的文本分类数据集是推动模型性能提升的关键资源。该数据集由研究者mdroth创建,旨在为HuggingFace课程第5节提供替代The Pile子数据集的便捷方案。其核心研究问题在于如何高效整合来自不同领域的文本数据,以支持文本分类任务的训练与评估。数据集融合了PubMed-200k-RTC(生物医学文献)与LegalText-classification(法律文本)两大来源,覆盖了专业术语密集、结构复杂的科学和法律文本,为跨领域文本分类研究提供了宝贵的基础资源。其影响力体现在简化了数据处理流程,使学习者能够直接通过HuggingFace Datasets库加载压缩后的JSONL文件,从而更专注于模型构建与实验设计。
当前挑战
该数据集所解决的领域问题包括生物医学和法律文本的自动分类,这两大领域均面临术语歧义性高、类别不平衡及长文本依赖等共性挑战。在构建过程中,研究者需应对多重技术难题:首先,原始数据来源于Kaggle平台,需通过账户认证方可下载,增加了数据获取的复杂性;其次,数据以zst压缩格式存储,要求使用者熟悉zstandard库的解压操作,提升了使用门槛;此外,数据集仅提供训练集划分,缺乏标准化的验证与测试集,可能导致模型评估的偏差;最后,来自不同领域的文本在格式、长度和标注规范上存在显著差异,如何在不破坏数据完整性的前提下实现统一加载与预处理,成为构建过程中的关键挑战。
常用场景
经典使用场景
该数据集的核心用途在于为文本分类任务提供高效、可复现的训练数据,尤其适用于Hugging Face课程第五章节中关于大规模预训练语言模型微调的教学实践。其设计初衷是作为The Pile数据集子集的即插即用替代品,使得学习者无需经历繁琐的原始数据下载与预处理流程,即可直接通过简洁的代码接口加载经过压缩的JSON行格式数据,从而专注于模型架构与训练策略的探索。这种无缝集成的特性,使其成为自然语言处理入门与进阶实验中的理想基准数据源。
解决学术问题
在学术研究中,该数据集有效解决了大规模语料库获取与预处理的高门槛问题,特别是针对PubMed生物医学文献和LegalText法律文书这两类专业领域。传统上,研究者需要面对异构数据源的清洗、格式统一及存储优化等挑战,而该数据集通过提供标准化、压缩高效的.zst格式,大幅降低了数据管理的复杂度。其核心贡献在于为文本分类领域的可重复性研究提供了便捷的基石,使得对比不同模型在医学与法律文本上的表现成为可能,进而推动跨领域迁移学习与领域自适应方法的发展。
实际应用
在实际应用中,该数据集可被快速部署于医疗文献自动分类系统与法律案例智能检索平台。例如,在生物医学领域,研究人员可利用PubMed-200k-RTC子集训练能够精准识别临床试验报告类别的模型,辅助学术文献的自动化归档与知识图谱构建;在法律领域,LegalText-classification子集则支持对司法文书进行主题或引用关系的自动标注,提升法律科技产品的文档处理效率。此外,其轻量化的压缩格式尤其适合资源受限的云端或边缘计算环境,降低了部署成本。
数据集最近研究
最新研究方向
该数据集聚焦于文本分类任务中的零样本学习(Zero-Shot Learning)前沿方向,特别是通过压缩与优化大规模语料库(如The Pile)的子集,以适配HuggingFace课程第五章节的教学与实验需求。其核心创新在于提供经zstandard压缩的PubMed-200k-RTC与LegalText-classification数据,支持高效的JSON Lines格式加载,从而降低存储与传输开销。这一方向与当前自然语言处理领域对轻量化、可复现研究的热点紧密相连,尤其在法律文本与生物医学文献的分类场景中,推动了零样本迁移学习与多任务泛化能力的实证探索。通过简化数据访问流程,该数据集为研究者在有限计算资源下验证分类模型在未见类别上的表现提供了基准,对促进可扩展的文本理解技术发展具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

