遇见数据集

lenatr99/Slovene_SuperGLUE_COPA

收藏
Hugging Face2024-05-03 更新2024-06-12 收录
官方服务:

资源简介:

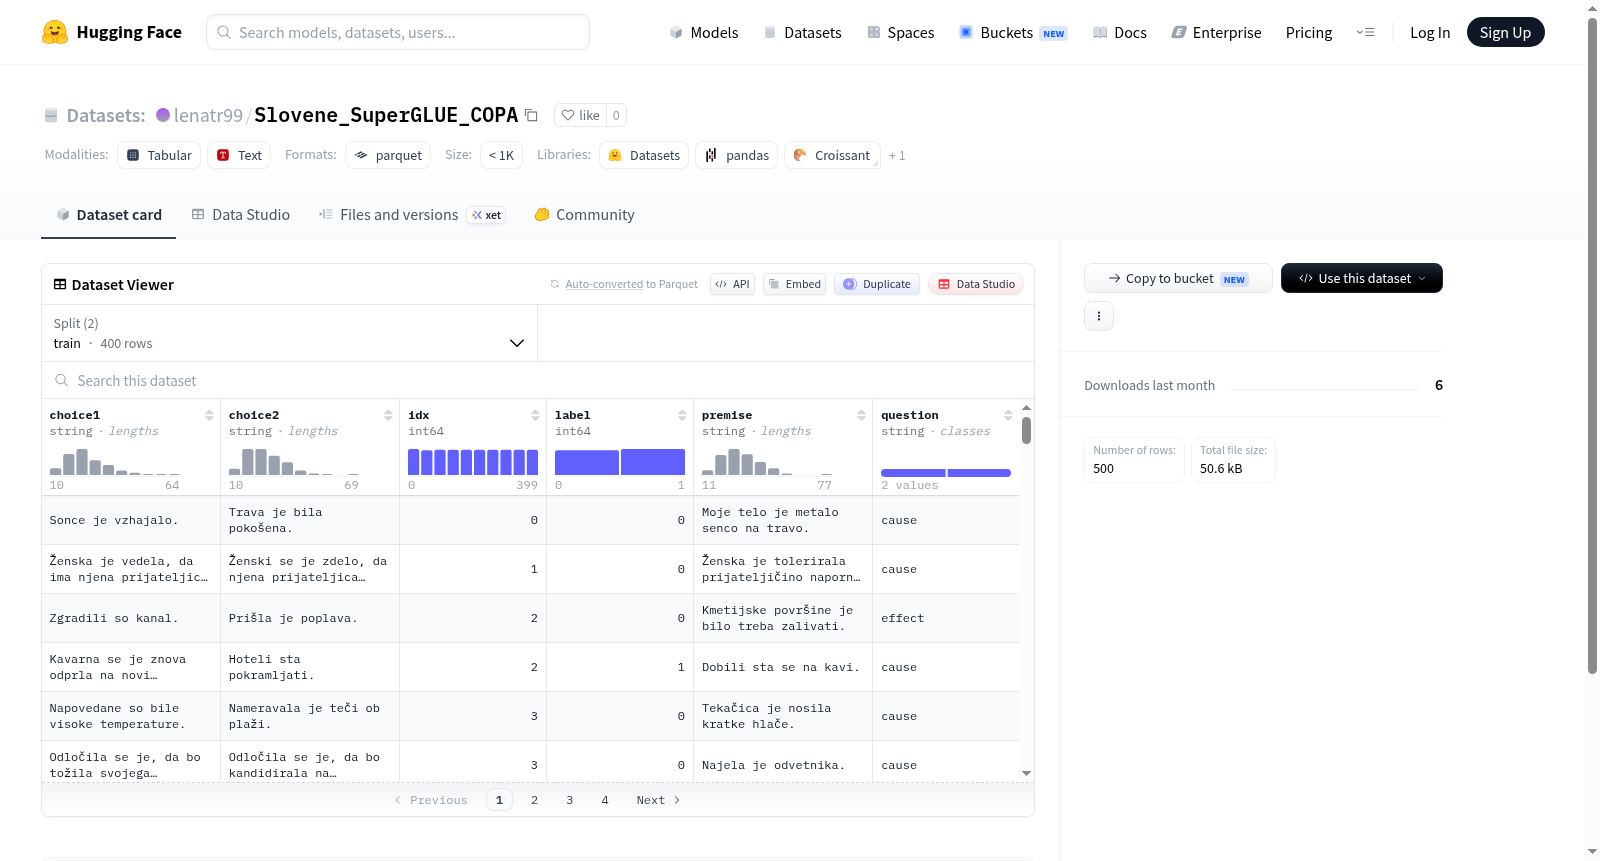
--- dataset_info: features: - name: choice1 dtype: string - name: choice2 dtype: string - name: idx dtype: int64 - name: label dtype: int64 - name: premise dtype: string - name: question dtype: string splits: - name: train num_bytes: 49638 num_examples: 400 - name: eval num_bytes: 13005 num_examples: 100 download_size: 47801 dataset_size: 62643 configs: - config_name: default data_files: - split: train path: data/train-* - split: eval path: data/eval-* ---

数据集信息: 特征字段: - 字段名称:选项1(choice1),数据类型:字符串(string) - 字段名称:选项2(choice2),数据类型:字符串 - 字段名称:索引(idx),数据类型:64位整数(int64) - 字段名称:标签(label),数据类型:64位整数 - 字段名称:前提(premise),数据类型:字符串 - 字段名称:问题(question),数据类型:字符串 数据集划分: - 划分名称:训练集(train),字节占用量:49638,样本数量:400 - 划分名称:验证集(eval),字节占用量:13005,样本数量:100 下载总大小:47801 数据集总占用大小:62643 配置项: - 配置名称:默认配置(default),数据文件: - 训练集(train)划分:路径为 data/train-* - 验证集(eval)划分:路径为 data/eval-*

提供机构:
lenatr99
原始信息汇总

数据集概述

数据集特征

  • choice1: 数据类型为字符串(string)
  • choice2: 数据类型为字符串(string)
  • idx: 数据类型为整数(int64)
  • label: 数据类型为整数(int64)
  • premise: 数据类型为字符串(string)
  • question: 数据类型为字符串(string)

数据集分割

  • 训练集(train):
    • 示例数量: 400
    • 数据大小: 49638字节
  • 评估集(eval):
    • 示例数量: 100
    • 数据大小: 13005字节

数据集大小

  • 下载大小: 47801字节
  • 数据集总大小: 62643字节

数据文件配置

  • 默认配置(default):
    • 训练集路径: data/train-*
    • 评估集路径: data/eval-*
搜集汇总
数据集介绍
lenatr99/Slovene_SuperGLUE_COPA 数据集图片
构建方式
该数据集名为Slovene_SuperGLUE_COPA,是面向斯洛文尼亚语自然语言推理任务构建的基准数据集。其构建基于SuperGLUE基准中的COPA(Choice of Plausible Alternatives)任务,通过将原始英文语料进行专业翻译与本地化适配,形成涵盖因果推理场景的斯洛文尼亚语版本。数据集包含前提句(premise)与两个候选选项(choice1和choice2),并由问题字段(question)明确推理方向,标签字段(label)标注正确答案。整体划分为训练集(400条)与评估集(100条),以平衡模型学习与性能验证的需求。
使用方法
数据集以HuggingFace Datasets格式提供,支持通过`load_dataset`函数直接调用,默认配置名为'default'。用户可指定`split`参数加载训练集或评估集,数据以字典形式包含choice1、choice2、idx、label、premise和question字段。适用于训练因果推理模型或评估预训练语言模型在斯洛文尼亚语上的推理能力。推荐将数据集与SuperGLUE评估流程对齐,使用准确率作为主要指标进行模型性能度量。
背景与挑战
背景概述
在自然语言理解领域,常识推理任务长期被视为评估语言模型语义理解能力的试金石,而COPA(Choice of Plausible Alternatives)作为其中一项经典基准,聚焦于因果与条件关系的推理判断。lenatr99/Slovene_SuperGLUE_COPA数据集诞生于斯洛文尼亚语自然语言处理研究逐步深化的背景下,由相关研究团队基于SuperGLUE通用评测框架构建,旨在将COPA任务拓展至低资源语言场景。该数据集包含400条训练样本与100条评估样本,每项样本提供前提、问题及两个候选答案,要求模型从语义连贯性出发选择合理选项。其发布填补了斯洛文尼亚语在结构化常识推理评测上的空白,为多语言NLP模型的泛化能力验证提供了关键资源,尤其推动了斯拉夫语族在语言理解基准上的可比性研究。
当前挑战
该数据集面临的首要挑战在于斯洛文尼亚语的语料稀缺性,仅500条样本的规模难以支撑深度学习模型的有效训练,易导致过拟合或泛化能力不足。其次,COPA任务本身对因果推理与常识知识的依赖,在低资源语言中因缺乏大规模预训练语料而加剧难度,模型需在有限数据中捕捉隐含的语义关联与逻辑结构。构建过程中,翻译或标注人员需兼顾斯洛文尼亚语的形态丰富性与英语原任务的语义保真度,确保候选答案的歧义控制与标签一致性,这要求语言学专家深度介入以避免文化语境偏差。此外,数据集仅含训练与评估两划分,缺少独立验证集,限制了超参数调优与模型选择的可靠性,进一步提升了实际应用的复杂度。
常用场景
经典使用场景
在自然语言推理与常识因果推理的交叉领域中,lenatr99/Slovene_SuperGLUE_COPA数据集为斯洛文尼亚语的因果选择任务提供了标准化评测基准。该数据集源自SuperGLUE基准中的COPA(Choice of Plausible Alternatives)任务,每个样本包含一个前提(premise)与两个候选选项(choice1和choice2),模型需根据问题(question)类型(如因果或结果)从两个候选中选出更合理的一项。经典使用场景聚焦于评估多语言预训练模型在低资源语言上的因果推理能力,通过400条训练样本和100条测试样本的紧凑配置,为斯洛文尼亚语自然语言理解研究提供了稀缺的标注资源。
解决学术问题
该数据集着力解决斯洛文尼亚语在高级语义推理任务中缺乏高质量标注数据的学术困境。传统COPA任务主要集中于英语等资源丰富语言,而斯洛文尼亚语作为低资源语言,在因果推理、事件关系建模等核心自然语言理解问题上长期面临数据匮乏的瓶颈。通过提供结构化的因果选择任务,该数据集推动了多语言推理模型在斯拉夫语族上的泛化能力研究,验证了跨语言知识迁移的有效性,并为评估预训练语言模型在非英语场景下的常识推理表现提供了关键基准。
实际应用
在实际应用中,该数据集可支撑斯洛文尼亚语智能问答系统、对话代理与决策支持工具的因果推理模块开发。例如,在斯洛文尼亚语客服机器人中,模型需根据用户描述的事件前提推断合理的原因或结果,从而提供更精准的应答。此外,该数据集还可用于构建教育领域的自动推理评估工具,帮助非英语母语学习者训练因果逻辑思维,并推动斯洛文尼亚语在司法、医疗等专业场景下的文本理解与事件预测应用落地。
数据集最近研究
最新研究方向
在多语言自然语言理解与推理的浪潮中,斯洛文尼亚语作为低资源语言的代表,其因果推理能力评估正成为前沿焦点。lenatr99/Slovene_SuperGLUE_COPA数据集作为斯洛文尼亚语版本的COPA任务,聚焦于前提与候选结果之间的因果逻辑判断,为多语言预训练模型在巴尔干语系中的泛化表现提供了关键测试床。当前研究着力于探索该数据集在跨语言迁移学习中的有效性,特别是在零样本或少样本场景下,模型能否捕捉斯洛文尼亚语特有的语法与语义因果线索。这一方向不仅推动了低资源语言NLP的公平性发展,也为理解语言普遍性与特异性在因果推理中的交互作用提供了实证基础,其成果有望应用于多语言智能系统与区域语言技术生态的构建。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务