ddudek/nanochat-climbmix-annotated
收藏资源简介:
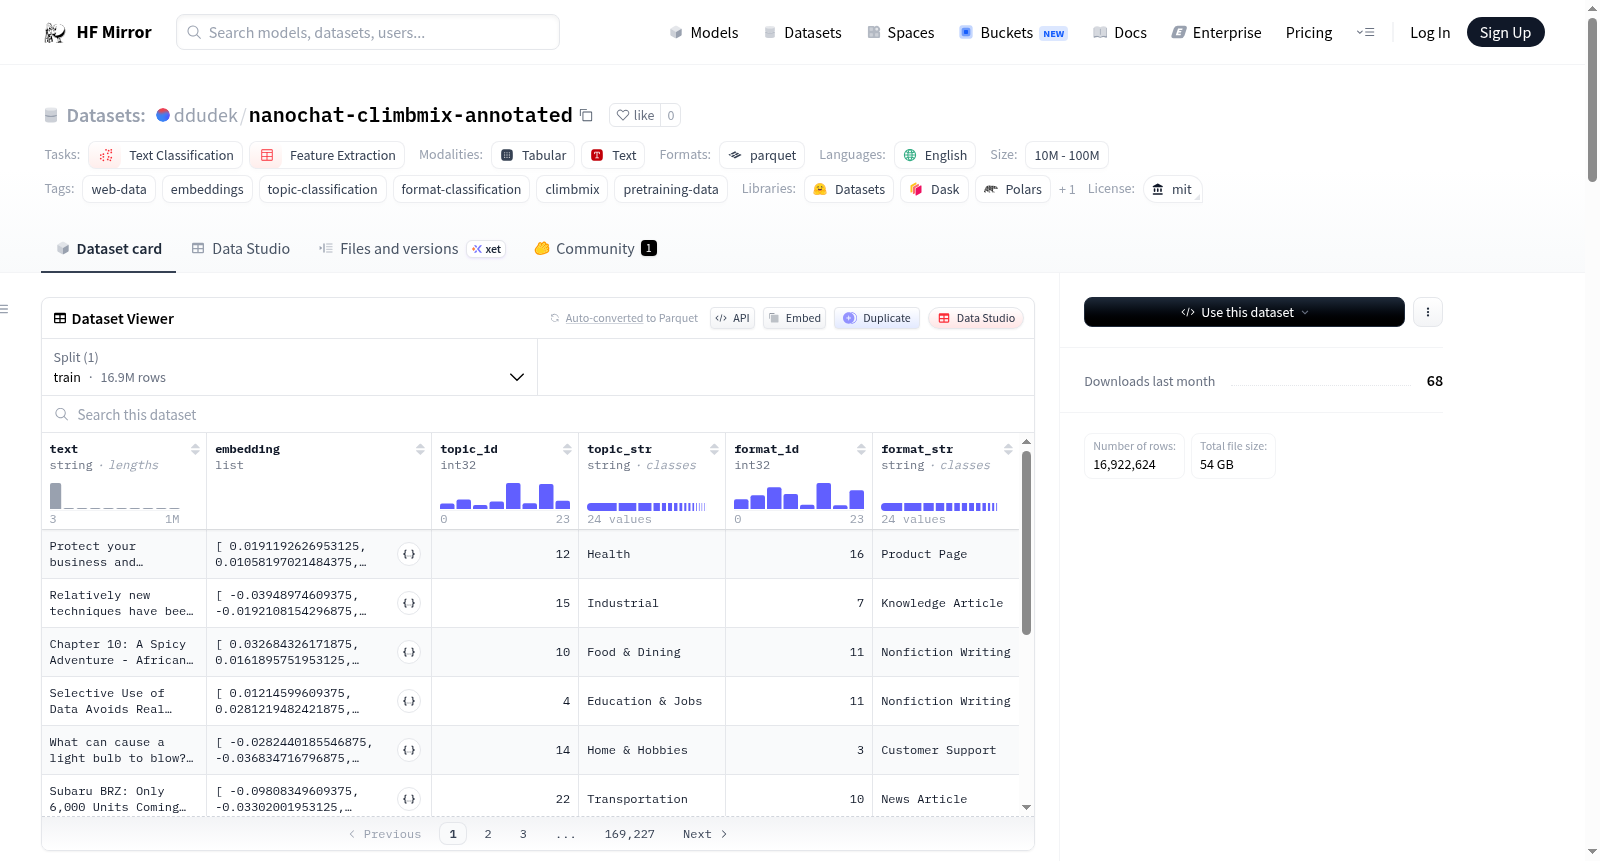
--- license: mit task_categories: - text-classification - feature-extraction language: - en tags: - web-data - embeddings - topic-classification - format-classification - climbmix - pretraining-data pretty_name: ClimbMix Topics & Formats size_categories: - 10M<n<100M configs: - config_name: default data_files: - split: train path: "shard_*.parquet" dataset_info: features: - name: text dtype: string - name: embedding sequence: float16 length: 768 - name: topic_id dtype: int32 - name: topic_str dtype: string - name: format_id dtype: int32 - name: format_str dtype: string splits: - name: train num_examples: 16922624 --- # Summary A 200 shards subset of `karpathy/climbmix-400b-shuffle` dataset (Nvidia ClimbMix) of web documents with added pre-computed embeddings and classified topics and formats. Parquet files keep the nanochat compatible format (row groups, 'text' column), so this can be used as a drop-in replacement of the Karpathy's mix in the nanochat project, where the additional metadata can be used in the code. ## Dataset Structure - **Size:** 200 parquet shards (~86K rows each, ~16.9M documents total) - **Columns:** - `text` — Raw document text - `embedding` — Pre-computed 768-dim dense embedding vector (float16) - `topic_id` — Numeric topic label (0–23) - `topic_str` — Human-readable topic (e.g., "Health", "Software Dev.", "Food & Dining") - `format_id` — Numeric format label (0–23) - `format_str` — Human-readable format (e.g., "News Article", "Academic Writing", "Product Page") ## Topics | ID | Label | |----|-------| | 0 | Adult | | 1 | Art & Design | | 2 | Software Dev. | | 3 | Crime & Law | | 4 | Education & Jobs | | 5 | Hardware | | 6 | Entertainment | | 7 | Social Life | | 8 | Fashion & Beauty | | 9 | Finance & Business | | 10 | Food & Dining | | 11 | Games | | 12 | Health | | 13 | History | | 14 | Home & Hobbies | | 15 | Industrial | | 16 | Literature | | 17 | Politics | | 18 | Religion | | 19 | Science & Tech. | | 20 | Software | | 21 | Sports & Fitness | | 22 | Transportation | | 23 | Travel | ## Formats | ID | Label | |----|-------| | 0 | Academic Writing | | 1 | Content Listing | | 2 | Creative Writing | | 3 | Customer Support | | 4 | Comment Section | | 5 | FAQ | | 6 | Truncated | | 7 | Knowledge Article | | 8 | Legal Notices | | 9 | Listicle | | 10 | News Article | | 11 | Nonfiction Writing | | 12 | About (Org.) | | 13 | News (Org.) | | 14 | About (Pers.) | | 15 | Personal Blog | | 16 | Product Page | | 17 | Q&A Forum | | 18 | Spam / Ads | | 19 | Structured Data | | 20 | Documentation | | 21 | Audio Transcript | | 22 | Tutorial | | 23 | User Review | ## Generation Details - **Embeddings:** Generated using `jinaai/jina-embeddings-v5-text-nano` with `task="clustering"` (768 dimensions, float16) - **Topic Classification:** `WebOrganizer/TopicClassifier-NoURL` - **Format Classification:** `WebOrganizer/FormatClassifier-NoURL` ## License MIT
许可证:MIT协议 任务类别: - 文本分类 - 特征提取 语言: - 英语 标签: - 网页数据 - 嵌入向量(embeddings) - 主题分类 - 格式分类 - climbmix - 预训练数据 展示名称:ClimbMix 主题与格式 样本数量区间:1000万 < n < 1亿 配置: - 配置名称:默认配置 数据文件: - 拆分集:训练集 路径:"shard_*.parquet" 数据集信息: 特征: - 名称:text,数据类型:字符串 - 名称:embedding,数据类型:float16序列,长度768 - 名称:topic_id,数据类型:int32 - 名称:topic_str,数据类型:字符串 - 名称:format_id,数据类型:int32 - 名称:format_str,数据类型:字符串 拆分集: - 名称:训练集,样本数量:16922624 --- # 概述 本数据集是`karpathy/climbmix-400b-shuffle`数据集(英伟达ClimbMix)的200分片子集,包含海量网页文档,并新增了预计算的嵌入向量以及分类后的主题与格式标签。Parquet文件保留了与nanochat兼容的格式(行组、`text`列),因此可直接替代Karpathy的原始混合数据集用于nanochat项目,其额外的元数据可在项目代码中直接调用。 ## 数据集结构 - **规模**:200个Parquet分片(每个分片约8.6万行,总计约1690万份文档) - **字段说明**: - `text`:原始文档文本 - `embedding`:预计算的768维稠密嵌入向量(float16格式) - `topic_id`:数值型主题标签(取值范围0–23) - `topic_str`:人类可读的主题名称(例如“健康”“软件开发”“美食与餐饮”) - `format_id`:数值型格式标签(取值范围0–23) - `format_str`:人类可读的格式类型(例如“新闻文章”“学术写作”“产品页面”) ## 主题分类标签 | 编号 | 标签名称 | |----|-------| | 0 | 成人内容 | | 1 | 艺术与设计 | | 2 | 软件开发 | | 3 | 犯罪与法律 | | 4 | 教育与就业 | | 5 | 硬件 | | 6 | 娱乐 | | 7 | 社交生活 | | 8 | 时尚与美妆 | | 9 | 金融与商业 | | 10 | 美食与餐饮 | | 11 | 游戏 | | 12 | 健康 | | 13 | 历史 | | 14 | 家居与爱好 | | 15 | 工业 | | 16 | 文学 | | 17 | 政治 | | 18 | 宗教 | | 19 | 科学与技术 | | 20 | 软件 | | 21 | 体育与健身 | | 22 | 交通运输 | | 23 | 旅行 | ## 格式分类标签 | 编号 | 标签名称 | |----|-------| | 0 | 学术写作 | | 1 | 内容列表 | | 2 | 创意写作 | | 3 | 客服文本 | | 4 | 评论区内容 | | 5 | 常见问题解答(FAQ) | | 6 | 截断文本 | | 7 | 知识文章 | | 8 | 法律声明 | | 9 | 列表型文章 | | 10 | 新闻文章 | | 11 | 非虚构写作 | | 12 | 机构介绍页 | | 13 | 机构新闻 | | 14 | 个人介绍页 | | 15 | 个人博客 | | 16 | 产品页面 | | 17 | 问答论坛内容 | | 18 | 垃圾广告 | | 19 | 结构化数据 | | 20 | 技术文档 | | 21 | 音频转写文本 | | 22 | 教程 | | 23 | 用户评论 | ## 生成细节 - **嵌入向量生成**:使用`jinaai/jina-embeddings-v5-text-nano`模型,任务类型设为`clustering`,生成768维float16格式的嵌入向量 - **主题分类**:采用`WebOrganizer/TopicClassifier-NoURL`模型 - **格式分类**:采用`WebOrganizer/FormatClassifier-NoURL`模型 ## 许可证 MIT协议