doc2json-vlm-full
收藏资源简介:
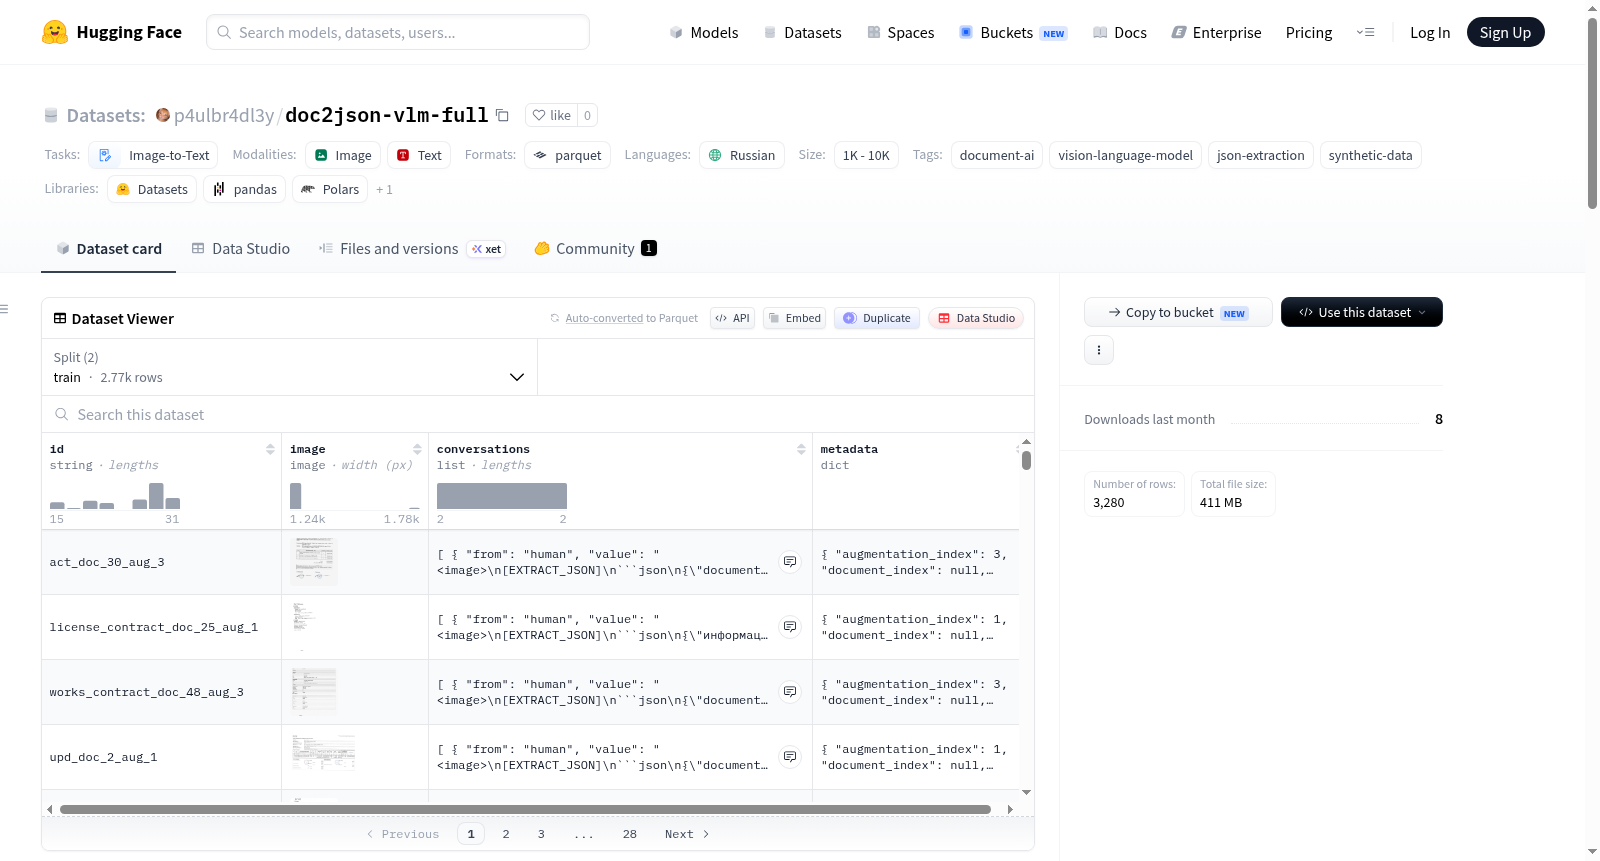
Doc2JSON VLM Full 是一个用于微调视觉语言模型(VLM)的合成数据集,包含俄罗斯文档的图像,模型能够根据动态指定的JSON模式从中提取结构化数据。该数据集于2026年8月4日发布,包含3,280个样本,源自700个原始文档,涵盖15种文档类型:俄罗斯护照、付款发票、验收证书、UPD(统一转让文件)、供应合同、服务合同、合同协议、租赁合同、许可协议、规格、附加协议、对账报告、TORG-12、发票、付款单。数据集分为训练集(2,768个样本,590个原始文档)和验证集(512个样本,110个原始文档),按 source_document_id 进行分割,确保同一文档的页面和增强版本不会跨分割出现。每个样本包含:图像(WebP格式)、对话(ShareGPT风格的提示和JSON目标)、元数据(文档类型、原始文档ID、模式语言为俄语或英语、模板变体、增强索引、是否为合成数据等)。该数据集适用于文档AI、视觉语言模型训练、动态JSON提取等任务。注意:所有数据均为合成数据,不包含真实个人信息。
Doc2JSON VLM Full is a synthetic dataset for fine-tuning Vision-Language Models (VLMs). It comprises images of Russian-language documents, enabling models to extract structured data from them in accordance with dynamically specified JSON schemas. Released on August 4, 2026, the dataset contains 3,280 samples derived from 700 original documents, covering 15 document types: Russian passport, payment invoice, acceptance certificate, UPD (Unified Transfer Document), supply contract, service contract, contract agreement, lease contract, licensing agreement, specification, supplementary agreement, reconciliation report, TORG-12, invoice, and payment slip. The dataset is split into a training set (2,768 samples, 590 original documents) and a validation set (512 samples, 110 original documents) based on source_document_id, ensuring that pages and augmented versions of the same original document do not appear across different splits. Each sample includes an image in WebP format, a conversation with ShareGPT-style prompts and JSON targets, and metadata such as document type, original document ID, schema language (either Russian or English), template variant, augmentation index, and whether the data is synthetic. This dataset is suitable for tasks including document AI, vision-language model training, dynamic JSON extraction, and more. Note: All data is synthetic and contains no real personal information.
数据集概述
Doc2JSON VLM Full 是一个用于微调视觉语言模型(VLM)的合成图像数据集,其核心任务是根据动态指定的 JSON 模式,从俄罗斯文档图像中提取结构化数据。数据集于 2026 年 8 月 4 日发布,总计包含 3,280 个示例,来源于 700 份原始文档。
文档类型
数据集覆盖 15 种俄罗斯文档类型,包括:
- 护照(Паспорт РФ)
- 付款发票(Счет на оплату)
- 已完成工作验收单(Акт выполненных работ)
- 通用转账单据(УПД)
- 供货合同(Договор поставки)
- 服务合同(Договор оказания услуг)
- 承包合同(Договор подряда)
- 租赁合同(Договор аренды)
- 许可合同(Лицензионный договор)
- 规格书(Спецификация)
- 补充协议(Дополнительное соглашение)
- 对账报告(Акт сверки)
- 商品移交单 ТОРГ-12
- 发票(Счет-фактура)
- 付款委托书(Платежное поручение)
数据划分
| 划分 | 示例数 | 原始文档数 |
|---|---|---|
train |
2,768 | 590 |
validation |
512 | 110 |
数据划分基于 source_document_id 进行,确保同一原始文档的页面及增强版本不会跨越训练集和验证集。
数据格式
每条记录包含以下字段:
id:字符串类型标识符image:内嵌的 WebP 格式图像conversations:ShareGPT 风格的对话结构,包含from和value字段,其中包含提示词和 JSON 目标输出metadata:元数据结构,包含:augmentation_index(增强版本索引)document_index(文档索引)document_type(文档类型)page(页码)schema_language(模式键语言,ru或en)source_document_id(原始文档标识符)synthetic(是否为合成数据)template_variant(布局模板变体)
提示词示例: text <image> [EXTRACT_JSON] json {"document_info":{"number":"string"}}
目标输出示例: json {"document_info":{"number":"У-4968"}}
使用方法
用户可通过 datasets 库直接加载数据集:
python from datasets import load_dataset
dataset = load_dataset("p4ulbr4dl3y/doc2json-vlm-full") train_dataset = dataset["train"] validation_dataset = dataset["validation"]
验证过程
发布前已执行以下验证:
- JSON 提示词/目标的一致性,以及目标与请求模式的匹配
- 标量类型、数组和嵌套对象的检查
- ID、路径和图像内容的唯一性
- 所有 WebP 图像的存在性与可解码性
- 训练集与验证集之间
source_document_id无交叉 - 对 500 份新原始文档的语义不变量检查
限制说明
- 数据完全为合成数据,不包含真实个人数据
- 数据集的结构验证并不等同于模型质量评估指标
- 文档类型从 5 种扩展到 15 种后,需要进行新的微调和按文档类型进行独立的质量评估