
遇见数据集

Writer/IRT-mislabeled-items

收藏
Hugging Face2026-06-06 更新2026-07-22 收录
官方服务:

资源简介:

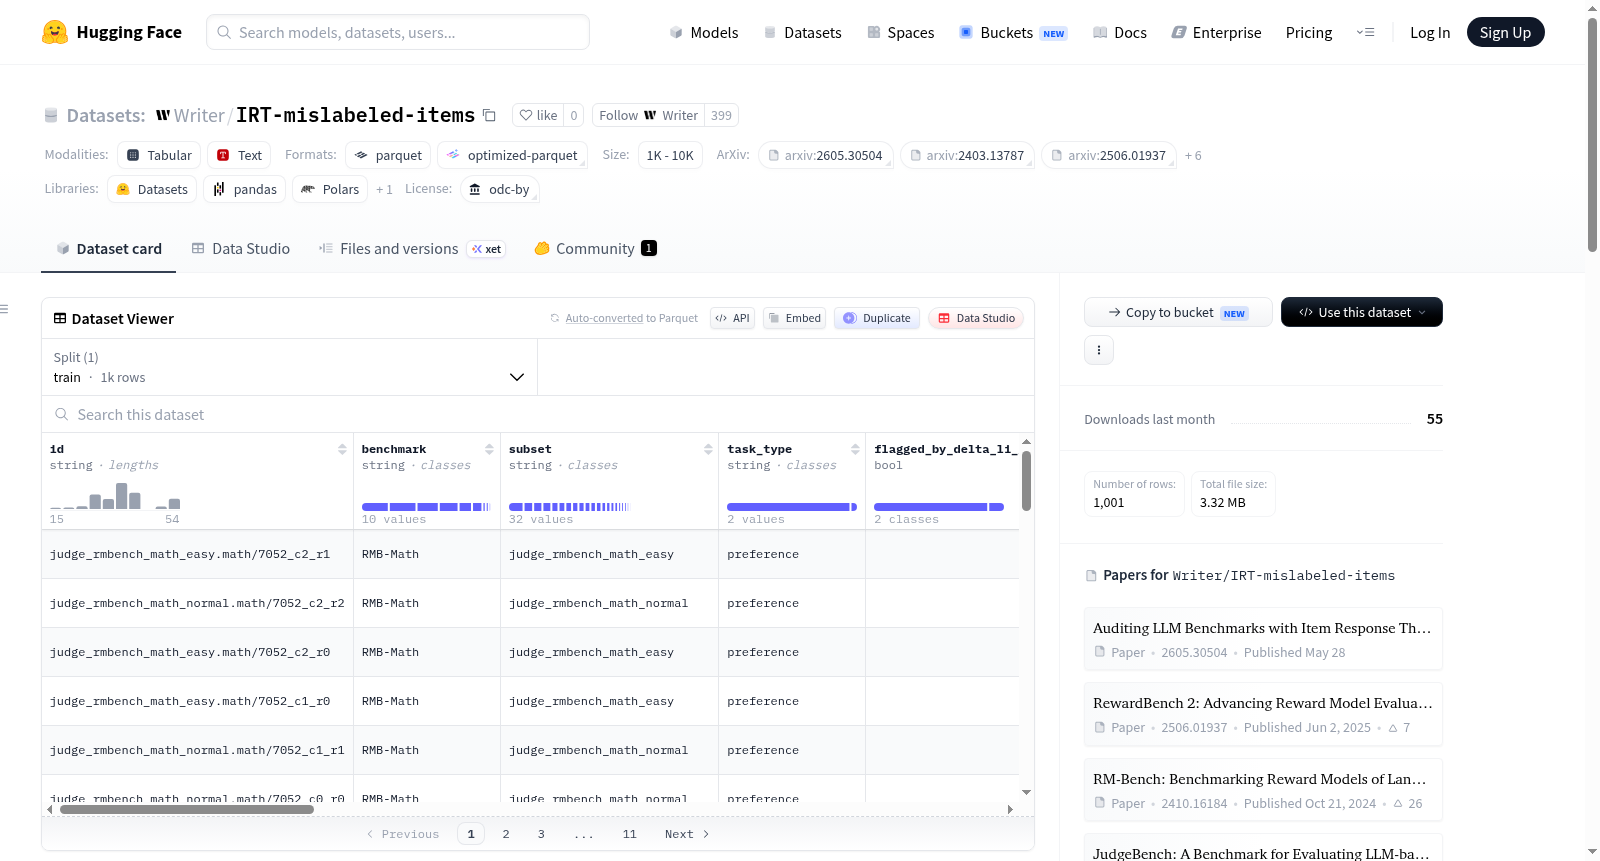
该数据集通过项目反应理论(IRT)检测出潜在错误标记的基准项目,源自论文《使用项目反应理论审计LLM基准》。数据集中包含1001个训练样本,每个样本具有多个特征列,如唯一标识符、基准家族、子集名称、任务类型(偏好或多选)、IRT标志、弱参考标签标志、IRT分数差异、缺失原因、GPT-5.4的弱参考标签及其解释、参考答案和领先非一致答案的投票计数等。数据集来源于多个公开基准,包括用于偏好评估的RewardBench、RewardBench 2、RM-Bench和JudgeBench,以及用于事实性多项选择的GPQA Diamond、MATH和GSM8K。这些项目被标记的条件是IRT的delta_li大于0或GPT-5.4弱参考标签为mislabel或unsure,旨在帮助研究人员识别和审核基准数据中的标签问题。

This dataset is a collection of benchmark items with potential label errors detected via Item Response Theory (IRT), sourced from the paper *Using Item Response Theory to Audit LLM Benchmarks*. It contains 1,001 training samples, each with multiple feature columns including unique identifier, benchmark family, subset name, task type (preference or multiple-choice), IRT flag, weak reference label flag, IRT score difference, reason for missing values, weak reference label and its explanation from GPT-5.4, reference answer, and vote count of the leading non-consistent answer. The dataset is compiled from multiple public benchmarks: RewardBench, RewardBench 2, RM-Bench and JudgeBench for preference evaluation tasks, as well as GPQA Diamond, MATH and GSM8K for factual multiple-choice tasks. These items are flagged when either the IRT-derived delta_li value is greater than 0, or the weak reference label from GPT-5.4 is marked as "mislabel" or "unsure". This dataset aims to assist researchers in identifying and auditing label issues within benchmark datasets.
提供机构:
Writer
搜集汇总
数据集介绍
Writer/IRT-mislabeled-items 数据集图片
构建方式
该数据集源自论文《Auditing LLM Benchmarks with Item Response Theory》,旨在通过项目反应理论(IRT)识别基准测试中潜在的误标注样本。构建过程中,研究团队对多个公开基准数据集(如RewardBench、GPQA Diamond、MATH等)中的题目进行IRT分析,计算强迫上限似然对比度(delta_li),并联合GPT-5.4的弱参考标注结果。数据集的纳入标准为delta_li大于零或弱参考标签为'误标注'或'不确定',从而形成两项指标的并集。对于因IRT拟合前被过滤而未获得delta_li分数的条目,数据集记录了缺失原因。最终,数据集包含1001个训练样本,每个样本均附带详细的标注信息、投票计数及可读的提示内容。
特点
该数据集的核心特点在于其双重验证机制:一方面通过IRT模型从能力预测角度发现异常项目,另一方面借助GPT-5.4的弱参考标注进行语义层面的审查。每个条目均包含丰富的元信息,如基准家族、子集名称、任务类型(偏好判断或多选题)、以及两种判定标志位。此外,数据集还提供了参考试答案与主要非一致答案的投票分布,以及GPT-5.4对标注理由的简短解释,便于研究者深入理解误标注的成因。数据集的许可证采用ODC-BY,允许在遵守原始基准许可证的前提下自由使用和分发。
使用方法
该数据集适用于基准测试质量审计与误标注检测研究的验证工作。研究者可直接加载训练分割中的1001个样本,利用'flagged_by_delta_li_gt_0'和'flagged_by_weak_ref_label'两个布尔字段筛选不同标注来源的潜在误标注项目。对于需要复现论文结果的用户,项目提供了reproduce_table1.py脚本,可基于数据集的标签策略计算严格和包容性的P@K指标。此外,'sample_content'字段提供了格式化后的提示和选项内容,便于进行人工审核或作为更下游分析的输入。
背景与挑战
背景概述
在大型语言模型(LLM)评估领域,基准测试(benchmark)的质量直接决定了模型能力评估的可信度。然而,基准测试中普遍存在的标注错误(mislabeled items)会严重扭曲性能排名,使得对模型能力的解读产生偏差。IRT(Item Response Theory)作为一种心理测量学方法,近年来被引入NLP领域以检测基准测试中的潜在错误项。该数据集由研究团队在论文《Auditing LLM Benchmarks with Item Response Theory》(arXiv:2605.30504)中创建,旨在系统性地揭露主流LLM基准(如RewardBench、GPQA Diamond、MATH等)中的标注问题。通过结合无监督IRT指标(δ_ℓᵢ>0)与GPT-5.4弱参考标签(weak-ref label),研究团队构建了包含1001个潜在错误项的集合,覆盖偏好评估与事实型多项选择任务。这一工作不仅为基准审计提供了可复现的量化工具,也对提升LLM评估的鲁棒性产生了重要影响。
当前挑战
该数据集所解决的核心挑战在于,现有LLM基准测试中标注错误普遍存在但难以被系统识别。传统依赖人工审查或简单投票的方法效率低下且主观性高,而IRT方法能够通过模型能力与题目参数的联合建模,从统计异常中定位可疑题项。在构建过程中,研究团队面临多重技术挑战:如何定义和量化“潜在错误”的标准,以避免假阳性干扰(如主观性题目并非真正错误);如何处理不同任务类型(偏好判断与多项选择)的异构数据结构;以及如何将无监督IRT指标与有监督弱参考标签进行有效融合,形成统一的联合标记策略。此外,GPT-5.4弱参考标签的可靠性也需谨慎验证,以平衡自动化检测的高覆盖度与标签噪声之间的矛盾。
常用场景
经典使用场景
该数据集专为检测大型语言模型(LLM)基准测试中的潜在错误标注项而设计,是应用项目反应理论(IRT)进行数据质量审计的经典范例。其核心使用场景在于识别那些基准答案存在争议或明显错误的样本,通过计算‘delta_li’指标(即模型能力对非参考答案预测优于参考答案的似然对比),并结合GPT-5.4的弱参考标注,系统性地筛选出可能包含标注误差的数据点。研究者可利用此数据集精准定位RewardBench、GPQA Diamond、MATH等多个主流基准测试中的问题实例,从而在模型评估前剔除脏数据,确保评测结果的可靠性与公正性。
衍生相关工作
围绕该数据集衍生的一系列工作主要聚焦于基准审计方法的深度拓展与跨领域迁移。一方面,后续研究借鉴其‘似然对比’指标,将IRT模型与投票加权策略结合,发展出能同时识别多答案冲突与模糊标注的集成检测算法;另一方面,基于数据集中GPT-5.4的弱参考标注语料,学术界涌现了针对‘弱监督信号可信度校准’的探索性工作,旨在降低大模型自标注偏差对审计结果的干扰。此外,该数据集的发布催生了‘基准测试演进追踪’这一方向,通过定期对比不同版本数据集的错误项分布,动态评估LLM能力增长与基准难度衰减之间的耦合关系,为长期模型性能观测提供了量化工具。
数据集最近研究
最新研究方向
基于项目反应理论(IRT)的基准测试集质量审计成为当前大语言模型评估领域的前沿方向。IRT-mislabeled-items数据集通过引入IRT框架与GPT-5.4弱参考标注的协同检测机制,系统性地识别了RewardBench、GPQA Diamond等主流基准中的潜在错误标注项。该研究揭示了传统基准测试在标注一致性上的深层缺陷,为构建更可靠的模型能力评估体系提供了方法论支撑,其意义在于推动了大语言模型评测从简单准确率统计向概率化认知诊断范式的转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

