遇见数据集

shrutisingh/dataset_recommendation_mcq_mc

收藏
Hugging Face2023-10-12 更新2024-03-04 收录
官方服务:

资源简介:

该数据集源自DataFinder数据集,并从PapersWithCode中获取了每个数据集的摘要。数据集的任务是多选题(MCQ)且包含多个正确答案,旨在为研究问题推荐合适的数据集。数据集包含一个简短的查询(query)和相关的关键词,原始训练集包含正负样本以训练对比模型。此外,数据集还添加了引入数据集的研究论文的摘要,以提供上下文信息。该数据集与另一个仅包含单个正确答案的MCQ任务数据集没有交集。

This dataset is derived from the DataFinder dataset, with summaries for each of its included datasets obtained from PapersWithCode. The task of this dataset is multiple-choice questions (MCQ) with multiple correct answers, aiming to recommend suitable datasets for research queries. It contains a short query and related keywords, and the original training set includes positive and negative samples for training contrastive models. Additionally, abstracts of the research papers that introduced the datasets contained herein are also added to provide contextual information. This dataset has no overlap with another MCQ task dataset that only allows a single correct answer.

提供机构:
shrutisingh
原始信息汇总

数据集概述

任务类型

  • 多选题(MCQ),包含多个正确答案。

数据集来源

数据集内容

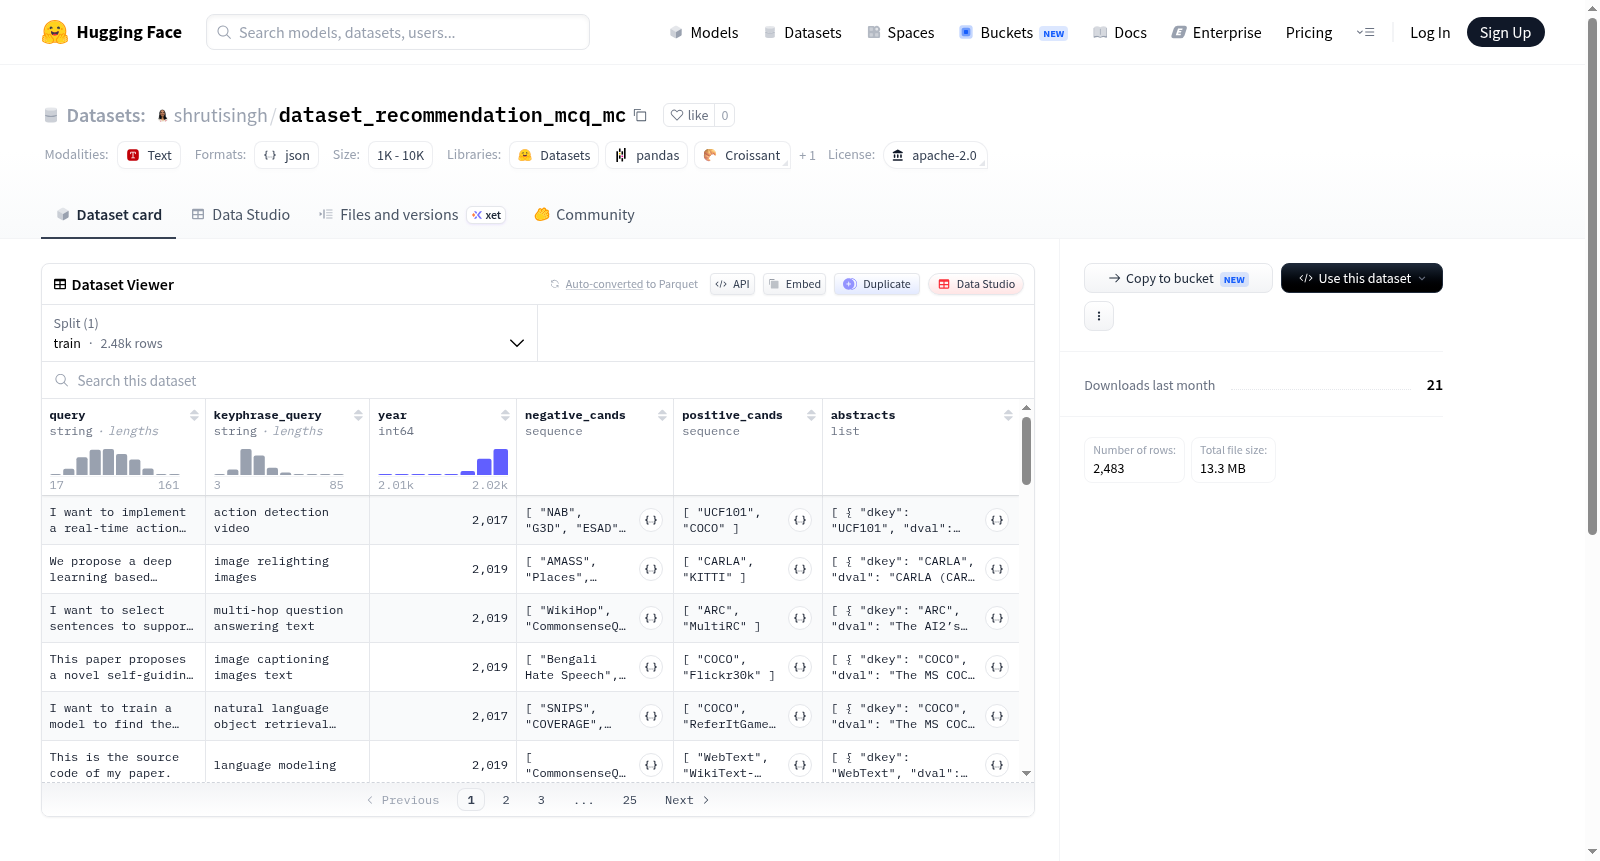
  • 数据集包含一个简短的查询,讨论一个研究问题,并附有与查询相关的关键词。
  • 原始的DataFinder数据集训练集中,每个查询都有正负候选答案,用于训练对比模型。
  • 该数据集的目标是将其转换为多选题问答任务,并添加引入数据集的研究论文的摘要,以提供上下文信息。

数据集特点

搜集汇总
数据集介绍
shrutisingh/dataset_recommendation_mcq_mc 数据集图片
构建方式
该数据集源自DataFinder语料库,并融合了PapersWithCode平台中每个数据集的摘要信息。原始DataFinder训练集为每个查询提供正负候选样本,以训练对比学习模型。本数据集在此基础上进行重构,将任务转化为多选题问答形式,其中每个问题可对应多个正确答案。同时,引入了介绍这些数据集的学术论文摘要,为模型提供丰富的上下文信息。构建过程完全可复现,相关代码已开源。
特点
本数据集的核心特点在于其独特的任务设计——面向研究问题的数据集推荐,并以多选题多答案形式呈现。每个查询实例均包含一段探讨研究问题的简短描述及相关关键词,模型需从候选数据集中选出所有适用选项。与仅含单一正确答案的变体不同,本数据集强调多选能力,更贴近真实科研场景中数据集的多样选择需求。查询实例与单答案版本无重叠,确保了数据集的独立性与互补性。
使用方法
使用方法上,该数据集适用于训练和评估模型在给定研究问题描述时,从多个候选数据集中准确识别所有相关选项的能力。用户可直接加载数据集,利用提供的查询、关键词及数据集摘要构建输入,训练模型进行多标签分类或排序任务。建议结合对比学习或基于注意力的架构,以充分利用正负候选样本及摘要信息。具体实现可参考开源代码库中的示例与复现指南。
背景与挑战
背景概述
在自然语言处理与学术信息检索领域,研究者常面临如何为特定研究问题精准匹配数据集的难题。由Shruti Singh等人于2023年基于ACL会议论文DataFinder构建的数据集shrutisingh/dataset_recommendation_mcq_mc,旨在将数据集推荐任务转化为多选题问答形式。该数据集源自PapersWithCode平台,通过提取数据集的摘要及研究问题相关关键词,构建了包含多个正确答案的问答实例,为评估模型在复杂语义匹配与多标签选择能力上提供了新的基准。其研究核心在于推动学术资源推荐系统的智能化,尤其针对跨领域、多模态研究问题的数据集检索需求,对提升科研效率与知识发现具有重要影响。
当前挑战
该数据集面临的核心挑战包括:其一,领域问题层面,传统数据集推荐多依赖单一匹配标准,难以应对研究问题中隐含的多重语义需求,而多正确答案的设定要求模型具备细粒度语义理解与冗余信息过滤能力,避免因候选数据集高度相似导致的误判。其二,构建过程中,从DataFinder原始对比学习样本转化为多选题格式时,需确保正负候选集的平衡性与抽象摘要的上下文相关性,同时避免与单正确答案变体(dataset_recommendation_mcq_sc)的数据重叠,这对数据清洗与标注一致性提出了严格考验。
常用场景
经典使用场景
该数据集以多选问答(MCQ)形式,为研究问题推荐合适的数据集。每个查询包含一个研究问题描述及相关关键词,模型需从候选数据集中选出所有匹配的正面样本。这一设计模拟了科研人员从海量数据资源中筛选验证假设所需数据的实际过程,尤其适用于评估信息检索与语义匹配模型的性能。
解决学术问题
该数据集主要解决了学术研究中数据集发现与推荐的非结构化难题。传统方法依赖人工检索或关键词匹配,效率低下且易遗漏相关性高的数据集。通过将任务转化为多选问答,该数据集为训练和评估语义理解模型提供了基准,推动了自然语言处理在科研信息检索领域的应用,加速了跨学科数据共享与复用。
衍生相关工作
该数据集源自DataFinder,并衍生出单选版本(dataset_recommendation_mcq_sc),形成互补的基准测试集。相关工作包括基于对比学习的模型训练方法,以及利用论文摘要增强上下文理解的推荐系统。这些工作共同推动了可复现科研生态的建设,为评估和优化数据集推荐算法提供了标准化平台。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务