
遇见数据集

cjvt/rsdo4_en_sl

收藏
Hugging Face2022-09-20 更新2024-03-04 收录
官方服务:

资源简介:

RSDO4平行语料库包含英语-斯洛文尼亚语和斯洛文尼亚语-英语的翻译对,这些翻译对是斯洛文尼亚数字环境项目工作包4的一部分。该语料库包含从公共机构收集的文本和通过项目创建的文本收集门户提交的个体捐赠文本。语料库由964433个翻译对组成(从标准翻译格式(TMX, XLIFF)提取或手动对齐),随机排列,可用于机器翻译训练。

The RSDO4 Parallel Corpus contains English-Slovenian and Slovenian-English translation pairs, which are part of Work Package 4 of the Slovenian Digital Environment Project. This corpus includes texts collected from public institutions and individual donated submissions received via the project's text collection portal. Comprising 964,433 translation pairs extracted from standard translation formats such as TMX and XLIFF, or manually aligned, the corpus is randomly shuffled and suitable for machine translation training.

提供机构:
cjvt
原始信息汇总

RSDO4 en-sl parallel corpus 数据集概述

数据集概述

RSDO4 parallel corpus 是一个包含英语-斯洛文尼亚语和斯洛文尼亚语-英语翻译对的平行语料库,由斯洛文尼亚数字环境项目的工作包4收集。该数据集包含从公共机构收集的文本以及通过项目内创建的文本收集门户提交的个人捐赠者文本。数据集包含964433个翻译对,这些翻译对从标准翻译格式(TMX, XLIFF)中提取或手动对齐,并随机排序,用于机器翻译训练。

支持的任务

  • 机器翻译

语言

  • 英语
  • 斯洛文尼亚语

数据集结构

数据实例

数据集中的一个样本实例包含以下字段:

  • en_seq: 包含英语序列的字符串
  • sl_seq: 包含斯洛文尼亚语序列的字符串

附加信息

数据集创建者

  • Andraž Repar
  • Iztok Lebar Bajec

许可信息

  • CC BY-SA 4.0

引用信息

@misc{rsdo4_en_sl, title = {Parallel corpus {EN}-{SL} {RSDO4} 1.0}, author = {Repar, Andra{v z} and Lebar Bajec, Iztok}, url = {http://hdl.handle.net/11356/1457}, year = {2021} }
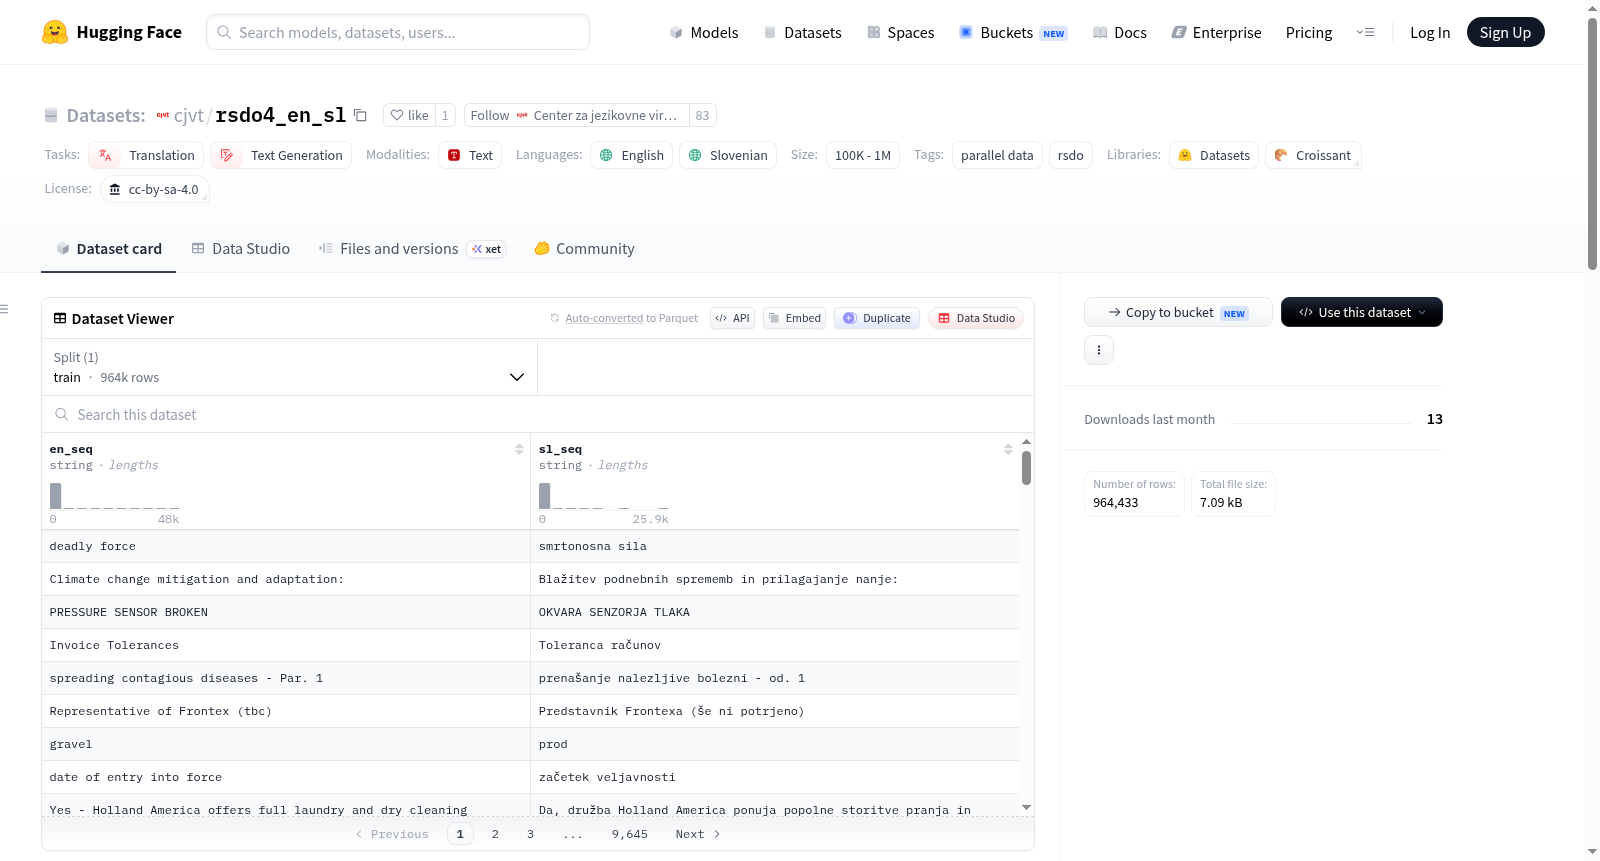
搜集汇总
数据集介绍
cjvt/rsdo4_en_sl 数据集图片
构建方式
RSDO4英斯平行语料库的构建源于斯洛文尼亚数字环境项目第四工作包的系统性规划。数据采集融合了双轨策略:一方面从公共机构收集规范文本,另一方面通过项目专属文本征集门户汇聚个人捐赠者的语料。最终形成的964433个翻译对,均从TMX、XLIFF等标准翻译格式中提取或经过人工对齐处理,并以随机化序列排列,为机器翻译模型的训练奠定了坚实基础。
特点
该数据集以英语与斯洛文尼亚语的双向翻译为核心,呈现出鲜明的双语平行特征。其规模跨越十万至百万级别,确保了统计学习的充分性。数据实例结构简洁明快,每条记录仅包含'en_seq'与'sl_seq'两个字段,分别承载英语和斯洛文尼亚语的序列,剔除了冗余元数据,便于研究者直接聚焦于翻译任务的核心建模。
使用方法
数据集专为机器翻译任务设计,可无缝衔接文本生成与文本到文本生成等场景。使用者可直接加载JSON格式的实例,通过'en_seq'与'sl_seq'字段获取源语言与目标语言序列对。建议将随机排列的语料划分为训练、验证与测试子集,以评估翻译模型的泛化能力。数据采用CC BY-SA 4.0许可协议,在引用时需注明Repar与Lebar Bajec的原创工作。
背景与挑战
背景概述
在机器翻译领域,高质量平行语料库的构建是推动神经机器翻译模型性能提升的关键基石。RSDO4英斯洛文尼亚平行语料库(RSDO4 en-sl parallel corpus)由Andraž Repar与Iztok Lebar Bajec于2021年创建,隶属于斯洛文尼亚数字环境项目的工作包4。该语料库汇集了来自公共机构的文本以及通过项目文本收集门户由个人捐赠者提交的语料,共包含964433个翻译对,覆盖英语与斯洛文尼亚语双向翻译。其随机排序的格式与标准翻译格式(TMX、XLIFF)的兼容性,使其成为训练机器翻译模型的重要资源,显著推动了低资源语言对(如斯洛文尼亚语)的神经机器翻译研究。
当前挑战
该数据集面临的核心挑战包括:首先,在领域问题层面,斯洛文尼亚语作为低资源语言,其平行语料库的稀缺性导致机器翻译模型在翻译质量、领域覆盖和术语一致性方面存在显著瓶颈,尤其在处理专业文本(如法律、金融术语)时易出现歧义或错误。其次,在构建过程中,数据收集与对齐的困难尤为突出:公共机构文本格式多样(如TMX、XLIFF),需手动对齐或依赖自动化工具,但不同来源的文本在句长、结构上差异显著,增加了对齐误差风险;个人捐赠者的文本质量参差不齐,需经专家审核与清洗,耗时且难以完全消除噪声。此外,语料库的许可证(CC BY-SA 4.0)虽促进开放共享,但限制了商业用途模型的直接训练,进一步加剧了实际应用中的适配难度。
常用场景
经典使用场景
RSDO4英斯洛文尼亚语平行语料库作为机器翻译领域的经典资源,主要用于训练和评估神经机器翻译模型。该数据集包含近百万对高质量的双语翻译对,覆盖公共机构文本与个人捐赠语料,为英斯洛文尼亚语之间的自动翻译提供了丰富的对齐数据。研究者常将其应用于序列到序列模型的训练,通过编码器-解码器架构学习两种语言间的映射关系,并利用其随机排序的特性验证模型在多样化语境下的泛化能力。
实际应用
在实际应用中,RSDO4语料库支撑着斯洛文尼亚公共机构的多语言服务系统,例如政府文件自动翻译、欧盟事务中的跨语言沟通等场景。它还被集成到商业翻译平台中,提升英斯洛文尼亚语互译的准确性与流畅度,服务于旅游、法律和技术文档的本地化需求。此外,该数据集可用于开发教育领域的辅助工具,帮助斯洛文尼亚语学习者通过对比分析理解语言结构差异。
衍生相关工作
基于RSDO4语料库,衍生出一系列经典研究工作,包括针对斯洛文尼亚语的跨语言词嵌入对齐方法、基于Transformer的微调翻译模型以及混合专家系统的探索。研究者还将其与多语言预训练模型(如mBART、M2M-100)结合,验证零样本翻译在小语种上的可行性。此外,该数据集被用于评测斯洛文尼亚语自然语言处理工具包的基准性能,推动了低资源语言评测体系的建立。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

