
ETCBC Targum Corpus
收藏数据链接:
官方服务:
资源简介:
犹太阿拉姆语翻译希伯来圣经的文本数据集,包含多种塔古姆版本(如伪约拿单、残篇塔古姆、开罗 Genizah 残篇、尼奥菲特),并带有语言学标注,兼容其他Text-Fabric数据集。
A text dataset of Jewish Aramaic translations of the Hebrew Bible, encompassing multiple Targum versions (e.g., Pseudo-Jonathan, Fragmentary Targum, Cairo Genizah Fragments, Neofiti), equipped with linguistic annotations and compatible with other Text-Fabric datasets.
创建时间:
2026-08-09
原始信息汇总
数据集概述
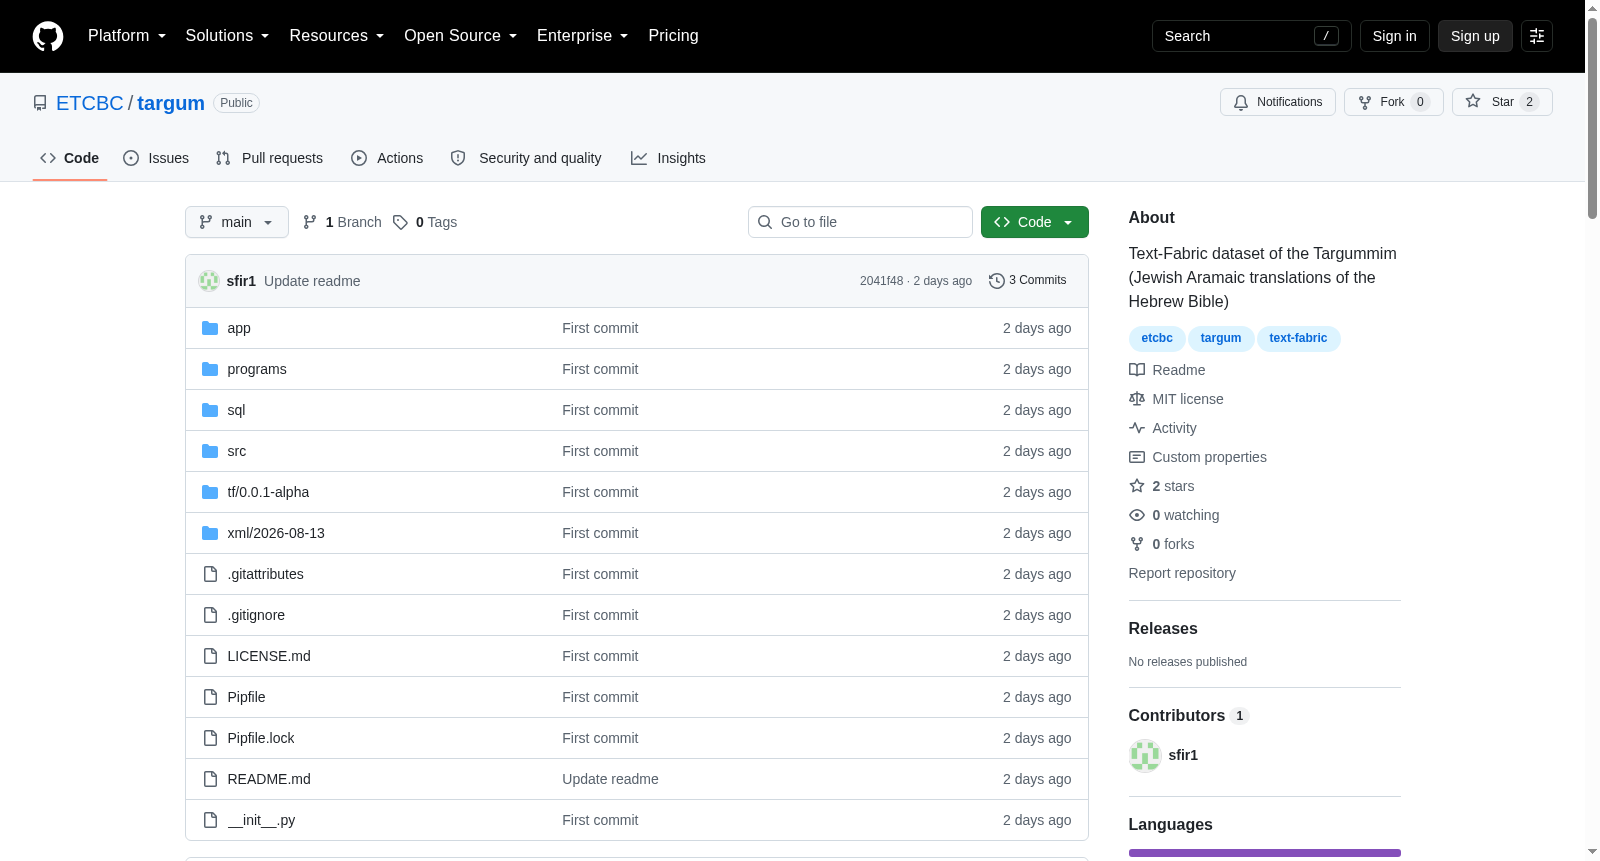
ETCBC Targum 语料库是一个包含犹太亚兰语《希伯来圣经》翻译(即 Targum / Targummim)的文本数据集,以 Text-Fabric 格式存储,并附带 PostgreSQL 与 XML 版本及 ETL 转换流程。
文本内容
- 伪约拿单(Pseudo-Jonathan):大英图书馆 Add. Ms. 2703 抄本。
- 片段塔古姆(Fragment Targums):包含巴黎、梵蒂冈、纽伦堡三个抄本片段(P、V、N)。
- 开罗 Genizah 塔古姆残片:包含 A 至 ZZ 等多个残片标记。
- Neofiti:梵蒂冈图书馆 Neofiti 1 号抄本,提供“全文视图”(含插入与旁注变体)和“基础原文视图”(排除变体与编辑校订)两种形式。
数据特征
- 词级特征包括:辅音文本(转写与亚兰方块字)、元音文本、词位、英文注释、词性、动词词干、名词性数等。
- 语素层提供词位实现形式。
- 节点层级包括:文本名、书目、章节、诗句、段、语素组与语素槽。
技术说明
- 使用 ETCBC 转写惯例,基於 Syriac 语料库命名规范。
- 帕勒斯提尼亚塔古姆使用提比里亚元音系统。
- 当前处于 alpha 阶段,属进行中工作。
- 许可证:MIT;DOI:10.5281/zenodo.21925395。
- 未来拟补充动词语态、时态、人称及更完整的名词性标记。
搜集汇总
数据集介绍
构建方式
ETCBC Targum Corpus 数据集由阿姆斯特丹自由大学 Eep Talstra 圣经与计算机中心开发,采用 Text-Fabric 框架构建,收录了犹太阿拉姆语圣经译本(Targum)的数字化文本及语言学标注。数据集整合了多个抄本,包括伪约拿单、碎片化塔古姆、开罗 Genizah 残片以及 Neofiti 抄本,并提供全文和基础原始两种视图以区分正本与抄写或编辑层级的变体。构建过程中遵循 ETCBC 标注约定,词级特征涵盖辅音文本、元音化文本、词素、词性、词干、性数等,层级结构从文本、书、章、节到语素组和语素,支持复杂查询。数据以 PostgreSQL、XML 及 Text-Fabric 格式发布,并附带 ETL 转换流程。
特点
该数据集的核心特色在于其高度细粒度的语言学标注与多层抄本信息的整合。所有文本特征严格遵循 ETCBC 惯例,命名与叙利亚语语料库保持一致,以增强阿拉姆语语料间的互操作性。辅音文本使用阿拉姆方块字体,巴勒斯坦塔古姆的元音标注采用提比里亚体系。尤其特别的是,Neofiti 抄本包含数千条变体读法和校勘,数据集通过‘全文视图’与‘基础原始视图’兼顾了底本与旁注、页边注的呈现,为研究古代犹太释经传统提供了全面数据。此外,数据还包含语义定义、英语注释及词根信息,为自然语言处理和圣经研究提供了丰富资源。
使用方法
用户可通过 Text-Fabric Python 库便捷地加载和查询数据集,实现从词素到文本各层级的文本检索与语言学分析。数据亦提供 PostgreSQL 和 XML 格式,便于传统数据库操作或自定义处理。ETL 流水线支持从 SQL 到 XML 再到 Text-Fabric 的格式转换,确保数据在不同平台间的可用性。研究者可依据特征名称(如词性、词干、性数等)进行精准筛选,也可通过变体视图对比不同抄本或校勘层级。数据持续更新,当前处于 alpha 阶段,但已适用于学术探索,并可结合 ETCBC 其他语料库(如希伯来圣经、撒玛利亚五经、叙利亚语译本)进行跨语言对照研究。
背景与挑战
背景概述
ETCBC Targum Corpus由阿姆斯特丹自由大学Eep Talstra圣经与计算机中心(ETCBC)的研究人员创建,旨在提供犹太阿拉姆语圣经译本(Targum)的数字化和语言标注资源。该数据集于近期发布(DOI注册于2024年),涵盖了Pseudo-Jonathan、Fragment Targums、Cairo Genizah残篇及Neofiti等重要塔古姆文本,并遵循ETCBC的文本-织物(Text-Fabric)框架,与BHSA、撒玛利亚五经和叙利亚语译本等数据集保持互操作性。其核心研究问题在于如何保留并呈现抄本中的异文和编辑层,为阿拉姆语方言的历时研究、圣经诠释学及数字人文学科提供了宝贵资源,推动了犹太阿拉姆语语料库的开放科学进程。
当前挑战
该数据集面临的挑战首先源于塔古姆文献本身的复杂性:文本包含大量抄写变体、行间注释和边注(如Neofiti的数千处异文),如何忠实编码这些层叠的抄写与编辑信息,同时保持数据结构的清晰性,是构建过程中的主要难题。其次,阿拉姆语的语言特征(如词形变化、动词词干和名词语态)在不同传统中存在差异,而现有标注仅部分覆盖(如属性gn、nu、st尚不完整),亟需扩展。此外,将手稿的物理布局(如边注位置)转化为逻辑数据模型,并确保跨语料库的互操作性,也是持续的技术挑战。
常用场景
经典使用场景
该数据集作为犹太阿拉姆语塔argum文本的数字化宝库,其经典使用场景聚焦于文本-织物框架下的计算语言学分析。研究者可借此进行词汇形态标注、句法结构解析及版本变异的量化比较,尤其适用于探索塔argum文本与希伯来圣经底本之间的翻译对应关系。通过利用字级特征如辅音文本、元音标注、词性及词根信息,学者能深入剖析阿拉姆语翻译的语言学特征,从而为闪米特语历史语言学及圣经诠释学提供实证数据支撑。
衍生相关工作
该数据集的衍生工作紧密围绕圣经计算语言学的拓展而展开,例如基于Text-Fabric生态构建的闪米特语料库对齐分析实践。其标注规范启发了对阿拉姆语方言连续体的比较研究,如与叙利亚语别西大译本的数据集成,催生出跨塔argum版本的语言变异图谱绘制。长远来看,其催生的方法论创新(如编辑层级的建模)为其他含变体文本的古语文献数字化提供了范式,推动学术社群在经典文本数字化领域形成更严谨的数据共享标准。
数据集最近研究
最新研究方向
在计算语言学和数字人文学科的交叉前沿,ETCBC Targum Corpus的构建标志着犹太亚拉姆语塔古姆研究迈入数据驱动的新纪元。该数据集以Text-Fabric框架整合了多个重要塔古姆抄本,特别是Neofiti的全文与基础原始视图的分离,开创了对抄本 scribal 和编辑层进行细粒度编码的先河,为探究犹太释经传统中的口述-书写动态提供了前所未有的量化可能。其与BHSA、撒玛利亚五经及叙利亚语语料库的无缝互操作设计,正催生跨语料库的比较句法和词汇研究,助力重建第二圣殿时期犹太教的多语种文献网络,对理解希伯来圣经的接受史和亚拉姆语方言的历时演变具有深远意义。
以上内容由遇见数据集搜集并总结生成


