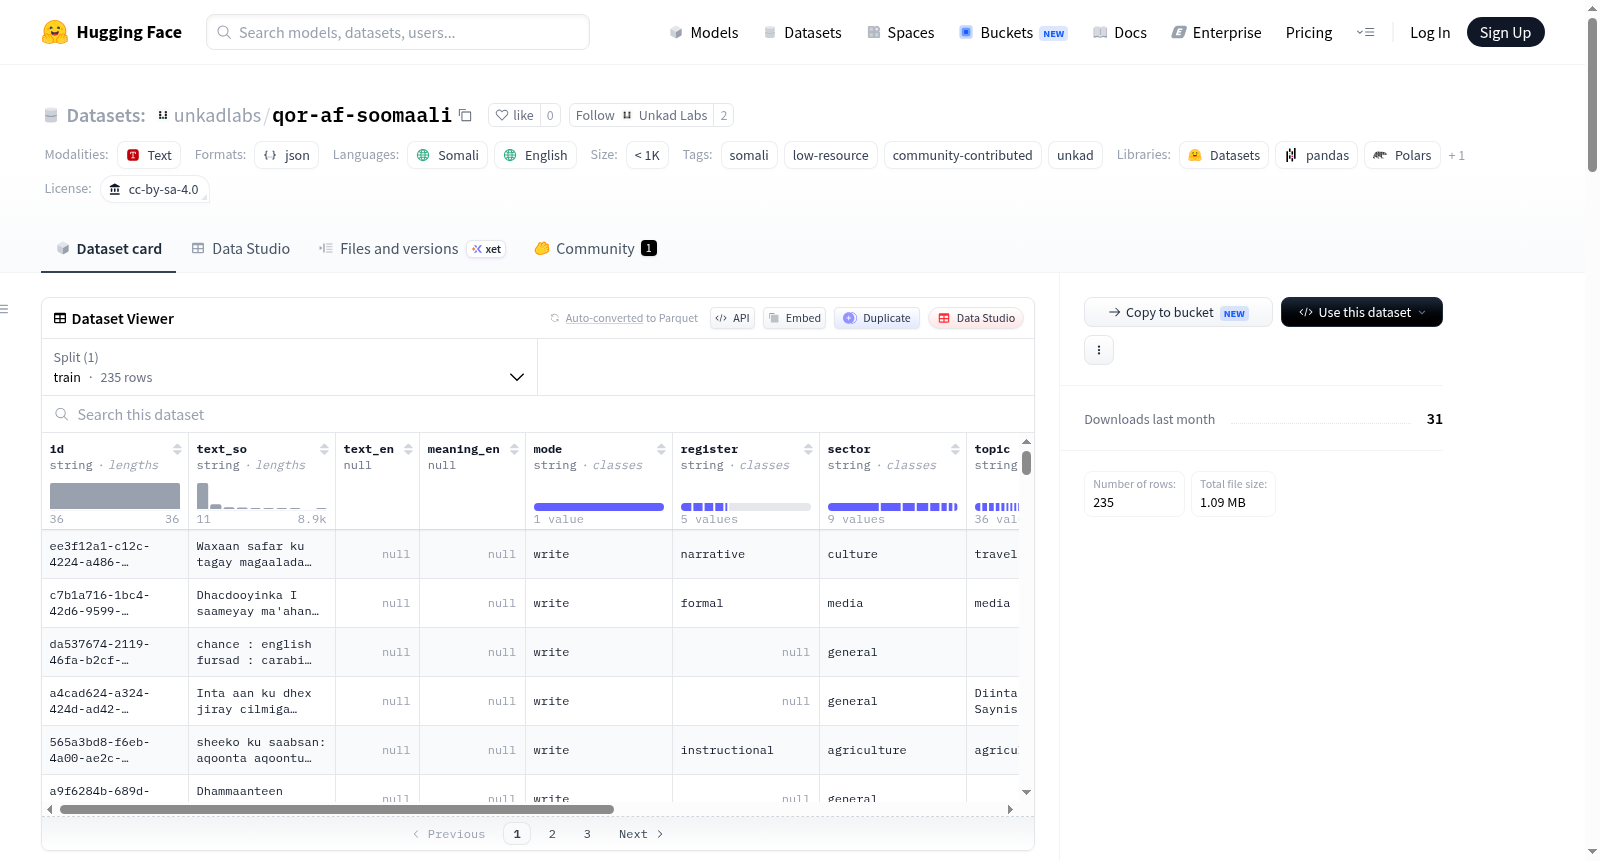
qor-af-soomaali
收藏资源简介:
Qor Af-Soomaali (Unkad索马里语语料库,v0.2.0) 是一个由社区贡献、同行验证、语言学家审核的索马里语文本数据集,由非营利AI研究实验室Unkad Labs通过qor.unkad.com平台构建。每个样本均由同意的索马里语使用者撰写,经过至少两名社区成员验证,并由资深语言学家最终确认。每条数据均携带来源信息:模式(写/翻译/转录)、语域(会话/叙述/指导/正式/技术)、领域、以及贡献者提供的方言信息。当前版本包含2040个句子、34414个单词、235个文档,其中111个文档为新增。数据覆盖9个领域:通用(60.7%)、宗教(11.0%)、技术(9.2%)、文化(6.2%)、媒体(5.4%)、教育(3.4%)、农业(2.5%)、健康(1.1%)、法律(0.4%)。文本经过规范化处理(如统一标点、合并空格),但原始文本可恢复。数据集提供两种格式:sentences.jsonl和train.jsonl。字段包括:text_so(索马里语文本)、text_en(英语来源,仅翻译模式)、mode(模式)、register(语域,仅部分样本有)、sector(领域)、topic(主题)、dialect(方言,如maxaa_tiri或maay)、verified(是否已验证)、license(许可)、created_at(创建时间)。该数据集旨在解决低资源语言索马里语中网络爬取语料存在的作者不明、许可未知、机器翻译污染等问题,强调人工编写和明确授权。所有贡献者均同意CC BY-SA 4.0许可,并选择署名方式。局限性包括:规模较小、贡献者集中、缺少Maay方言、句子分割为自动处理、验证粒度不完全一致、英文平行对保留用于未来评估集。适合用于索马里语文本生成、语言模型训练、方言研究、低资源语言NLP等任务。
Qor Af-Soomaali (Unkad Somali Corpus, v0.2.0) is a community-contributed, peer-verified, linguist-audited Somali text dataset developed by the non-profit AI research lab Unkad Labs via the qor.unkad.com platform. Each sample is authored by consenting Somali language speakers, verified by at least two community members, and finally validated by senior linguists. Every data entry includes source metadata: mode (writing/translation/transcription), register (conversational/narrative/instructional/formal/technical), sector, and dialect information provided by contributors. The current release contains 2,040 sentences, 34,414 words, and 235 documents, of which 111 are newly added. The corpus covers 9 sectors: General (60.7%), Religious (11.0%), Technical (9.2%), Cultural (6.2%), Media (5.4%), Educational (3.4%), Agricultural (2.5%), Health (1.1%), and Legal (0.4%). All texts have been normalized (e.g., unified punctuation, merged whitespace), while the original raw text remains recoverable. This corpus is available in two formats: sentences.jsonl (each line contains a single sentence, with "document_id" and "position" fields to enable paragraph reconstruction) and train.jsonl (each line contains a complete document, preserving paragraph structure). The core data fields include: "text_so" (Somali text), "text_en" (English source, only available for translation-mode samples), "mode", "register" (available for partial samples only), "sector", "topic", "dialect" (e.g., maxaa_tiri or maay), "verified" (validation status), "license", and "created_at". This corpus was developed to address critical issues in web-crawled Somali language corpora, including unknown authorship, unconfirmed licensing, and machine translation contamination, prioritizing human-authored content and clearly documented consent. All contributors have agreed to the CC BY-SA 4.0 license and opted for standard attribution requirements. Limitations of this corpus include: relatively small scale, concentrated contributor base, lack of Maay dialect coverage, automatic sentence segmentation, inconsistent validation granularity, and English parallel pairs reserved for future evaluation sets. It is suitable for tasks such as Somali text generation, language model training, dialect research, and low-resource language NLP.
Qor Af-Soomaali — Unkad 索马里语语料库 (v0.2.0)
数据集概览
- 许可证: CC BY-SA 4.0
- 语言: 索马里语 (so) 和英语 (en)
- 规模: 1K < n < 10K 条
- 标签: 索马里语、低资源语言、社区贡献、Unkad
- 构建方: Unkad Labs(非营利AI研究实验室),平台为 qor.unkad.com
数据集规模
| 指标 | 数值 |
|---|---|
| 句子数 | 2,040 |
| 词数 | 34,414 |
| 文档数 | 235 |
| 本版本新增文档 | 111 |
| 英-索平行句对 | 0 |
| 领域数 | 9 |
| 质量等级 | 语言学家验证 |
| 内容类型 | 单语索马里语 |
领域分布(9个领域)
| 领域 | 句子数 | 占比 |
|---|---|---|
| 通用 | 1,239 | 60.7% |
| 宗教 | 225 | 11.0% |
| 技术 | 187 | 9.2% |
| 文化 | 127 | 6.2% |
| 媒体 | 110 | 5.4% |
| 教育 | 69 | 3.4% |
| 农业 | 51 | 2.5% |
| 健康 | 23 | 1.1% |
| 法律 | 9 | 0.4% |
文本规范说明
- 对标点符号进行了标准化处理(如弯引号、不间断连字符/空格、零宽字符等),防止评分时出现伪错误
- 省略号统一为三个点,多余空格被合并
- 本版本中235篇文档中有152篇受影响
- 字母、元音和表示索马里语喉塞音的撇号均未改动;en/em破折号保留
- 平台保存原始未修改文本,原始内容可恢复
文件结构
data/sentences.jsonl:每行一条句子,包含document_id和position字段,可重组上下文data/train.jsonl:每行一篇完整文档,保留段落结构- 两个文件内容相同,可按任务选择使用
数据字段
text_so:索马里语文本text_en:英语文本(仅翻译模式)mode:写作/翻译/转写register:会话/叙事/指令/正式/技术(仅提示式条目有,共265句,自由写作无)sector:领域topic:主题dialect:方言(maxaa_tiri/maay/其他,如共享)verified:验证状态license:许可证created_at:创建时间
同意与署名
- 所有贡献者在注册时明确同意在CC BY-SA 4.0下开放发布
- 贡献者可选择以姓名、化名或匿名方式署名(见
CREDITS.md)
构建理念
- 语料为人工撰写而非网络抓取
- 每条句子均有明确作者、明确许可、明确来源
- 无机器翻译内容,无未经授权的文本
- 已执行质量管控:曾移除约150条从Telegram转发的内容,并对粘贴长文本的贡献者进行了调查和记录
已知局限
- 规模较小:早期版本,非完整语料库
- 贡献集中:少数贡献者撰写了大部分文本
- 缺少Maay方言:目前所有条目均为Maxaa-tiri或未指明
- 句子分割为自动处理:基于终止标点和换行分割,已移除96条非索马里语句子(阿拉伯语引文等)
- 验证粒度不一:长段落整体验证,而非逐句验证;句子级审阅计划中
- 英语平行句对暂未发布:保留用于未来的评估集,防止被训练后失去基准价值
引用与联系
- 联系邮箱:research@unkad.com
- 平台地址:https://qor.unkad.com