
遇见数据集

RetaSy/quranic_audio_dataset

收藏
Hugging Face2024-05-14 更新2024-06-12 收录
官方服务:

资源简介:

我们探索了众包一个精心标注的古兰经数据集的可能性,在此基础上可以构建AI模型以简化学习过程。特别是,我们使用基于志愿者的众包类型,并实现了一个众包API来收集音频资源。我们开发了一个名为Quran Voice的众包平台来标注收集的音频资源。结果,我们从11个以上非阿拉伯国家的1287名参与者中收集了约7000个古兰经诵读音频,并从数据集中标注了1166个诵读音频,分为六个类别。我们达到了0.77的众包准确率,标注者之间的评分一致性为0.63,算法分配的标签与专家判断之间的一致性为0.89。

We explored the feasibility of crowdsourcing a meticulously annotated Quranic dataset, upon which AI models can be built to streamline the learning process. Specifically, we adopted a volunteer-based crowdsourcing approach and implemented a crowdsourcing API for audio resource collection. We developed a crowdsourcing platform named Quran Voice to annotate the collected audio samples. As a result, we collected approximately 7,000 Quran recitation audio samples from 1,287 participants across more than 11 non-Arab countries, and annotated 1,166 recitation audio samples from the dataset, which were categorized into six classes. We achieved a crowdsourcing accuracy of 0.77, an inter-annotator agreement score of 0.63, and a consistency of 0.89 between algorithm-assigned labels and expert judgments.

提供机构:
RetaSy
原始信息汇总

数据集概述

数据集名称

  • 名称: Quranic Audio Dataset - Crowdsourced and Labeled Recitation from Non-Arabic Speakers

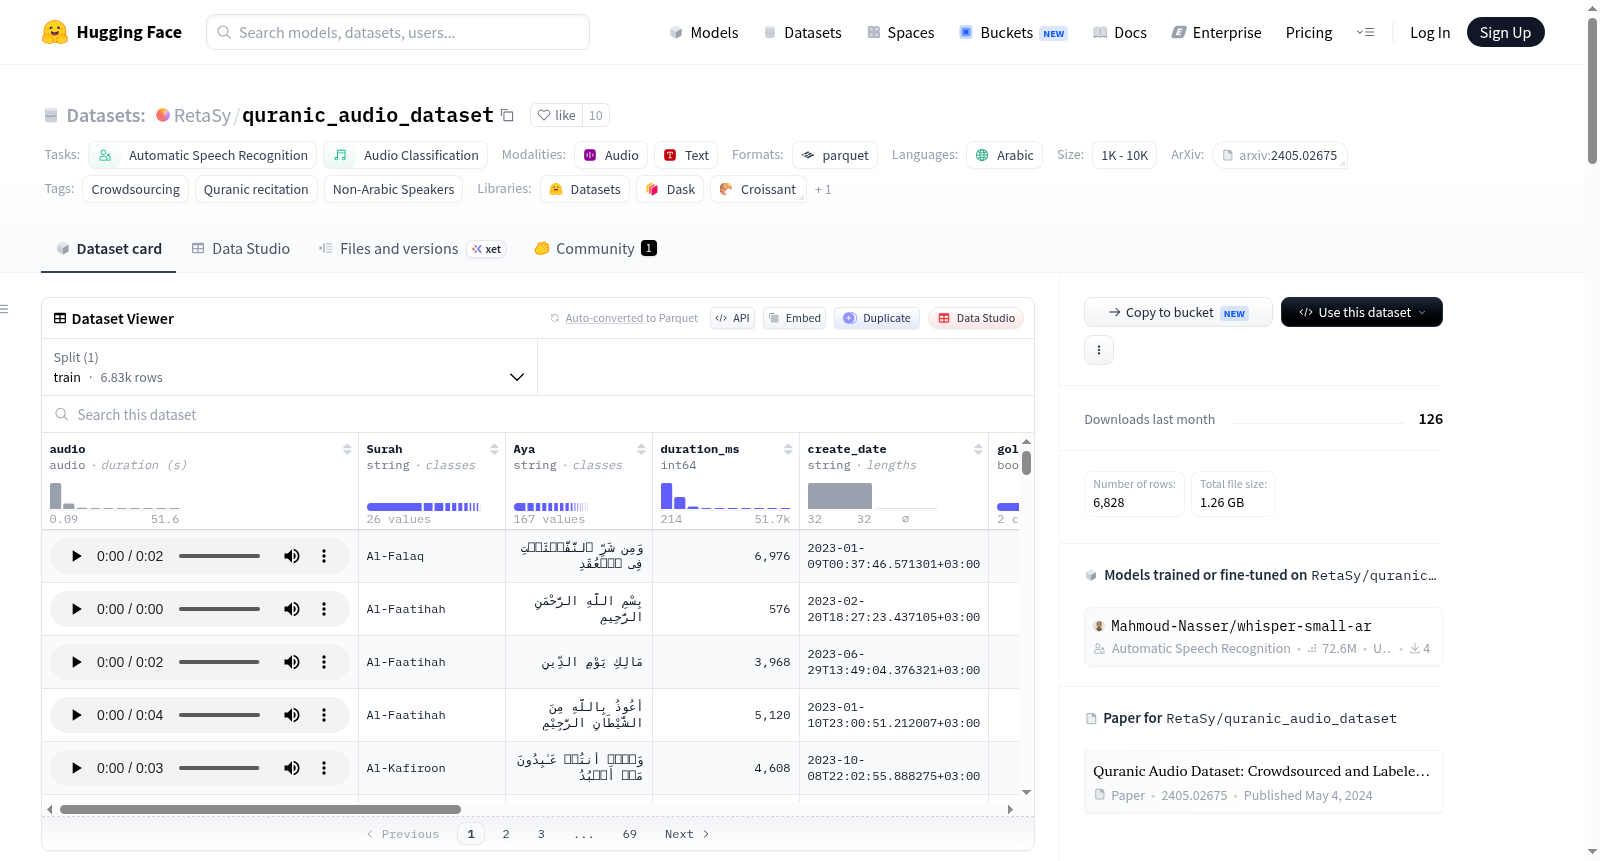
数据集特征

  • audio (dict): 包含音频文件路径、解码后的音频数组和采样率。
  • Surah (string): 古兰经的章节。
  • Aya (string): 古兰经章节中的特定诗句。
  • duration_ms (int64): 音频记录的持续时间,以毫秒为单位。
  • create_date (string): 音频记录的创建日期和时间。
  • golden (bool): 音频样本是否由专家标记。
  • final_label (string): 音频样本的共识标签,指示朗诵的分类。
  • reciter_id (string): 朗诵者的唯一标识符。
  • reciter_country (string): 朗诵者的国家。
  • reciter_gender (string): 朗诵者的性别。
  • reciter_age (string): 朗诵者的年龄。
  • reciter_qiraah (string): 朗诵者使用的朗诵风格。
  • judgments_num (int64): 每个音频样本的评判或注释数量。
  • annotation_metadata (string): 与每个音频样本的注释相关的元数据。

数据集结构

  • 训练集 (train): 包含6828个样本,总大小为1290351809.656字节。

任务类别

  • automatic-speech-recognition
  • audio-classification

语言

  • ar (阿拉伯语)

标签

  • Crowdsourcing
  • Quranic recitation
  • Non-Arabic Speakers

引用信息

@inproceedings{quran_audio_dataset:2024, author = {Raghad Salameh, Mohamad Al Mdfaa, Nursultan Askarbekuly, Manuel Mazzara}, title = {Quranic Audio Dataset: Crowdsourced and Labeled Recitation from Non-Arabic Speakers}, year = 2024, eprint = {2405.02675}, eprinttype = {arxiv}, eprintclass = {cs.SD}, url = {https://arxiv.org/abs/2405.02675}, language = {english} }
搜集汇总
数据集介绍
RetaSy/quranic_audio_dataset 数据集图片
构建方式
在伊斯兰文化与语音技术交叉领域,数据集的构建往往面临标注成本高昂与母语者资源稀缺的双重挑战。该数据集另辟蹊径,采用基于志愿者的众包范式,通过自主开发的“Quran Voice”众包平台,汇聚来自11个以上非阿拉伯语国家的1287名参与者,系统性地采集了约7000段《古兰经》诵读音频。每段音频均经过至少三位众包标注者的独立评判,并辅以控制任务与专家验证,最终通过多数投票机制生成共识标签,其中1166段样本还获得了专家标注作为黄金标准。
特点
该数据集的核心优势在于其独特的众包生态与多维元数据体系。音频样本覆盖了从初学者到熟练者的广泛水平,标注类别细分为正确、错误、非相关古兰经内容、不匹配经文、多节经文及不完整诵读六种精细语义类型。尤为珍贵的是,每条记录均附有详尽的标注者元数据,包括其控制任务解决数、马修斯相关系数、准确率与F1分数,这使得研究者能够对标注质量进行量化评估与筛选,为构建鲁棒的自动语音识别与音频分类模型提供了高质量的训练与评估基础。
使用方法
该数据集可通过HuggingFace的`datasets`库便捷加载,仅需一行代码`load_dataset("RetaSy/quranic_audio_dataset")`即可获取包含6828条训练样本的完整数据集。每条样本以字典形式呈现,内含16kHz采样率的音频数组、对应的古兰经章节与经文文本、诵读时长、朗诵者国籍与性别等人口统计学信息,以及众包标注的最终标签与详细元数据。研究者可直接将其用于自动语音识别系统的微调、诵读错误检测模型的训练,或作为多标签音频分类任务的基准数据集,其丰富的标注质量指标更可支撑标注者可靠性分析等元研究。
背景与挑战
背景概述
《古兰经》作为伊斯兰教的根本经典,其正确诵读对于全球穆斯林而言具有深远的宗教与文化意义。然而,对于非阿拉伯语母语者而言,掌握精准的《古兰经》诵读发音与韵律(Tajweed)是一项严峻挑战。在此背景下,Raghad Salameh、Mohamad Al Mdfaa、Nursultan Askarbekuly 与 Manuel Mazzara 等研究人员于2024年构建了“Quranic Audio Dataset”(RetaSy/quranic_audio_dataset),旨在通过众包方式,系统性地收集并标注来自非阿拉伯语国家的《古兰经》诵读音频。该数据集汇聚了来自11个以上非阿拉伯语国家的1287名参与者贡献的近7000条诵读样本,并精选其中1166条进行了六类精细标注。此数据集不仅为自动语音识别(ASR)与音频分类任务提供了宝贵的语料资源,更有望推动基于人工智能的《古兰经》学习辅助工具的发展,促进宗教教育与技术创新的深度融合。
当前挑战
该数据集所面临的挑战主要体现在两个层面。在领域问题层面,核心挑战在于如何准确评估非母语者的《古兰经》诵读质量,特别是区分发音正确性(correct vs. in_correct)、内容相关性(如not_related_quran、not_match_aya)及完整性(in_complete)等多维度细粒度分类,这要求模型具备对阿拉伯语音系与宗教文本的深度理解能力。在数据集构建过程中,挑战尤为突出:众包标注的质量控制是一大难点,尽管通过控制任务(SCT)和专家验证(golden样本)实现了0.77的众包准确率与0.63的标注者间一致性,但标注者专业背景差异大(如MCC与F1分数波动显著),导致标签噪声难以完全消除。此外,音频采集环境非标准化(如背景噪音、录音设备差异)以及诵读风格(qiraah)多样性,进一步增加了数据预处理的复杂性。这些因素共同制约着数据集在真实场景下的泛化性能与可靠性。
常用场景
经典使用场景
该数据集最经典的使用场景在于构建基于深度学习的《古兰经》诵读自动质量评估系统。通过收集来自11个以上非阿拉伯语国家、1287名参与者的约7000条音频样本,并对其进行六类精细化的众包标注(如发音正确、错误、不相关等),研究者得以训练语音分类与自动语音识别模型,实现对非母语者诵读《古兰经》时发音准确性与韵律规范的智能判别。这一场景深刻契合了宗教教育数字化与低资源语言语音处理的交叉需求,为后续开发面向伊斯兰学习者的交互式教学工具奠定了数据基础。
衍生相关工作
该数据集已衍生出多项经典工作,包括基于注意力机制的《古兰经》诵读错误检测模型、利用元学习应对众包标注噪声的鲁棒分类算法,以及融合音韵学特征的跨诵读风格(Qiraah)迁移学习框架。研究者还基于其细粒度标注元数据(如标注者能力评分SCT、MCC等),开发了众包质量动态评估与权重聚合策略,显著提升了标签融合的可靠性。这些工作不仅深化了语音识别在宗教文本领域的应用,也为低资源语言中众包数据集的构建与利用提供了方法论参考。
数据集最近研究
最新研究方向
在当前语音处理与宗教文本数字化交叉的前沿领域,RetaSy/quranic_audio_dataset的发布标志着利用众包机制构建高质量非阿拉伯语母语者古兰经诵读语料库的重要突破。该数据集聚焦于非阿拉伯语背景的诵读者在多种朗诵风格(如哈夫斯读法)下的音频采集与精细标注,涵盖正确性、完整性及与经文匹配度等六类标签,并引入专家黄金标准与多标注者一致性评估(如MCC、F1分数)来确保标注质量。这一方向紧密关联自动语音识别(ASR)与音频分类在宗教教育场景中的落地需求,尤其为开发面向全球穆斯林学习者的智能纠音系统提供了稀缺的跨语言、多口音训练资源,其众包流程与质量控制框架也为低资源语言语音数据集的构建树立了可复用的方法论范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

