khatme-nubuwwat-ocr-dataset
收藏资源简介:
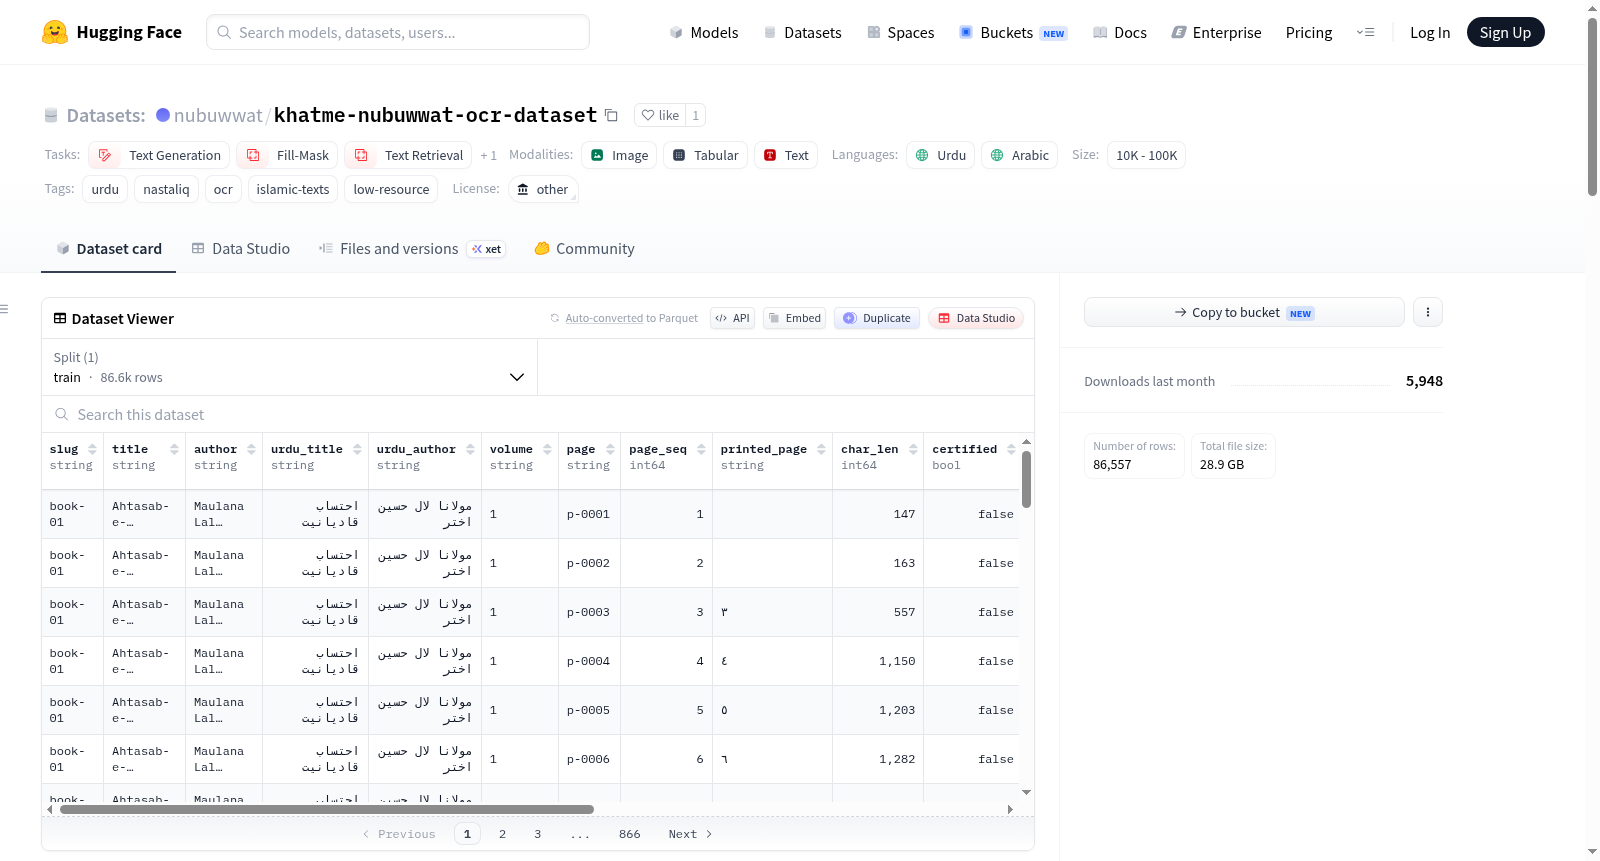
Khatme-Nubuwwat Urdu OCR Corpus 是一个结构感知的、完全OCR的文本数据集,包含约215本Urdu Khatme Nubuwat(先知封印)书籍/卷,总计约86,557页文本。这些书籍采用Nastaliq字体书写,包含大量古兰经和圣训引用。OCR流水线确保逐字转录,并通过多信号准确性层(包括字符语言模型、结构信号、词汇近失、规则集、神经上下文、与锚文本(古兰经+14本圣训集)验证以及内部共识)进行质量控制。每页数据包含三个文件:纯文本(.txt)、元数据JSON(.json)和页面扫描图像(.webp)。数据集按书籍组织,目录结构清晰。提供的Parquet文件(pages.parquet)每行对应一页,包含文本、元数据和图像引用。主要字段包括slug(书籍ID)、page(页数)、page_seq(PDF顺序)、printed_page(书籍页码)、char_len(字符数)、image(扫描图像)、certified(是否引用交叉验证)、citations(引用列表)、review_flagged(是否标记人工审核)、suspicion_score(怀疑分数)、review_reasons(审核原因)、text(纯文本)和text_tagged(带布局标签的文本)。此外,Parquet每行还包含书籍级元数据(title, author, urdu_title, urdu_author, volume)。数据集适用于Urdu/Arabic NLP任务,如语言建模、领域适应、OCR后校正、全文搜索/检索以及变音符号/正字法研究。数据集收录了215本书(去除了重复的118、119、120卷),并提供了Python加载示例(load_dataset)。
Khatme-Nubuwwat Urdu OCR Corpus is a structure-aware, fully OCRed text dataset comprising approximately 215 Urdu Khatme Nubuwat (Seal of Prophethood) books/volumes, totaling about 86,557 pages of text. These books are written in the Nastaliq font and contain numerous Quranic and Hadith citations. The OCR pipeline ensures word-by-word transcription and quality control through multiple signal accuracy layers, including character language model, structural signals, lexical near misses, rule sets, neural context, verification against anchor texts (Quran + 14 Hadith collections), and internal consensus. Each page consists of three files: plain text (.txt), metadata JSON (.json), and page scan image (.webp). The dataset is organized by book with a clear directory structure. The provided Parquet file (pages.parquet) has one row per page, containing text, metadata, and image references. Main fields include slug (book ID), page (page number), page_seq (PDF order), printed_page (book page number), char_len (character count), image (scan image), certified (whether cross-verified with citations), citations (list of citations), review_flagged (whether marked for manual review), suspicion_score (suspicion score), review_reasons (reasons for review), text (plain text), and text_tagged (text with layout tags). Additionally, each row includes book-level metadata (title, author, urdu_title, urdu_author, volume). The dataset is suitable for Urdu/Arabic NLP tasks such as language modeling, domain adaptation, OCR post-correction, full-text search/retrieval, and diacritics/orthography research. It contains 215 books (after removing duplicate volumes 118, 119, 120) and provides a Python loading example (load_dataset).
Khatme-Nubuwwat Urdu OCR 数据集概述
基本信息
- 数据集名称:Khatme-Nubuwwat Urdu OCR Corpus
- 语言:乌尔都语(ur)、阿拉伯语(ar)
- 许可协议:其他(other)
- 任务类别:文本生成、填充掩码、文本检索、图像到文本
- 数据规模:10K < n < 100K
数据内容
- 包含约 215 部乌尔都语 Khatme Nubuwat 书籍/卷,总计约 86,557 页 OCR 文本。
- 每页文本与源页面扫描图像配对。
- 书籍主要由 Nastaliq 散文构成,大量引用《古兰经》和圣训。
数据结构
每个页面包含三个独立文件:
.txt:干净页面文本.json:页面元数据、质量信号及带标签的 OCR 文本(含text_tagged字段).webp:源页面扫描图像
主要目录结构:
data/ ├── pages.parquet # 每页一行(文本+元数据+图像引用) └── books/ └── book-01/ ├── metadata.json # 书籍级元数据 └── pages/ ├── p-0001.txt ├── p-0001.json └── p-0001.webp
字段说明
Parquet / JSON 页面字段:
slug:书籍标识 IDpage:书内页码page_seq:PDF 中的页面顺序printed_page:书籍自身编号的页码char_len:干净文本的字符数image:扫描图像certified:是否检测并交叉验证了引用(对照锚文本)citations:检测到的引用列表(如abudawud:4002、Q26:221)review_flagged:是否被标记供人工审查suspicion_score:页面存在错误的怀疑度评分(仅在被标记时存在)review_reasons:触发审查的标记原因列表text:干净散文文本text_tagged:包含布局结构标签(@PAGE、@H1/@H2、@POEM、@BULLET、@REF、@DIV)的文本
书籍级元数据字段(metadata.json):
uid、slug、title、author、urdu_title、urdu_author、volume、source_pdf、npages(源 PDF 页数)、n_pages_ocr(转录页数)、n_pages_with_image(有扫描图像的页数)
Parquet 文件每行还额外携带书籍元数据列(标题、作者、乌尔都语标题、乌尔都语作者、卷号)。
数据处理与质量控制
OCR 流水线经过多层准确率验证:
- 字符语言模型惊奇度(Character LM surprisal)
- 指示污染的结构信号
- 语料库词典近失匹配
- 标记已知问题的规则集
- 神经上下文惊奇度(Neural Contextual surprisal)
- 对照锚文本(《古兰经》+ 14 本圣训集)进行验证
- 语料库内部共识(段落级)
使用说明
加载数据集: python from datasets import load_dataset
ds = load_dataset("nubuwwat/khatme-nubuwwat-ocr-dataset", split="train") print(ds[13]["text"]) # 干净乌尔都语文本 print(ds[13]["citations"]) # [abudawud:4002, Q26:221, ...]
预期用途:适用于乌尔都语/阿拉伯语 NLP,包括语言建模与领域自适应、OCR 后校正与评估、全文搜索/检索、变音符号/正字法等任务。
补充说明
- 书籍 118、119、120 因重复被有意移除,最终书籍总数为 215 部。
- 扫描图像来源于互联网公开资源,数据集创建者仅执行了 OCR 处理。
- 联系邮箱:nubuwwat@protonmail.com