OrionLLM/NanoThoughts
收藏资源简介:
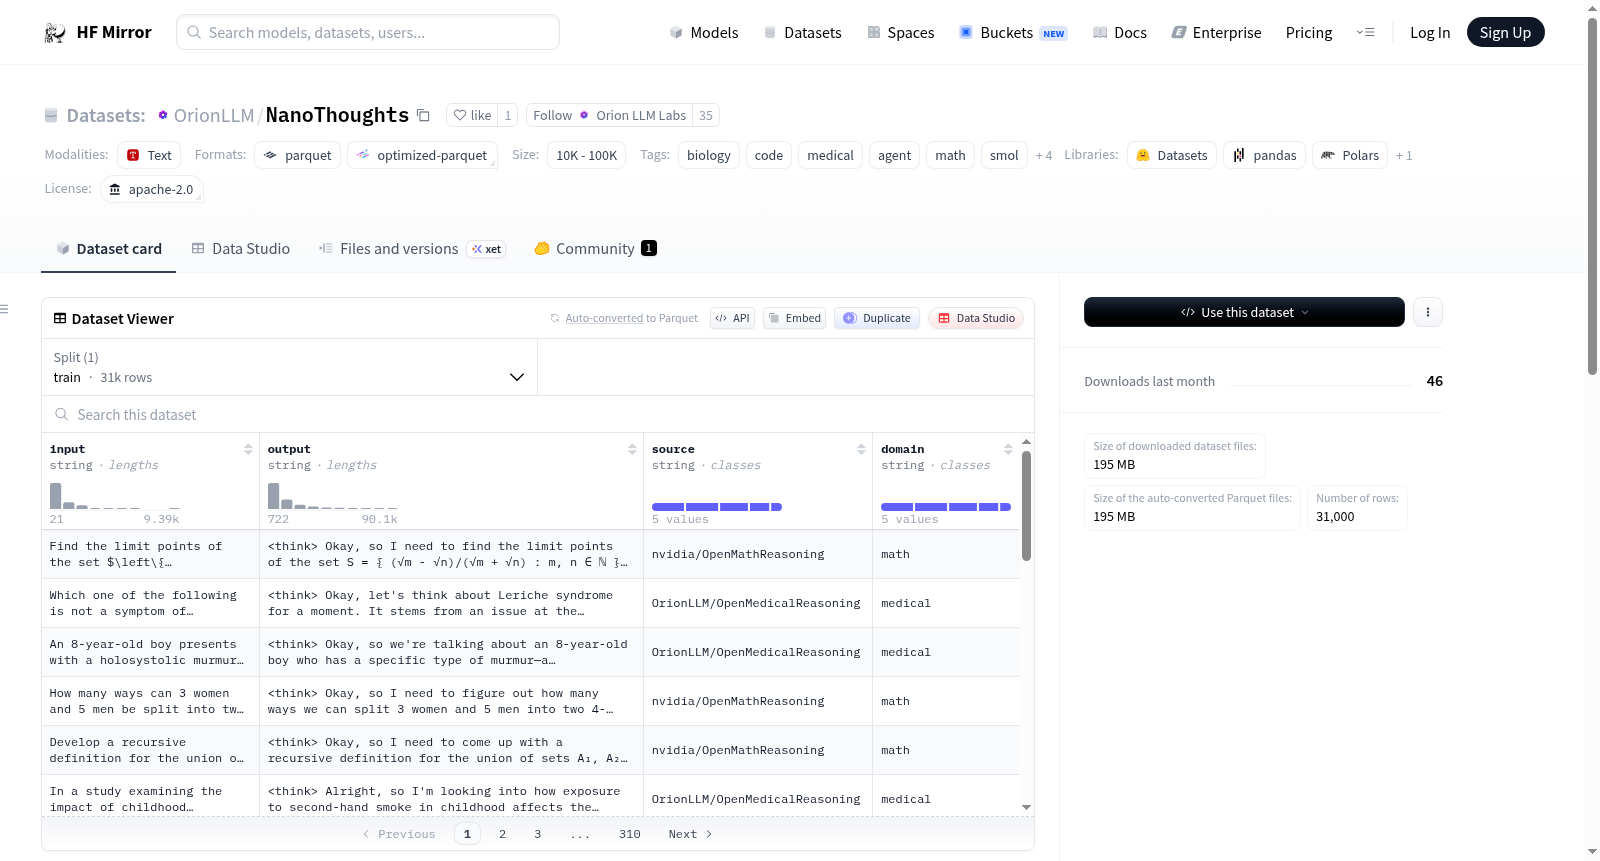
--- license: apache-2.0 tags: - biology - code - medical - agent - math - smol - small - reasoning - think - Thoughts --- # NanoThoughts ## 1. Introduction **NanoThoughts** is a **small-scale, general-purpose reasoning dataset** composed of approximately **31,000 samples**, specifically curated for **supervised fine-tuning (SFT)**. Unlike large-scale datasets that require heavy compute, NanoThoughts focuses on **efficiency and practicality**, making it ideal for: - Small models - Local training setups - Rapid experimentation - Lightweight reasoning enhancement --- ## 2. Dataset Composition The dataset is a curated mixture of multiple open reasoning datasets: | Source Dataset | Samples | |----------------|--------:| | [OpenCodeReasoning-mini](https://huggingface.co/datasets/nvidia/OpenCodeReasoning-mini) | 8,000 | | [OpenMedicalReasoning](https://huggingface.co/datasets/FreedomIntelligence/medical-o1-reasoning-SFT) | 7,000 | | [OpenMathReasoning-mini](https://huggingface.co/datasets/unsloth/OpenMathReasoning-mini) | 8,000 | | [Poseidon-Reasoning-Mini-300K](https://huggingface.co/datasets/PoseidonAI/Poseidon-Reasoning-Mini-300K) | 5,000 | | [Raiden-DeepSeek-R1](https://huggingface.co/datasets/RaidenAI/DeepSeek-R1-Distill) | 3,000 | **Total:** ~31,000 samples
许可证: apache-2.0 标签: - 生物学 - 代码 - 医学 - 智能体(agent) - 数学 - smol - 小型 - 推理 - 思考 - 思维 # NanoThoughts ## 1. 引言 **NanoThoughts** 是一款**小规模通用推理数据集**,包含约**31000个样本**,专为**监督微调(Supervised Fine-Tuning, SFT)** 定制打造。 与依赖大量计算资源的大规模数据集不同,NanoThoughts 聚焦**效率与实用性**,非常适配以下场景: - 小型模型训练 - 本地部署训练环境 - 快速实验验证 - 轻量级推理能力增强 ## 2. 数据集构成 本数据集为精选的多开源推理数据集混合集合: | 源数据集 | 样本数量 | |----------------|--------:| | [OpenCodeReasoning-mini](https://huggingface.co/datasets/nvidia/OpenCodeReasoning-mini) | 8000 | | [OpenMedicalReasoning](https://huggingface.co/datasets/FreedomIntelligence/medical-o1-reasoning-SFT) | 7000 | | [OpenMathReasoning-mini](https://huggingface.co/datasets/unsloth/OpenMathReasoning-mini) | 8000 | | [Poseidon-Reasoning-Mini-300K](https://huggingface.co/datasets/PoseidonAI/Poseidon-Reasoning-Mini-300K) | 5000 | | [Raiden-DeepSeek-R1](https://huggingface.co/datasets/RaidenAI/DeepSeek-R1-Distill) | 3000 | **总计:** 约31000个样本