
遇见数据集

MAIA-Madrid-IA/cibelex-graph-core-sampler

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

Cibelex知识图谱—核心采样器是马德里市Cibelex法规数据库的精选子集,使用LoRO本体进行标注,并以命名图Turtle文件序列化。该数据集由MAIA倡议(马德里市议会)构建和维护。它作为核心采样器,覆盖了市政条例、法规和有机法规的代表性切片,并故意包含同一法律文本的多个历史版本,以支持时间推理。数据集总共有350,258个三元组,包含9个命名图文件,捆绑了LoRO v1.0本体,采用知识共享署名4.0国际许可证。数据范围包括事件、特征、法律资源、法律资源细分、法律价值、组织、人员、角色和分类法等命名图。数据来源为马德里市议会的Cibelex法规数据库,使用扩展欧洲立法标识符的LoRO本体进行标注,覆盖地方政府特定的文档类型。

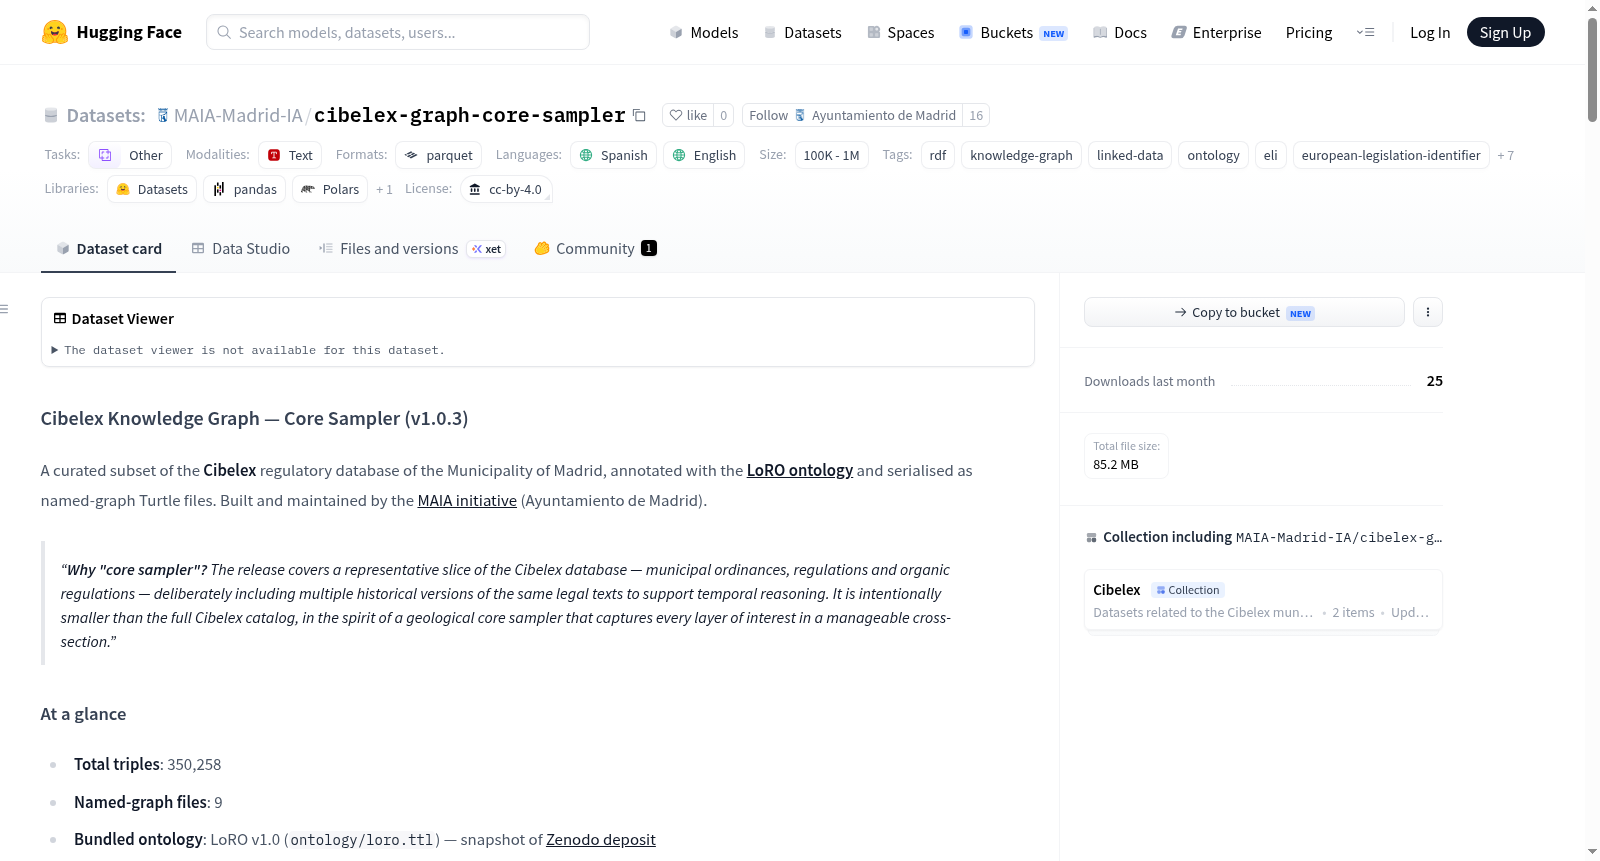
The Cibelex Knowledge Graph — Core Sampler is a curated subset of the Cibelex regulatory database of the Municipality of Madrid, annotated with the LoRO ontology and serialised as named-graph Turtle files. Built and maintained by the MAIA initiative (Ayuntamiento de Madrid). It serves as a core sampler, covering a representative slice of municipal ordinances, regulations and organic regulations, deliberately including multiple historical versions of the same legal texts to support temporal reasoning. The dataset contains a total of 350,258 triples, 9 named-graph files, bundled with the LoRO v1.0 ontology, and is licensed under Creative Commons Attribution 4.0 International. The data scope includes named graphs for events, features, legal resources, legal resource subdivisions, legal values, organizations, persons, roles, and taxonomies. The source corpus is the Cibelex regulatory database of the Municipality of Madrid, annotated with the LoRO ontology that extends the European Legislation Identifier to cover document types specific to local government.

提供机构:
MAIA-Madrid-IA
搜集汇总
数据集介绍
MAIA-Madrid-IA/cibelex-graph-core-sampler 数据集图片
构建方式
Cibelex知识图谱核心采样数据集是马德里市政府MAIA团队从Cibelex法规数据库中精心提取的一个代表性子集。该数据集采用LoRO本体(欧洲立法标识符ELI的本地政府扩展版本)进行语义标注,并以命名图Turtle格式序列化。其构建理念类似地质学中的岩心采样——在可控规模内保留所有感兴趣的层次,因此特意纳入了同一法律文本的多个历史版本以支持时序推理。数据通过可复现的构建流程生成,对特征坐标进行了WGS84标准化转换,并在发布前移除了待法律审查的描述性字段。
使用方法
使用者可通过多种方式利用该数据集:推荐使用配套的loro-fuseki容器快速部署SPARQL端点并构建全文索引;也可通过HuggingFace的snapshot_download下载Turtle文件后使用rdflib加载为RDF图。对于偏好数据框架的用户,可直接通过HuggingFace的datasets库加载Parquet格式数据,每行包含主语、谓语、宾语、对象类型、对象语言、对象数据类型和命名图IRI共7列,支持无缝回转为RDF格式。此外,cibelex-mcp-fuseki项目提供了基于Claude Code等工具的21种高层检索工具接口。
背景与挑战
背景概述
Cibelex知识图谱核心采样数据集由马德里市政府MAIA团队于2026年创建,聚焦西班牙城市法规领域,以LoRO本体对马德里市议会官方Cibelex法规数据库进行语义标注。该数据集在欧盟法律标识符(ELI)框架基础上,针对地方政府特有的文件类型进行本体扩展,构建了涵盖市政条例、规章及组织法规的代表性子集。其核心研究问题在于如何通过知识图谱技术实现地方性法规的语义化表示与时间推理,特别保留同一法律文本的多个历史版本以支持时序查询。作为首个采用LoRO本体的城市法规知识图谱开源数据集,它为地方政府法规的机器可读性研究提供了基准资源,推动了公共行政领域开放关联数据的研究范式。
当前挑战
该数据集面临的主要挑战包括:第一,领域问题层面,城市法规存在大量术语歧义、版本演进复杂及跨文档引用等特征,传统知识图谱难以精准捕获法规间的动态关联与分层结构,需通过ELI扩展本体与命名图技术实现细粒度语义表示。第二,构建过程中需处理多源异构数据的融合难题,如将Cibelex数据库中的原始法规文本转化为RDF三元组,并协调西班牙语与英语的双语标注。第三,隐私保护与合规性要求严格,尤其是特征描述字段因含公共官员姓名而被迫移除,需在后续版本中通过数据保护评估后谨慎恢复。第四,地理坐标数据的清洗与标准化,需将逗号分隔的字符串格式转换为WGS84标准浮点数值,确保空间查询的互操作性。
常用场景
经典使用场景
Cibelex知识图谱核心采样数据集是马德里市政府MAIA initiative推出的一个精心策划的知识图谱子集,专门用于表示地方市政法规之间的复杂语义关系。该数据集基于LoRO(地方法规本体)进行标注,并采用命名图Turtle格式序列化,保留了法规文本的多个历史版本以支持时间推理。研究人员通常利用该数据集进行知识图谱构建与验证实验,测试本体驱动的法规建模方法,或者将其作为SPARQL查询的基准数据集,评估语义查询引擎在法律领域的性能表现。
解决学术问题
该数据集解决了法律知识工程领域中一个长期存在的难题:如何在细粒度的城市级别上结构化表征法规文档及其演变轨迹。传统法律知识图谱多关注国家或国际层面的立法,鲜有触及地方政府的行政规章体系。Cibelex核心采样通过LoRO本体扩展了欧洲立法标识符(ELI)框架,首次为市政法规定制了包含事件、角色、组织机构等多维度的语义模型,为研究法规间引用关系、时间版本差异以及地理空间关联提供了标准化数据基础,显著推动了数字政府背景下的法律本体工程研究。
实际应用
在实际应用中,该数据集支撑了市政法规智能管理系统的构建。基于Cibelex知识图谱,开发人员可以搭建法规检索问答系统,允许市民或行政人员通过自然语言查询特定规章的现行有效版本及其修订历史。数据集提供的Parquet格式统一三表结构还简化了与机器学习流水线的集成,可用于训练大语言模型进行法规知识问答或文档摘要生成。此外,配套的loro-fuseki容器和cibelex-mcp-fuseki MCP服务器使得该知识图谱可直接被Claude Code等AI助手访问,为市政工作人员打造出智能化法规咨询工具的原型。
数据集最近研究
最新研究方向
马德里市议会推出的Cibelex知识图谱核心样本数据集,基于LoRO本体对市政法规进行语义标注,并将欧洲立法标识符体系扩展至地方政府领域,为公共行政法律的机器可读化与智能化分析开辟了新的路径。该数据集精心保留了同一法律文本的多个历史版本以支撑时序推理,并通过去敏化处理在合规前提下呈现公职人员角色信息,成为知识图谱与法律科技交叉领域的前沿研究基石。其配套的SPARQL端点与MCP服务器实现了自然语言查询接口,使大型语言模型能够直接与结构化法规知识进行对话,为政务智能问答、合规审查自动化及法规演变可视化等热点应用提供了宝贵的数据基础设施。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

