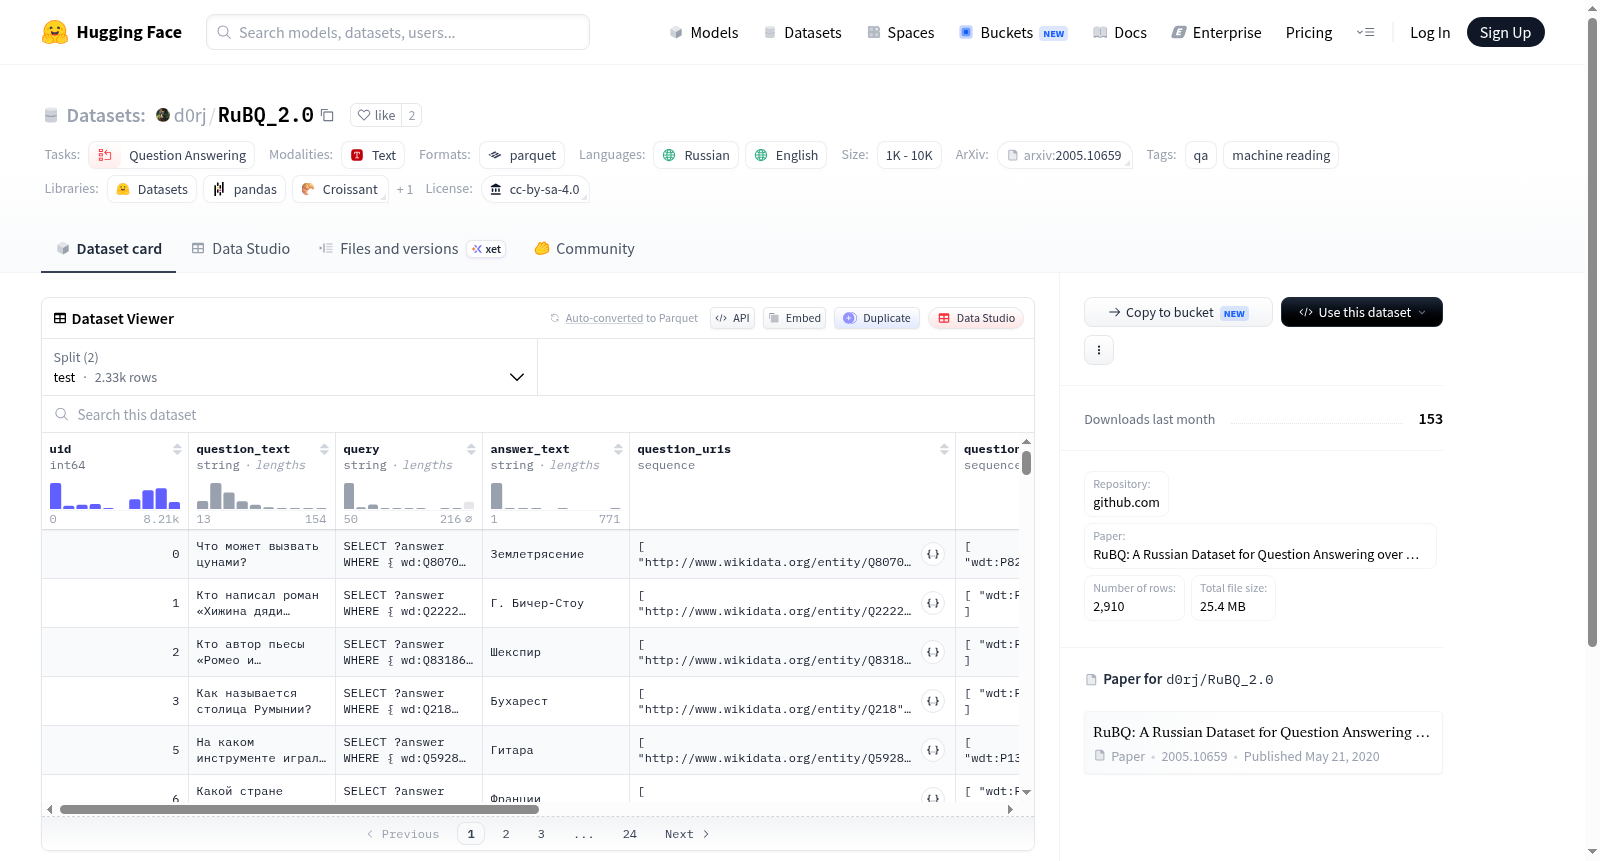
d0rj/RuBQ_2.0
收藏资源简介:
--- configs: - config_name: default data_files: - split: test path: data/test-* - split: dev path: data/dev-* dataset_info: features: - name: uid dtype: int64 - name: question_text dtype: string - name: query dtype: string - name: answer_text dtype: string - name: question_uris sequence: string - name: question_props sequence: string - name: answers list: - name: datatype dtype: string - name: label dtype: string - name: type dtype: string - name: value dtype: string - name: wd_names struct: - name: en sequence: string - name: ru sequence: string - name: wp_names sequence: string - name: xml:lang dtype: string - name: paragraphs_uids struct: - name: all_related sequence: int64 - name: with_answer sequence: int64 - name: tags sequence: string - name: RuBQ_version dtype: string - name: question_eng dtype: string splits: - name: test num_bytes: 1992076 num_examples: 2330 - name: dev num_bytes: 488914 num_examples: 580 download_size: 0 dataset_size: 2480990 license: cc-by-sa-4.0 task_categories: - question-answering language: - ru - en tags: - qa - machine reading source_datasets: - original pretty_name: RuBQ 2.0 size_categories: - 1K<n<10K paperswithcode_id: rubq --- # RuBQ 2.0 ## Dataset Description - **Repository:** https://github.com/vladislavneon/RuBQ/tree/master/RuBQ_2.0 - **Paper:** [RuBQ: A Russian Dataset for Question Answering over Wikidata](https://arxiv.org/abs/2005.10659) For training data see [d0rj/RuBQ_2.0-paragraphs](https://huggingface.co/datasets/d0rj/RuBQ_2.0-paragraphs).
配置项: - 配置名称:默认(default) 数据文件: - 划分集:测试集(test) 路径:data/test-* - 划分集:开发集(dev) 路径:data/dev-* 数据集信息(dataset_info): 特征字段: - 名称:uid,数据类型:64位整数(int64) - 名称:问题文本(question_text),数据类型:字符串(string) - 名称:查询语句(query),数据类型:字符串(string) - 名称:答案文本(answer_text),数据类型:字符串(string) - 名称:问题URI序列(question_uris),数据类型:字符串序列(sequence<string>) - 名称:问题属性序列(question_props),数据类型:字符串序列(sequence<string>) - 名称:答案列表(answers),数据类型:列表(list),列表元素结构: - 名称:数据类型(datatype),数据类型:字符串(string) - 名称:标签(label),数据类型:字符串(string) - 名称:类型(type),数据类型:字符串(string) - 名称:值(value),数据类型:字符串(string) - 名称:维基数据名称(wd_names),数据类型:结构体(struct),结构体字段: - 名称:英语(en),数据类型:字符串序列(sequence<string>) - 名称:俄语(ru),数据类型:字符串序列(sequence<string>) - 名称:维基百科名称(wp_names),数据类型:字符串序列(sequence<string>) - 名称:XML语言标识(xml:lang),数据类型:字符串(string) - 名称:段落UID(paragraphs_uids),数据类型:结构体(struct),结构体字段: - 名称:所有相关段落(all_related),数据类型:64位整数序列(sequence<int64>) - 名称:含答案段落(with_answer),数据类型:64位整数序列(sequence<int64>) - 名称:标签(tags),数据类型:字符串序列(sequence<string>) - 名称:RuBQ版本(RuBQ_version),数据类型:字符串(string) - 名称:英文问题(question_eng),数据类型:字符串(string) 划分集: - 名称:测试集(test),字节大小:1992076,样本数量:2330 - 名称:开发集(dev),字节大小:488914,样本数量:580 下载大小:0 数据集总大小:2480990 许可证:CC BY-SA 4.0 任务类别: - 问答(question-answering) 语言: - 俄语(ru) - 英语(en) 标签: - QA - 机器阅读(machine reading) 源数据集: - 原创数据集(original) 展示名称:RuBQ 2.0 样本规模类别:1000 < n < 10000 PapersWithCode 标识符:rubq # RuBQ 2.0 ## 数据集说明 - **代码仓库**:https://github.com/vladislavneon/RuBQ/tree/master/RuBQ_2.0 - **相关论文**:[RuBQ:面向维基数据(Wikidata)的问答俄语数据集](https://arxiv.org/abs/2005.10659) 训练数据请参考[d0rj/RuBQ_2.0-paragraphs](https://huggingface.co/datasets/d0rj/RuBQ_2.0-paragraphs)。
RuBQ 2.0 数据集概述
数据集描述
特征信息
- uid: 数据类型为 int64。
- question_text: 数据类型为 string。
- query: 数据类型为 string。
- answer_text: 数据类型为 string。
- question_uris: 数据类型为 sequence of string。
- question_props: 数据类型为 sequence of string。
- answers: 数据类型为 list,包含以下子特征:
- datatype: 数据类型为 string。
- label: 数据类型为 string。
- type: 数据类型为 string。
- value: 数据类型为 string。
- wd_names: 数据类型为 struct,包含以下子特征:
- en: 数据类型为 sequence of string。
- ru: 数据类型为 sequence of string。
- wp_names: 数据类型为 sequence of string。
- xml:lang: 数据类型为 string。
- paragraphs_uids: 数据类型为 struct,包含以下子特征:
- all_related: 数据类型为 sequence of int64。
- with_answer: 数据类型为 sequence of int64。
- tags: 数据类型为 sequence of string。
- RuBQ_version: 数据类型为 string。
- question_eng: 数据类型为 string。
数据分割
- test: 包含 2330 个样本,总字节数为 1992076。
- dev: 包含 580 个样本,总字节数为 488914。
数据集大小
- 下载大小: 0 字节。
- 数据集大小: 2480990 字节。
许可
- 数据集遵循 cc-by-sa-4.0 许可。
任务类别
- 问题回答 (question-answering)
语言
- 俄语 (ru)
- 英语 (en)
标签
- qa
- machine reading
数据源
- 原始数据 (original)
数据集名称
- RuBQ 2.0
数据集规模
- 1K<n<10K
相关ID
- paperswithcode_id: rubq