
遇见数据集

instruct-pashto-h-school

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

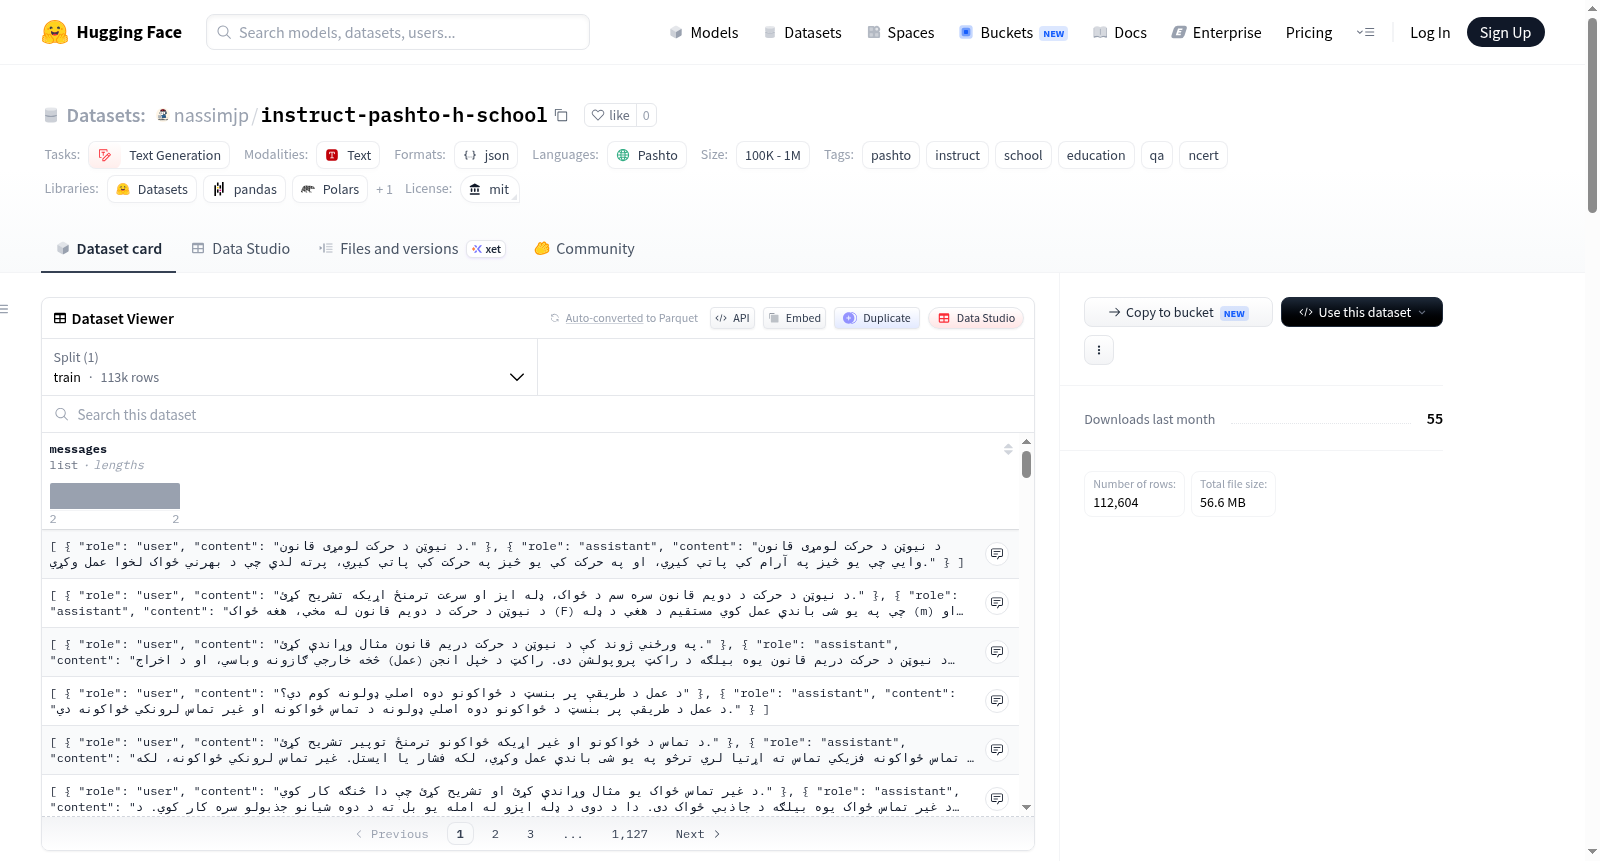
Instruct Pashto School 是一个普什图语(Pashto)教育问答指令数据集,专门为训练普什图语指令跟随大语言模型而设计。该数据集源自NCERT风格的教育内容,包含学校6至12年级多个学科的标准化问答对。数据集采用JSONL格式,遵循Ministral-Instruct模式,每条记录包含用户提问和助手回答的简单对话结构,无额外元数据,且已进行去重和清理处理,可直接用于监督微调。数据集规模为112,604个唯一问答对,全面覆盖科学(6-10年级)、生物学、化学、物理学、经济学(11-12年级)、商业研究、会计学、地理、历史、政治科学、社会学以及社会科学等多个学科领域。其主要用途包括:开发普什图语教育大语言模型、学校科目辅导、通用知识问答系统、指令跟随模型训练以及多语言教育研究。数据集基于MIT许可证发布,原始内容来源于相关作者的宽松许可数据集,转换和结构化工作由Nsibullah Nassim完成。

Instruct Pashto School is a Pashto educational question-answering instruction dataset specifically designed for training Pashto instruction-following large language models. This dataset is derived from NCERT-style educational content and contains standardized question-answering pairs across multiple subjects for grades 6 to 12 in schools. The dataset is in JSONL format and follows the Ministral-Instruct schema. Each record features a simple dialogue structure consisting of a user query and an assistant response, with no additional metadata. It has been deduplicated and cleaned, and is ready for direct use in supervised fine-tuning. The dataset has a scale of 112,604 unique question-answering pairs, comprehensively covering multiple subject areas including Science (Grades 6-10), Biology, Chemistry, Physics, Economics (Grades 11-12), Business Studies, Accounting, Geography, History, Political Science, Sociology, and Social Sciences. Its main applications include: developing Pashto educational large language models, school subject tutoring, general knowledge question-answering systems, instruction-following model training, and multilingual educational research. The dataset is released under the MIT License. Its original content is sourced from a loosely licensed dataset by the relevant authors, and the conversion and structuring work was completed by Nsibullah Nassim.

创建时间:
2026-06-25
搜集汇总
数据集介绍
instruct-pashto-h-school 数据集图片
构建方式
该数据集基于NCERT教育内容进行深度处理与转换,保留了学校课程知识的完整性与权威性。原始数据来源于NCERT_Dataset,经过清洗、去重与结构优化,最终以Ministral-Instruct对话格式呈现。每条样本被组织为包含用户问题与助手回答的JSONL记录,确保了数据的简洁性与直接可用性,专为Pashto语言下的指令微调任务而设计。
使用方法
该数据集以JSONL格式存储,可直接用于监督微调(SFT)流程。每条记录遵循标准的“messages”结构,包含user与assistant两个角色,用户可通过HuggingFace Datasets库轻松加载,并配合常见的训练框架(如Transformers、Axolotl或SFTTrainer)进行模型微调。数据集特别适用于开发Pashto语言的问答系统、教育辅导机器人以及多语言教育研究中的指令跟随模型训练。
背景与挑战
背景概述
在自然语言处理领域,针对低资源语言的指令微调数据集构建是推动多语言大语言模型发展的重要一环。普什图语作为阿富汗及巴基斯坦部分地区的主要语言,因其语料稀缺与复杂形态,长期缺乏高质量的教育领域指令数据。2026年,由Nsibullah Nassim主导的研究团队基于印度NCERT教育内容,构建了名为Instruct Pashto School的数据集。该数据集包含超过11万条覆盖6至12年级多学科的普什图语问答对,旨在为普什图语教育大语言模型提供监督微调资源。其发布填补了普什图语在教育与指令跟随任务中的数据集空白,对低资源语言的多语言教育研究具有重要推动意义。
当前挑战
该数据集的核心挑战在于解决低资源语言教育领域的指令跟随问题。普什图语语法复杂且数字资源匮乏,现有大语言模型在此语言上的表现远弱于高资源语言,需要专门数据集增强其教育问答与多学科内容生成能力。构建过程中,团队面临两大困难:一是将NCERT英文教育内容精准翻译为普什图语时需兼顾学科术语的准确性与文化适配性;二是从原始教材中提取并清理超过11万条QA对,需去除冗余、保证格式统一,并严格遵循Ministral-Instruct对话架构。这些挑战要求在数据质量和规模之间取得平衡,以产出可直接用于监督微调的标准化教育资源。
常用场景
经典使用场景
在低资源语言自然语言处理领域,Instruct Pashto School数据集为普什图语的指令微调开辟了全新路径。该数据集凝聚了从六年级至十二年级的NCERT式教育问答精华,涵盖科学、生物学、化学、物理学、经济学、地理学、历史学等十余个学科,共计112,604对高质量问答。其经典使用场景在于训练普什图语大语言模型(LLM)的指令跟随能力,使模型能够理解并回应用户以普什图语提出的学术问题,从而填补普什图语在教育智能交互场景中的空白。
解决学术问题
长期以来,普什图语因资源匮乏,在教育领域的自然语言处理研究中面临数据缺失与模型泛化能力不足的困境。该数据集精准回应了低资源语言指令微调中的核心学术问题:如何构建跨学科、结构化的教学问答数据以提升模型教育知识推理能力。它使得研究者能够探索普什图语LLM在学术语境下的生成质量与准确性,推动多语言教育模型从“通用翻译”阶段迈向“本土化学科问答”阶段,进一步深化了低资源语言教育智能化的理论基础。
实际应用
在实际部署中,该数据集赋能了普什图语智能教育辅导系统的构建。基于此数据集微调的模型可用于开发面向普什图语学生的虚拟助教,支持在科学、社会科学、商学等学科上进行自动答疑、知识点检索与学习进度追踪。此外,该数据集还被应用于普什图语社区的通用知识问答平台和移动端教育应用中,为母语为普什图语的学生与教师提供流畅、标准的本地语言学习与教学支持,显著降低使用英语或其他主流语言带来的认知门槛。
数据集最近研究
最新研究方向
该数据集聚焦于低资源语言普什图语的教育领域指令微调,通过将印度NCERT课程内容转换为高质量、去重后的问答对,为普什图语大语言模型在6至12年级多学科教学场景中的指令跟随能力提供训练支撑。其研究成果不仅填补了该语种在教育NLP领域的空白,还对推动南亚及中亚地区多语言教育公平、构建包容性智能辅导系统具有深远意义,尤其契合当前全球对低资源语言数字化与文化传承的迫切需求。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

