
遇见数据集

SupraLabs/reasoning-corpus-4K-5M-v1

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

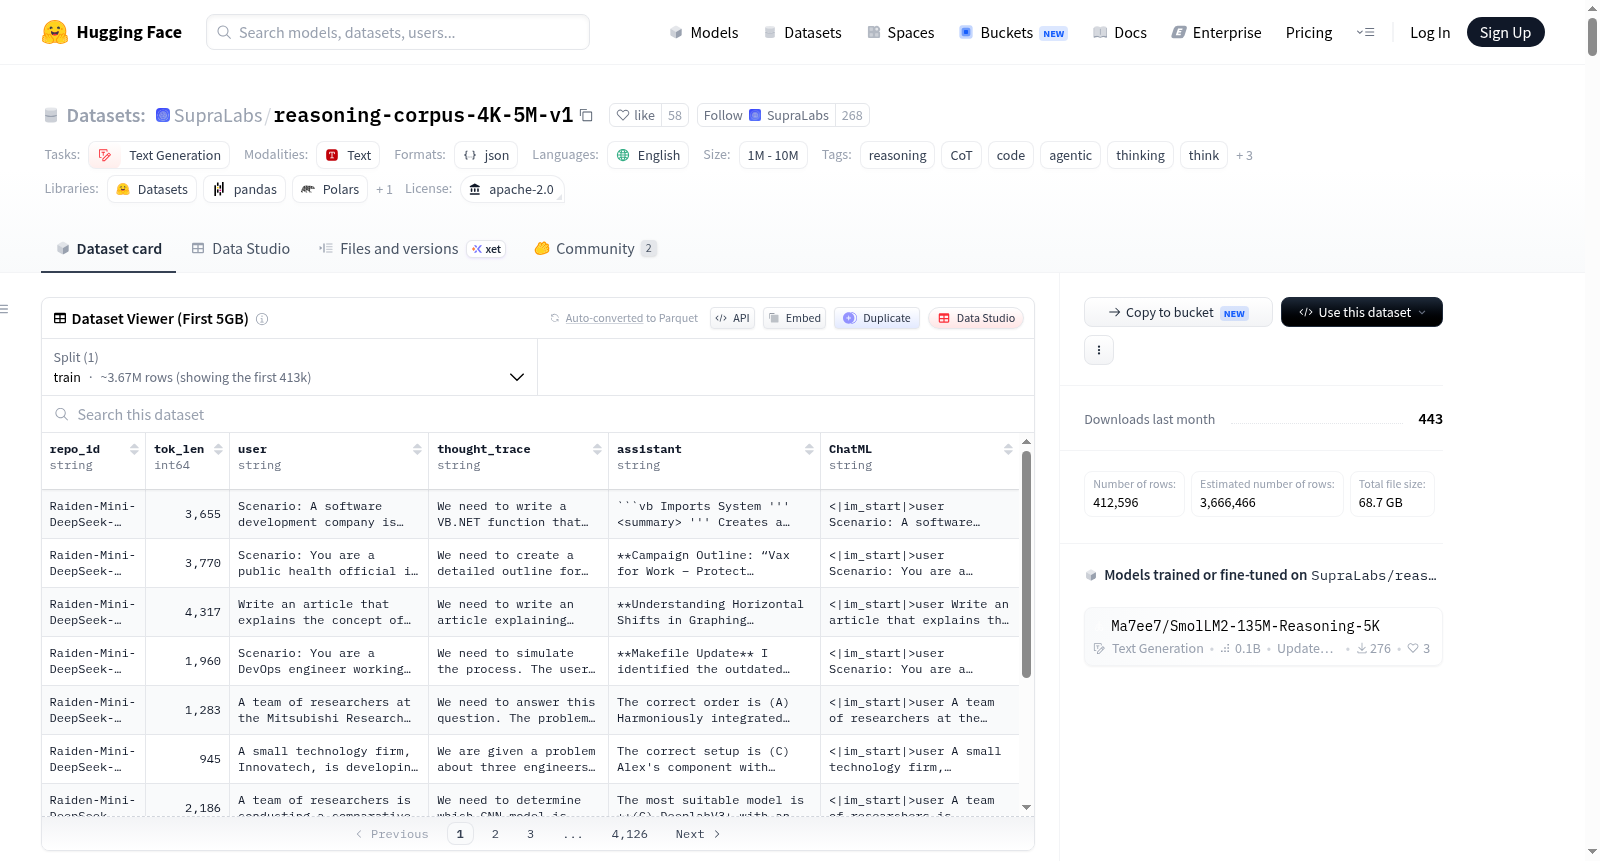
该数据集包含来自主流AI模型的推理链,例如:DeepSeek-v4(包括Pro和Flash版本)、DeepSeek-r1(DS-r1、Llama-DS、Qwen-DS)、Qwen3、Qwen3.5/3.6(包括开源和API模型)、Gemma4-31B等,这些数据来源于许多其他仓库,并经过适当过滤以用于训练SLM(小语言模型)。数据集包含以下列供用户筛选:repo_id、tok_len、user、thought_trace、assistant、ChatML。它是一个混合了多个较小仓库的推理语料库,总规模在500万序列长度以内,专注于推理、思维链(CoT)、代码和代理思维等任务。

This dataset comprises reasoning chains derived from mainstream AI models, such as DeepSeek-v4 (covering Pro and Flash variants), DeepSeek-r1 (including DS-r1, Llama-DS, Qwen-DS), Qwen3, Qwen3.5/3.6 (encompassing both open-source and API-deployed models), Gemma4-31B, and others. The data is sourced from multiple external repositories and properly filtered for training Small Language Models (SLMs). The dataset offers the following columns for users to conduct filtering: repo_id, tok_len, user, thought_trace, assistant, and ChatML. This is a reasoning corpus aggregated from several smaller repositories, with a total sequence length not exceeding 5 million, focusing on tasks including reasoning, Chain-of-Thought (CoT), code, and AI Agent thinking.
提供机构:
SupraLabs
搜集汇总
数据集介绍
SupraLabs/reasoning-corpus-4K-5M-v1 数据集图片
构建方式
该数据集是经由系统化整合多个高质量开源推理语料库而得来。研究者从glaiveai、PrimeIntellect、BAAI、NVIDIA、OpenThoughts等数十个优质数据源中,精心筛选并聚合了以推理链为核心的多领域对话与文本片段。这些语料涵盖了科学、数学、编程、金融、医学等众多方向,确保了数据的广度和专业性。在构建过程中,团队对原始数据进行了一系列质量过滤与标准化处理,尤其将序列长度严格限制在5k token以内,并保留了repo_id、token长度、用户输入、思考轨迹、模型回复以及ChatML格式等关键字段,以支持下游任务的灵活适配。
特点
该数据集最为突出的特点在于其大规模的多样化推理链集合。总计超过800万条数据记录、约90亿token的总容量,使其成为训练小型语言模型在复杂推理任务上表现的绝佳资源。数据集中不仅包含广泛的通用场景(如数学、科学、代码),还涉及金融经济学、医学、多语言STEM等专业领域,极大提升了模型的泛化能力。同时,每条数据都提供了完整的思考轨迹(thought_trace),这使得模型能够学习到从初始问题到最终答案的逐步推理过程,对于提升模型的逻辑推理能力尤为关键。此外,数据量的丰沛与模型的多元性(包括来自DeepSeek、Qwen、Gemma、Claude等知名模型的输出),也为深入研究模型间的推理模式对比提供了可能。
使用方法
该数据集的使用方式极为灵活。用户可以直接利用HuggingFace的datasets库加载整个数据集,或根据特定需求筛选子集。数据集提供了repo_id、tok_len、user、thought_trace、assistant及ChatML等多个字段,用户可通过这些字段实现精细化的数据过滤,例如按照来源模型、序列长度或具体领域进行筛选,快速构建针对性的训练或验证集。该数据集主要用于有监督微调(SFT)场景,尤其适合希望增强小模型推理、代码生成或自主代理(agentic)能力的开发者。加载后,用户可根据自身模型的格式要求,将数据转化为标准的对话模板或文本生成格式进行训练。
背景与挑战
背景概述
在大型语言模型(LLM)能力急速演进的浪潮中,如何使小型语言模型(SLM)具备复杂推理(reasoning)与链式思考(Chain-of-Thought, CoT)能力,已成为自然语言处理领域的核心命题。由HuggingFace社区多个团队协作构建的reasoning-corpus-4K-5M-v1数据集,于2025年初问世,汇聚了DeepSeek-v4、Qwen3、Gemma4等前沿大模型的推理链,以及来自glaiveai、PrimeIntellect、BAAI等十余个知名仓库的优质语料。该数据集以序列长度不超过5000 tokens为约束,精细融合了多达250万条高质推理数据,旨在通过监督微调(SFT)推动SLM在数学、代码、科学等领域的深度推理泛化。其精细划分的repo_id、tok_len、thought_trace等字段,为研究者提供灵活筛选机制,成为蒸馏大型推理模型能力至轻量级模型的关键资源。
当前挑战
该数据集旨在攻克两大核心挑战。其一,SLM在自然语言推理中的性能瓶颈,传统微调数据多偏重指令遵循或单轮问答,缺乏多步骤、可回溯的隐式推理轨迹,导致小模型在数学证明、多跳推理、代码生成等场景中表现孱弱,数据集通过捕捉大模型的思考痕迹(thought_trace)为SLM提供可迁移的推理范本。其二,构建过程中面临异构数据融合的难题,来自不同来源的数据在格式、质量、领域分布上参差不齐,数据清洗和去重工作复杂繁重;同时,需裁剪并统一标准化长序列至4K以内以适配SLM上下文窗口,还要防止关键推理步骤的语义断裂,这对注释均衡性、语言学保真度及token对齐策略提出了较高的工程与学术要求。
常用场景
经典使用场景
在大型语言模型能力持续跃迁的背景下,reasoning-corpus-4K-5M-v1数据集凭借其囊括DeepSeek-v4、Qwen3、Gemma4等前沿模型推理链的独特优势,成为监督微调(SFT)与知识蒸馏的经典训练素材。该数据集精心聚合了来自glaiveai、PrimeIntellect、BAAI等数十个优质开源仓库的推理轨迹,覆盖数学、科学、代码、金融乃至多语言STEM等多元领域。其核心用途在于为小型语言模型(SLM)注入复杂的思维链(CoT)与智能体推理能力,通过丰富的thought_trace和ChatML格式数据,指导模型学习从多步骤解题到工具调用的完备认知路径,从而在参数受限条件下实现推理效能的显著跃升。
实际应用
在实际产业应用中,该数据集所驱动的微调模型被广泛部署于智能编程辅助、教育答疑系统及企业级知识问答平台等场景。基于其高质量推理链训练的模型能够胜任自动代码审查与Bug根因定位,为开发者提供步骤清晰的优化建议;在在线教育领域,模型可模拟教师思维过程,针对数理问题生成具有逻辑层次的讲解内容,显著提升助学效率。此外,得益于数据集中涵盖的金融经济与医疗领域推理实例,定制化模型已被尝试用于风险评估与临床诊断辅助,展现出在专业决策支持系统中的强大适应力与广阔的商业化前景。
衍生相关工作
围绕该数据集的整合与高质量特性,学界与工业界已衍生出一系列具有影响力的经典工作。例如,基于其不同模型源的推理轨迹差异分析,研究者提出了跨架构推理迁移学习方法,系统揭示了思维链长度与任务难度的非线性关系;另一支工作则利用该数据集的代码推理子集,构建了面向软件工程的专项微调范本,显著提升了模型在单元测试生成与仓库级重构中的表现。此外,该数据集中来自OpenThoughts、Magpie-Align等仓库的独特样本,更催生了关于多轮交互深度推理与自洽性校验的前沿探索,为下一代自主智能体的基础模型训练确立了重要参照。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

