thousand-token-wood-traces
收藏资源简介:
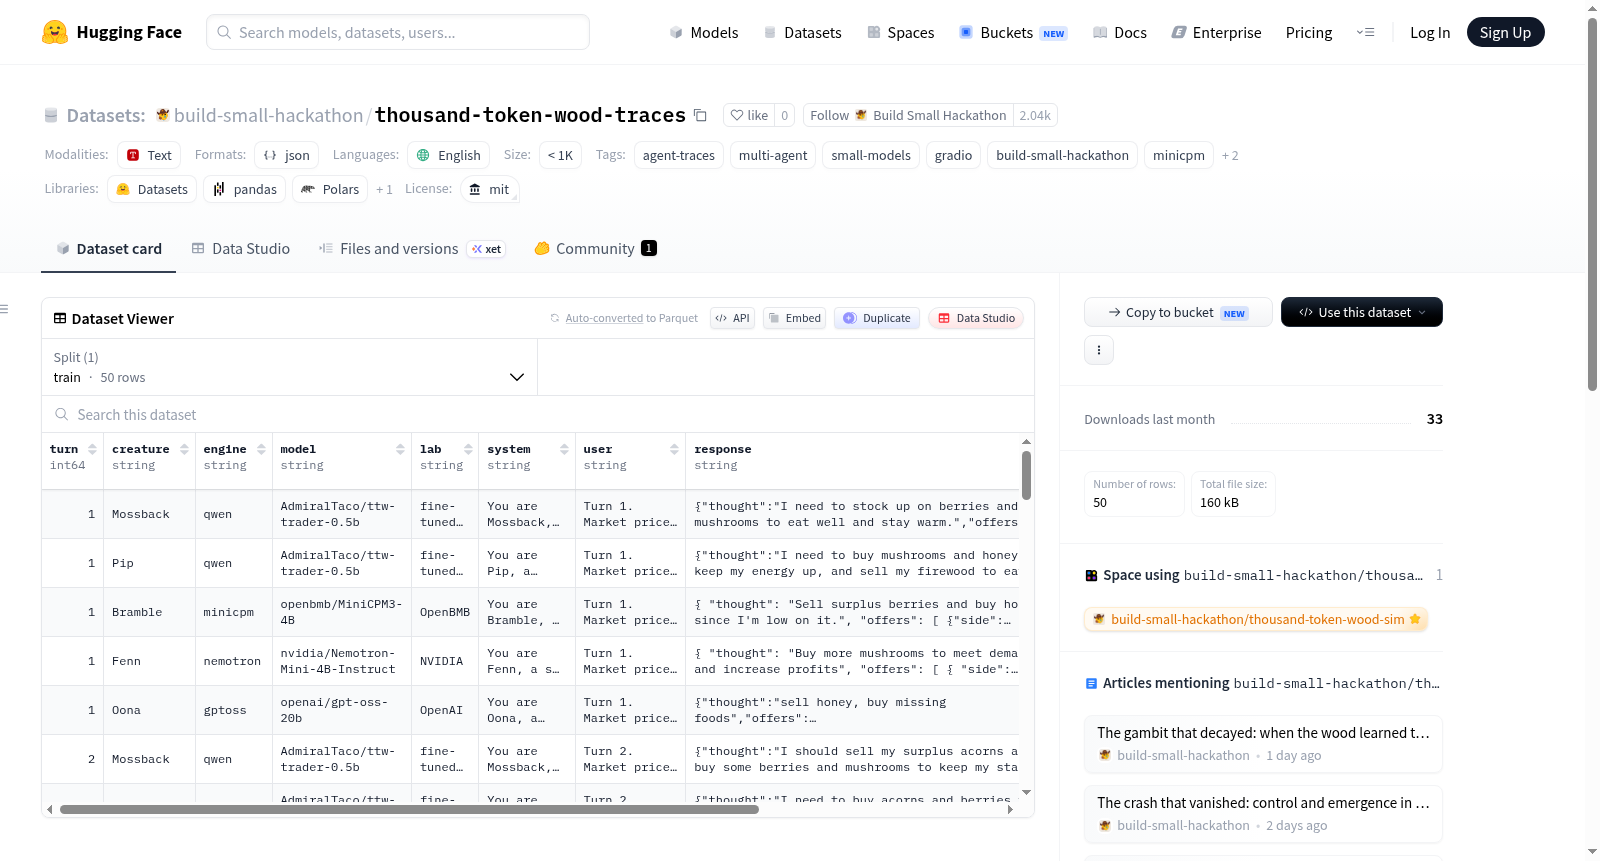
Thousand Token Wood -- Council Agent Traces数据集包含来自Thousand Token Wood模拟环境的开放智能体轨迹。该环境是一个微型涌现经济体,其中有五个林地生物(猫头鹰Oona、松鼠Bramble、狐狸Fenn、乌龟Mossback和老鼠Pip)使用鹅卵石进行商品交易、传播八卦,并对经过重新包装的市场历史(称为Wood Legends)做出反应。每个生物由来自不同实验室的小型语言模型驱动,总参数规模被限制在29.5B到32B之间,具体包括:OpenAI的GPT-OSS-20B、OpenBMB的MiniCPM3-4B、NVIDIA的Nemotron-Mini-4B-Instruct,以及项目方自己微调的AdmiralTaco/ttw-trader-0.5b。数据以行为单位记录每个生物的每个回合,包含了模型接收到的完整系统提示和用户提示、原始的JSON格式模型响应、解析后的交易报价和八卦列表、智能体的私密thought推理过程,以及生成该条记录的引擎、模型和实验室信息。该数据集旨在支持对多个实验室的小型模型在相同环境状态下的决策行为进行比较分析。它最初是为Build Small Hackathon的Sharing is Caring奖励任务而创建和共享的。数据字段包括:回合编号(turn)、生物名称(creature)、引擎(engine)、模型(model)、实验室(lab)、系统提示(system)、用户提示(user)、原始响应(response)、私密推理(thought)、报价列表(offers)和八卦列表(gossip)。
Thousand Token Wood -- Council Agent Traces dataset contains open-ended agent traces sourced from the Thousand Token Wood simulated environment. This environment is a miniature emergent economy, where five woodland creatures—Oona the Owl, Bramble the Squirrel, Fenn the Fox, Mossback the Tortoise, and Pip the Mouse—utilize pebbles to conduct commodity trading, spread gossip, and react to repackaged market history referred to as Wood Legends. Each creature is powered by small language models from different laboratories, with their total parameter scales ranging from 29.5B to 32B, specifically including: OpenAI's GPT-OSS-20B, OpenBMB's MiniCPM3-4B, NVIDIA's Nemotron-Mini-4B-Instruct, and the project team's own fine-tuned model AdmiralTaco/ttw-trader-0.5b. The dataset records each creature's per-turn actions, with each entry containing the complete system prompts and user prompts received by the model, the original JSON-formatted model responses, parsed trading offers and gossip lists, the agent's private thought-based reasoning process, as well as the engine, model and laboratory information used to generate that entry. This dataset aims to support comparative analysis of the decision-making behaviors of small models from multiple laboratories under identical environmental states. It was originally created and shared for the Sharing is Caring award task of the Build Small Hackathon. The data fields are as follows: turn number (turn), creature name (creature), engine (engine), model (model), lab (lab), system prompt (system), user prompt (user), raw response (response), private reasoning (thought), offer list (offers), and gossip list (gossip).
数据集概述:Thousand Token Wood -- Council Agent Traces
该数据集记录了来自 Thousand Token Wood 模拟环境的智能体交互轨迹。这是一个小型涌现式经济体,五个森林生物使用鹅卵石交易商品、闲聊,并回应改编自市场历史的“Wood Legends”。
数据集的核心是每个生物在游戏中的行动回合,记录了它们收到的完整提示、原始输出和解析后的行为,旨在比较不同小型语言模型在相同市场状态下的决策差异。该数据集为 Build Small Hackathon(构建小型黑客马拉松) 的“Sharing is Caring”奖励任务而共享。
数据集的生物与模型
每个生物使用来自不同实验室的小型模型(引擎预算为 29.5B ≤ 32B)进行推理:
| 生物(角色) | 模型 | 所属实验室 |
|---|---|---|
| Oona(猫头鹰) | openai/gpt-oss-20b | OpenAI |
| Bramble(松鼠) | openbmb/MiniCPM3-4B | OpenBMB |
| Fenn(狐狸) | nvidia/Nemotron-Mini-4B-Instruct | NVIDIA |
| Mossback(乌龟) + Pip(老鼠) | AdmiralTaco/ttw-trader-0.5b | 微调(我方) |
数据集字段
每一行代表一个生物的一次行动回合,字段说明如下:
| 字段名 | 类型 | 描述 |
|---|---|---|
turn |
int | 回合编号 |
creature |
str | 生物名称 |
engine |
str | 推理引擎 |
model |
str | 所用模型 |
lab |
str | 模型所属实验室 |
system |
str | 智能体收到的系统提示 |
user |
str | 智能体收到的用户提示 |
response |
str | 原始模型输出(已标准化,移除谐波通道) |
thought |
str / null | 智能体该回合的私有推理过程 |
offers |
list | 解析后的动作,格式为 {creature, side, good, price, qty} |
gossip |
list[str] | 智能体广播的传闻 |
许可证与标签
- 许可证:MIT
- 语言:英语(
en) - 标签:
agent-traces,multi-agent,small-models,gradio,build-small-hackathon,minicpm,nemotron,gpt-oss