
遇见数据集

GettyImages/customdataset

收藏
Hugging Face2026-06-03 更新2026-06-14 收录
官方服务:

资源简介:

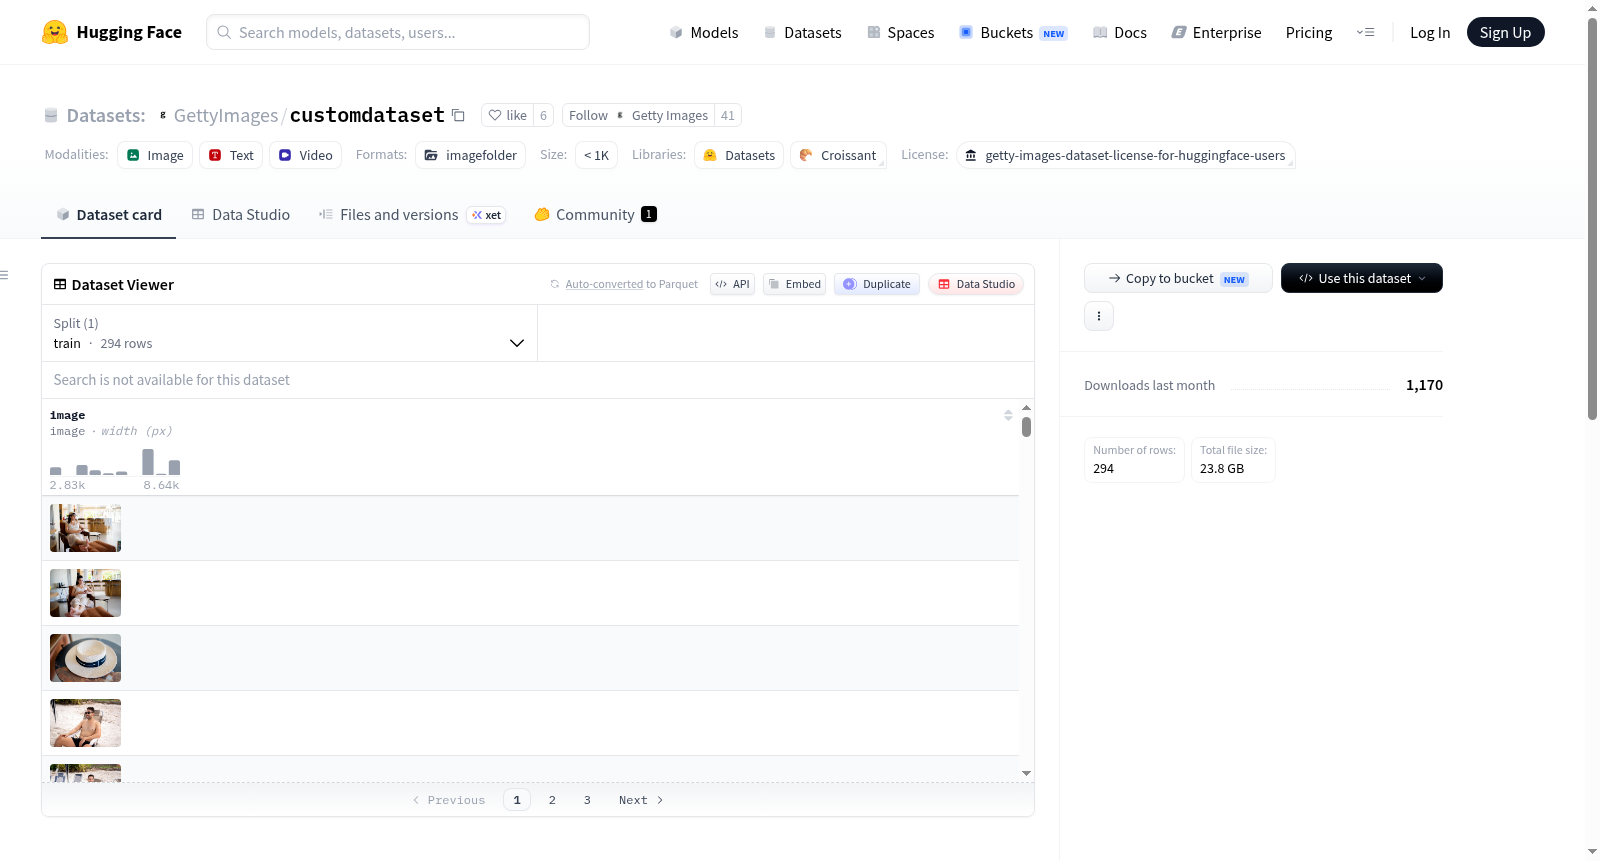
该数据集是Getty Images创建的一个示例自定义数据集,旨在展示其在AI训练中的数据提供能力,并激发用户在训练或微调模型时的需求。数据集包含98组文件,每组包括:描述最终场景的提示文本(TXT格式)、对象的图像(JPG和ARW格式)、人的图像(JPG、DNG和ARW格式)、人与对象交互的图像(JPG和ARW格式),以及人与对象交互的视频(MOV和MP4格式)。数据集呈现了一个图像序列,从独立对象开始,到人,最后是人与对象的交互。总共有784个独特资产。该数据专为用户及其模型训练提供,具有独家性和差异性优势。

This is a sample custom dataset developed by Getty Images, aimed at demonstrating its data provision capabilities for AI training and sparking user demand for model training or fine-tuning. The dataset includes 98 sets of files, each containing: prompt text (in TXT format) describing the final target scene, images of objects in JPG and ARW formats, images of human individuals in JPG, DNG and ARW formats, images of human-object interactions in JPG and ARW formats, and videos of human-object interactions in MOV and MP4 formats. The dataset presents an ordered image sequence, progressing from standalone objects, to individual humans, and finally to scenes of human-object interactions. There are 784 unique assets in total. This data is exclusively provided to support users' model training and fine-tuning work, with exclusive and differentiating advantages.
提供机构:
GettyImages
搜集汇总
数据集介绍
GettyImages/customdataset 数据集图片
构建方式
该数据集由Getty Images精心构建,旨在展示其定制化数据集的生成能力。样本数据以序列化方式组织,从单一物体图像逐步过渡至人物图像,最终呈现人与物体的交互场景。数据集共包含98组文件,每组提供8个独立资产,涵盖图像与视频等多种格式。具体而言,每组包含一个描述最终场景的提示文本(TXT格式)、一张物体图像(JPG和ARW格式)、一张人物图像(JPG、DNG和ARW格式)、一张人物与物体交互图像(JPG和ARW格式),以及一段交互视频(MOV和MP4格式)。总计784个独特资产,确保了数据的多样性与结构化,适用于从基础对象识别到复杂交互分析的训练需求。
特点
该数据集的核心特点在于其高度的定制化与专业导向。数据由Getty Images的顶尖创意总监和制片人参与策划,通过大规模拍摄实现场景的精细化控制,为用户提供独家且差异化的训练素材。每个样本均由单一物体到人物交互的逻辑递进,有助于模型学习从简单到复杂的视觉关系。多格式资产(包括原始RAW文件和压缩格式)的混合配备,增强了数据对模型训练任务的适应性。数据集仅限用户和其模型训练使用,确保了数据的专属性和商业优势,尤其适合需要高质量视觉数据的AI训练场景。
使用方法
该数据集可用于多种AI模型训练或微调任务,特别是视觉理解与生成模型。用户可直接利用提供的一组成套文件进行训练:提示文本(TXT)作为输入描述,图像与视频作为目标输出,支持监督学习中的配对数据机制。由于数据包含物体、人物及交互三种状态,适合用于训练从对象检测、人物识别到场景交互推理的模型。多格式(JPG、ARW、MOV等)允许用户根据模型需求选择合适的数据类型,例如RAW格式用于高保真生成任务。用户需联系Getty Images数据许可团队以获取完整授权,并根据实际需求定制数据集规模与内容。
背景与挑战
背景概述
在人工智能模型训练领域,高质量、多样化的图像与视频数据是提升模型泛化能力与鲁棒性的关键基石。由Getty Images团队创建的customdataset样本数据集,旨在展示其定制化数据集的构建能力,通过精心设计的场景序列——从单一物体到人物,再到人物与物体的交互——为模型训练提供结构化的视觉素材。该数据集发布于现代深度学习时代,专注于解决多模态数据需求,其核心研究问题在于如何通过专业策划的拍摄与元数据标注,支持对象识别、人物动作理解及人机交互等任务的模型优化。尽管该样本仅包含784个独特资产,但它彰显了Getty Images在数据版权与定制化服务领域的专业积累,为商业级AI训练数据的获取与标准化提供了范例,对推动图像、视频及元数据融合应用的研究具有示范性影响。
当前挑战
该数据集所面临的领域挑战主要体现在两方面:其一,所解决的领域问题聚焦于多模态感知与上下文理解,即模型需从孤立物体识别过渡到人物存在下的动态交互场景,这对跨对象与跨模态的语义对齐提出了高要求,传统单一类别标注难以覆盖此类复杂关联。其二,构建过程中遭遇的挑战包括数据版权与合法使用的严格管控,Getty Images需在保障授权合规的前提下,协调专业导演与摄影师团队,实现规模化拍摄与定制化简报的精准执行;同时,样本集包含RAW、DNG等专业格式,要求数据管理流程支持多种文件类型的高效整合,确保78套、每套8文件的结构化一致性,这对存储、质量控制及元数据关联构成了技术与运营的双重挑战。
常用场景
经典使用场景
该数据集以渐进式叙事结构呈现图像序列,从单一物体到人物,再到人物与物体的交互,为多模态学习和生成式AI模型提供了精细的视觉-文本对齐训练样本。每个样本组包含8个文件,涵盖JPG、ARW、DNG、MOV、MP4等多种格式,并配有描述场景的文本提示,因而特别适用于训练图像生成、视频生成、以及图文匹配模型。研究者可利用此类结构化数据训练能够理解物体、人物及二者交互语义的视觉语言模型,从而提升模型在复杂场景下的生成质量与上下文感知能力。
衍生相关工作
该数据集衍生的相关工作主要集中于两个方向:一是基于渐进式序列的视觉语言模型预训练范式,研究者开始借鉴此类‘物体→人物→交互’的叙事结构设计自监督学习任务,以增强模型对视觉事件演变的建模能力。二是利用高分辨率RAW格式与视频数据的融合训练,推动了多模态数据增强与跨模态生成技术的进步,如从单帧图像恢复出交互视频的生成框架。此外,该数据集展示了专有数据与定制化服务结合的商业模式,催生了对数据版权保护、训练数据溯源等法律与技术交叉领域的研究热潮。
数据集最近研究
最新研究方向
在视觉与多模态人工智能训练的前沿探索中,高质量、可控且差异化显著的数据集成为模型性能突破的关键瓶颈。Getty Images此次发布的定制化样本数据集,通过精心设计的序列化内容架构——从孤立物体到人像,再到人机交互场景——精准映射了当前计算机视觉领域从目标检测向复杂场景理解与动态交互建模的演进趋势。该数据集以专业摄影级的多格式图像与视频资产为支撑,不仅服务于大规模预训练,更通过可定制化的元数据与提示词设计,为少样本学习、级联生成任务及创意AI的应用研究提供了极具行业标准的基准测试平台。其背后强调的数据独家性与定制化服务模式,折射出在版权与数据质量日益受重视的当下,专有、受控的数据源正成为构建具有商业价值与合规性AI模型的核心资产,推动着数据密集型AI研究从泛化走向精细化与垂直化。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

