
1aurent/individuality-of-handwriting
收藏官方服务:
资源简介:
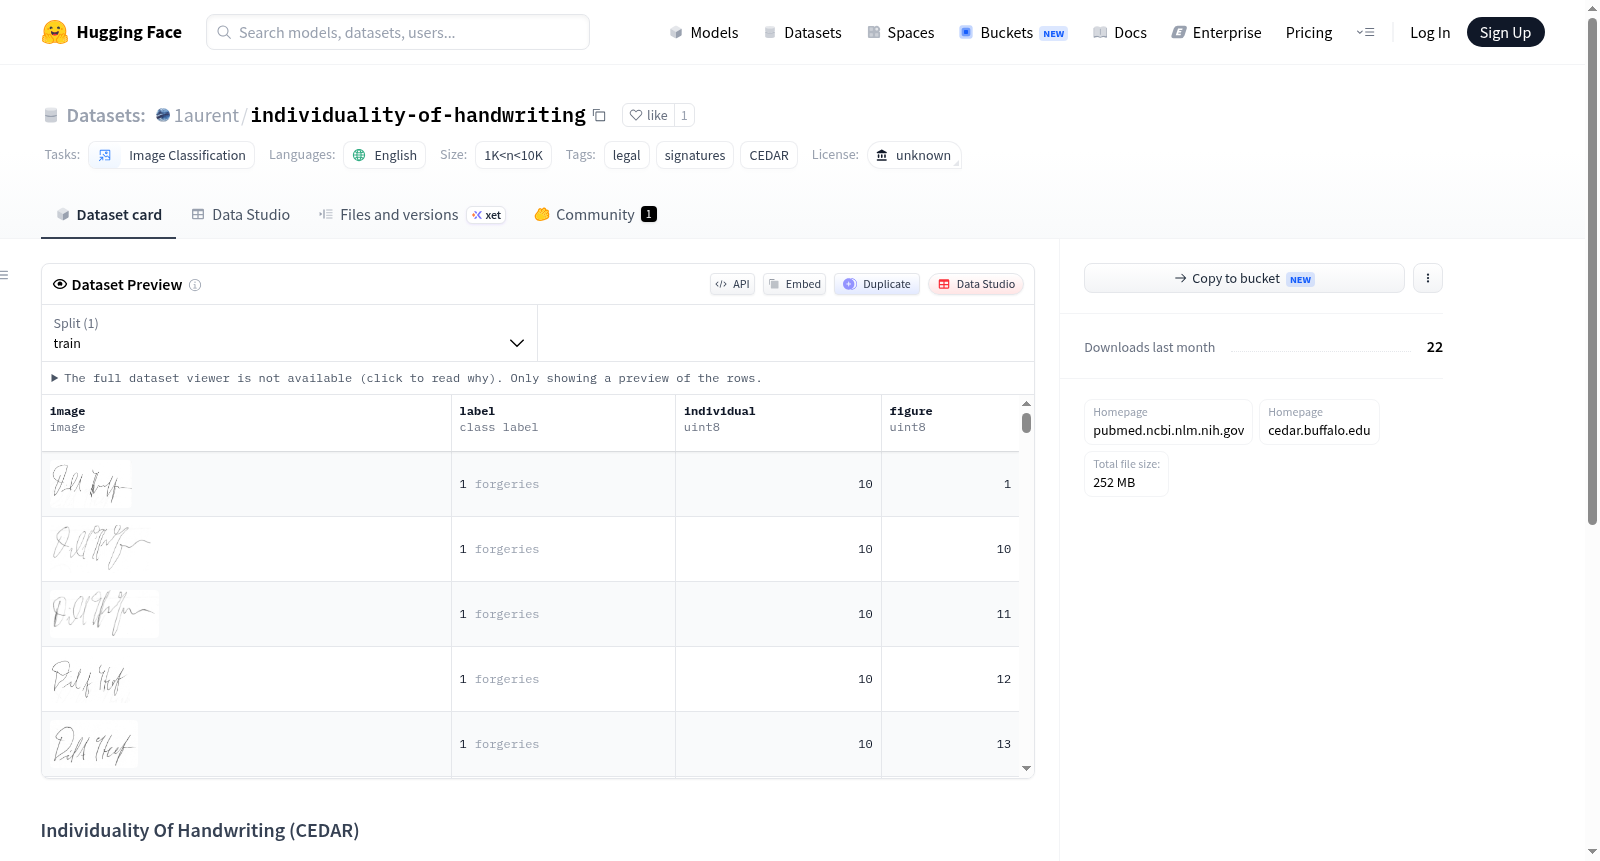
Individuality Of Handwriting (CEDAR)数据集旨在通过计算机算法分析手写样本,验证手写的个体性。数据集包含1500个代表美国人口的手写样本,涵盖了性别、年龄、种族等因素。数据集的特征包括图像、标签(原始或伪造)、个体编号和图形编号。数据集的大小为1K<n<10K,主要用于图像分类任务。
The Handwriting Individuality (CEDAR) Dataset is designed to analyze handwritten samples via computer algorithms to verify the individuality of handwriting. It contains 1,500 handwritten samples representative of the U.S. population, covering demographic attributes including gender, age and ethnicity. The dataset's features include images, labels (genuine or forged), individual IDs and sample IDs. The dataset size falls within the range of 1K < n < 10K, and it is primarily utilized for image classification tasks.
提供机构:
1aurent原始信息汇总
数据集概述
基本信息
- 名称: Individuality Of Handwriting (CEDAR)
- 语言: 英语 (en)
- 许可证: 未知
- 多语言性: 单语
- 大小: 1K<n<10K
- 任务类别: 图像分类
数据集特征
- 图像: 数据类型为图像
- 标签: 数据类型为类别标签,包括 original 和 forgeries
- 个体标识: 数据类型为 uint8
- 图形标识: 数据类型为 uint8
数据集分割
- 训练集:
- 示例数量: 2640
- 数据大小: 195780898.8 字节
- 下载大小: 252337526 字节
创建者
- 注释创建者: 众包
- 语言创建者: 众包
标签
- 法律
- 签名
- CEDAR
配置
- 默认配置:
- 数据文件:
- 分割: 训练
- 路径: data/train-*
- 数据文件:
搜集汇总
数据集介绍
构建方式
该数据集源自一项旨在验证笔迹个体性的科学研究,由美国布法罗大学CEDAR实验室主导构建。研究团队从美国人口中招募了1500名具有代表性的个体,覆盖性别、年龄、种族等多元维度,收集其手写样本。通过计算机算法提取扫描图像中的特征,如行间距、倾斜度、字符形状等,这些特征子集与法庭文件检验专家使用的属性一致。样本被分为原始签名与伪造签名两类,并标注了书写者身份与图形编号,最终形成包含2640个训练样本的图像分类数据集。
特点
数据集的核心特点在于其科学严谨性与司法应用背景。它基于法庭证据可采性的实证需求,通过机器学习方法量化验证笔迹的个体独特性。图像特征提取采用全局属性与少量字符分析相结合的方式,能够以高置信度识别书写者。数据集包含二元标签(原始/伪造)与细粒度的个体标识,支持多层级分类任务。其构建过程严格遵循人口统计学代表性,确保了结论的普适性与可靠性。
使用方法
该数据集适用于图像分类任务,特别是笔迹鉴定与签名验证领域。用户可加载默认配置下的训练集,利用预训练的卷积神经网络或自定义模型对笔迹图像进行特征学习。数据集的标签体系支持二分类(区分原始与伪造签名)及多分类(识别具体书写者)两种范式。建议将图像尺寸标准化为统一分辨率,并采用数据增强技术提升模型泛化能力。评估时可参考原始研究的机器学习方法,如支持向量机或随机森林,以复现其验证结果。
背景与挑战
背景概述
笔迹个体性研究是法庭科学领域的一项核心议题,其旨在验证笔迹作为生物特征用于身份鉴定的科学基础。数据集“Individuality Of Handwriting (CEDAR)”诞生于21世纪初,由纽约州立大学布法罗分校的CEDAR实验室主导,主要研究人员包括Srihari、Cha、Arora和Lee等人。该数据集的核心研究问题在于,面对美国法院对笔迹专家证词科学性的质疑,如何通过定量方法客观证明笔迹的个体独特性。研究团队采集了1500名代表美国人口统计特征的个体笔迹样本,利用计算机算法提取行间距、倾斜度、字符形状等全局属性,并结合机器学习方法实现了高置信度的书写者识别。这一工作不仅为笔迹证据在司法中的采纳提供了科学支撑,还推动了法庭笔迹检验从经验判断向数据驱动范式的转变,对法医学和生物特征识别领域产生了深远影响。
当前挑战
该数据集所解决的领域问题在于笔迹个体性验证的客观化与量化挑战。传统笔迹鉴定依赖专家主观经验,易受争议,而数据集通过提取全局属性与少量字符特征,在有限样本下实现高精度识别,但面临真实场景中笔迹变异性(如书写姿势、情绪影响)的鲁棒性不足。构建过程中,主要挑战包括样本代表性:需平衡性别、年龄、种族等人口统计因素,确保1500份样本能映射美国整体人群特征;特征提取方面,如何从扫描图像中自动分离出与个体性高度相关的属性(如连笔习惯、压力分布),同时排除书写工具、纸张等环境干扰;此外,算法设计需兼顾全局与局部特征融合,避免因字符数量少而导致识别率下降。这些挑战共同制约着数据集在跨场景应用中的泛化能力与司法可接受性。
常用场景
经典使用场景
该数据集广泛用于笔迹个体性验证与笔迹鉴别任务,是笔迹分析领域经典基准之一。研究者通常利用其中包含的原始签名与伪造签名图像,结合图像分类模型,训练判别模型以区分真实笔迹与仿冒笔迹。数据集中的每一样本均标注了书写者身份和笔迹类别,使得模型能够在细粒度上学习个体书写风格的内在差异,成为评估笔迹特征提取与分类算法性能的核心测试平台。
衍生相关工作
围绕该数据集衍生出一系列经典工作,例如基于深度卷积神经网络的笔迹特征自动提取方法,以及结合度量学习的笔迹相似度计算模型。后续研究进一步扩展至多语种笔迹鉴别、小样本学习下的笔迹验证,以及对抗生成网络生成的伪造笔迹检测。这些工作不仅提升了笔迹鉴别的准确率,还推动了笔迹分析在生物特征识别领域的理论发展,形成了从特征工程到端到端学习的完整研究脉络。
数据集最近研究
最新研究方向
在法庭科学领域,笔迹个体性研究正从传统专家经验向机器学习驱动的量化分析范式转变。基于CEDAR数据集构建的1500人代表性样本库,当前前沿方向聚焦于利用深度神经网络提取笔迹微观特征(如笔画曲率、压力分布、字符拓扑结构),以验证个体书写行为的独特性和稳定性。该方向与数字取证中笔迹鉴定的司法可采性议题紧密关联——美国法院对专家证言的Daubert标准要求方法具备可重复性和错误率量化。研究通过计算机视觉算法与支持向量机模型的结合,已实现高置信度的笔迹归属识别,不仅为笔迹证据的科学基础提供了统计学支撑,还推动了自动笔迹验证系统在反欺诈(如签名伪造检测)和刑侦溯源中的实用化进程,其意义在于弥合传统笔迹学主观判断与司法证据客观性要求之间的鸿沟。
以上内容由遇见数据集搜集并总结生成


