
hf-audio/open-asr-leaderboard-multilingual-datasets
收藏官方服务:
资源简介:
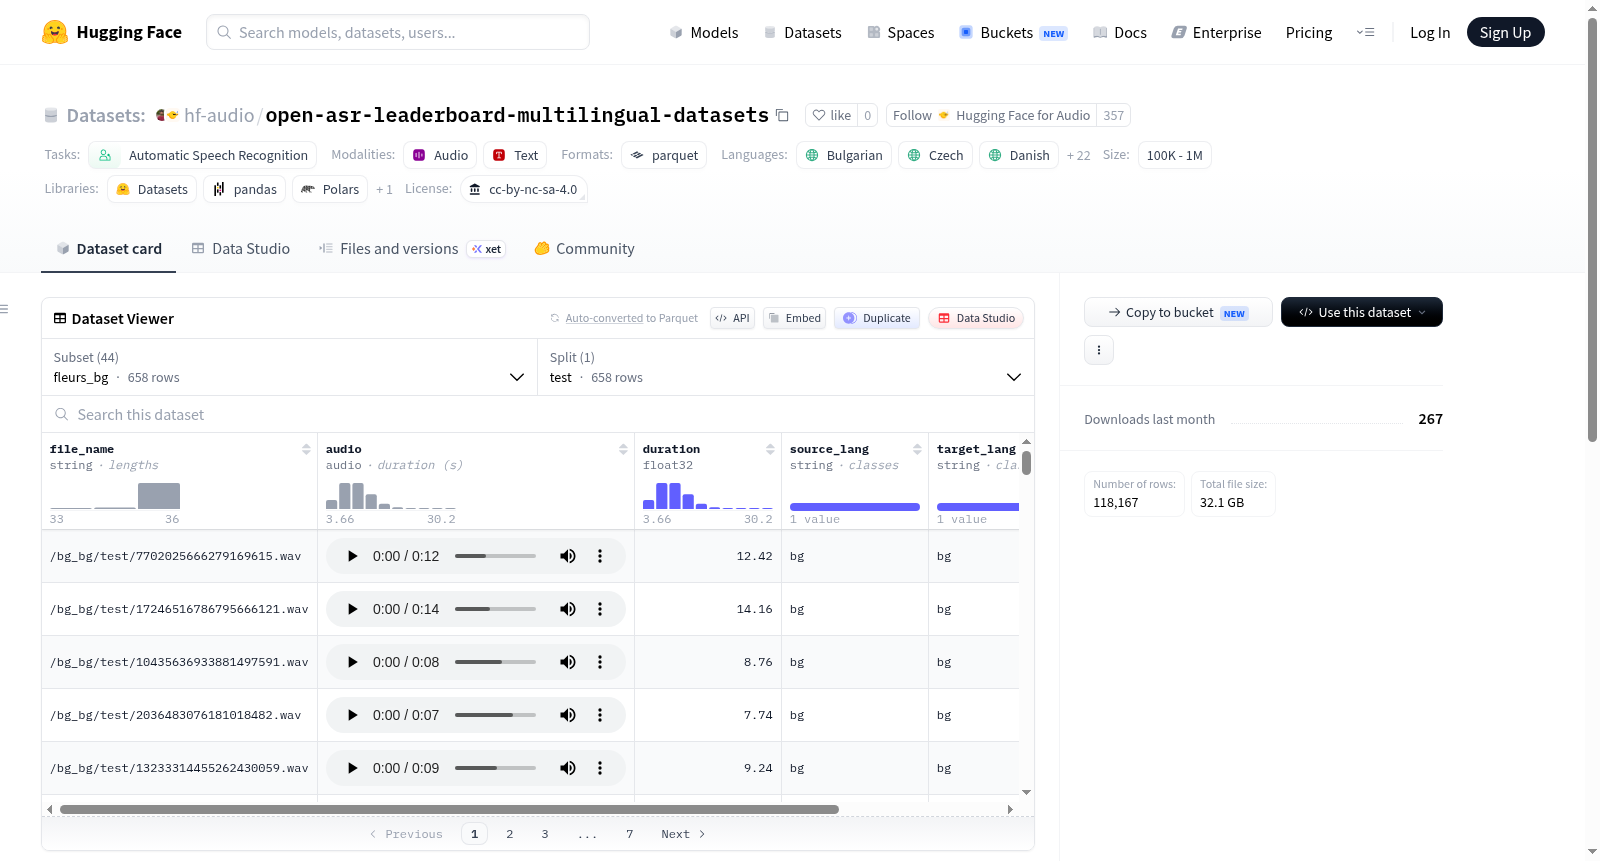
该数据集是一个多语言语音识别测试集集合,包含FLEURS、MCV和MLS三个子数据集,覆盖多种语言(如英语、西班牙语、法语、德语等)。每个子数据集提供测试分割,包含音频文件(采样率16kHz)、对应文本转录、音频时长、源语言和目标语言信息。数据以Parquet格式存储,适用于自动语音识别(ASR)模型的评估和基准测试。
This dataset is a collection of multilingual automatic speech recognition (ASR) test suites that includes three sub-datasets: FLEURS, MCV, and MLS, covering a diverse set of languages such as English, Spanish, French, German and more. Each sub-dataset provides a test split, containing audio files sampled at 16 kHz, corresponding text transcriptions, audio duration information, as well as source and target language details. The data is stored in Parquet format, and is suitable for the evaluation and benchmarking of automatic speech recognition (ASR) models.
提供机构:
hf-audio搜集汇总
数据集介绍
构建方式
该数据集汇集了FLEURS、Common Voice(MCV)与MLS三大开源语音语料库的测试集子集,旨在为多语种自动语音识别(ASR)模型提供标准化评估基准。FLEURS部分涵盖了二十余种语言,每种语言独立配置,音频统一重采样至16kHz,并存储为Parquet格式文件。MCV与MLS语料则以类似方式组织,分别贡献了从数百到上万条不等的语音-文本对,共同构建了一个横跨欧洲及部分非欧洲语言的高质量评估集合。数据集构建严格遵循各原始语料库的许可协议,确保了学术研究与商业应用的合法性。
特点
该数据集最显著的特征在于其多层次、多来源的复合结构,融合了来自FLEURS的均衡语料、MCV的大规模众包数据以及MLS的经过专业处理的播客语料。每个样本均包含文件名、以16kHz采样的音频张量、语音时长、源语言与目标语言标识以及对应的文本转写。所有配置均提供统一的字段定义,便于下游任务的无缝加载。此外,数据集仅为每个子集提供测试分割,专注于模型评估而非训练,从而保证了评测条件的一致性与可重复性。
使用方法
使用该数据集时,研究人员可通过Hugging Face Datasets库按配置名称(如'fleurs_en'或'mcv_de')加载对应的子集。加载后,每个样本将包含音频数组、采样率及文本标签,可直接用于评估ASR模型的词错误率(WER)或字符错误率(CER)。由于数据集仅包含测试划分,推荐的做法是结合模型在相同条件下的推理管线进行评测。对于多语言场景,用户可以循环遍历所有配置或使用通配符批量加载,从而系统性地衡量模型在目标语言组合上的表现。
背景与挑战
背景概述
open-asr-leaderboard-multilingual-datasets是一个由Open ASR排行榜项目维护的多语言语音识别评估数据集集合,整合了FLEURS、Common Voice (MCV)和Multilingual LibriSpeech (MLS)等多个知名语料库的测试集。该数据集创建于2023年,旨在为自动语音识别(ASR)模型提供跨语言、标准化的性能基准。其核心研究问题聚焦于评估现代ASR系统在低资源和高资源语言上的泛化能力,覆盖从保加利亚语到乌克兰语的20余种语言。作为Open ASR排行榜的底层数据支撑,该数据集对推进多语言语音识别研究具有重要影响力,为模型比较提供了统一的测试平台。
当前挑战
该数据集所解决的领域问题核心在于多语言ASR评估的不均衡性:现有基准多集中于英语等资源丰富的语言,导致模型在低资源语言上的表现退化。语种间存在显著的发音差异、音系多样性以及声学环境异质性,传统单一语言评测体系难以反映真实部署中的跨语言鲁棒性。在构建过程中,面临的挑战包括:从不同源头聚合音频和标注时存在格式与采样率不一致问题;需统一转写规范以处理多语言文本中的特殊字符和拼写变体;以及确保各语种测试集样本量相对平衡,避免因数据分布极度不均而引入评估偏差。
常用场景
经典使用场景
open-asr-leaderboard-multilingual-datasets是一个专为多语言自动语音识别(ASR)模型评估而设计的综合性测试数据集,汇聚了FLEURS、Common Voice(MCV)和Multilingual LibriSpeech(MLS)三大经典语料库的测试子集。在语音技术研究领域,该数据集最经典的用途是作为多语言ASR系统的标准化评测基准,研究者可利用其覆盖的数十种语言(如德语、法语、西班牙语、俄语等)的音频-文本对,在统一框架下横向对比不同模型的词错误率(WER)表现。数据集中每个样本均包含以16kHz采样率重采样的音频文件及对应转录文本,确保了评测的严谨性与可复现性。
衍生相关工作
围绕该数据集衍生出诸多里程碑式的工作,例如基于其评测框架诞生的Open ASR Leaderboard已成为学术界与工业界公认的多语言语音识别竞技舞台。研究者利用FLEURS子集中的保加利亚语、克罗地亚语等低资源数据,推动了如Whisper、HuBERT、XLS-R等大规模多语言预训练模型的迭代升级。Common Voice和MLS子集则催生了面向口语混杂场景的噪声鲁棒性研究,以及针对荷兰语、瑞典语等小语种的高效微调策略论文。这些衍化工作共同勾勒出从通用基线迈向语言自适应、领域自适应的技术演进脉络,持续深化着人们对语音信号中语言普遍性与特殊性的认知边界。
数据集最近研究
最新研究方向
作为Open ASR Leaderboard评测体系的核心多语言基准,该数据集整合了FLEURS、Common Voice、MLS三大主流语料库,覆盖24种欧洲语言,为多语种端到端语音识别系统提供了标准化评测平台。当前研究前沿聚焦于两大方向:其一,基于自监督预训练模型(如wav2vec 2.0、HuBERT)的低资源语言适配,利用该数据集丰富的标注音频探索跨语言知识迁移与微调策略;其二,多语种联合识别中语言混淆问题的缓解,通过引入语言特定适配层或语言无关的声学表征来提升泛化能力。该数据集正推动着多语种ASR从单一模型覆盖多个语种向零样本跨语言迁移的方向演进,其规范化的评测体系已成为衡量模型真实泛化性能的重要标尺。
以上内容由遇见数据集搜集并总结生成


