
遇见数据集

WZDavid/MemoryCD

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

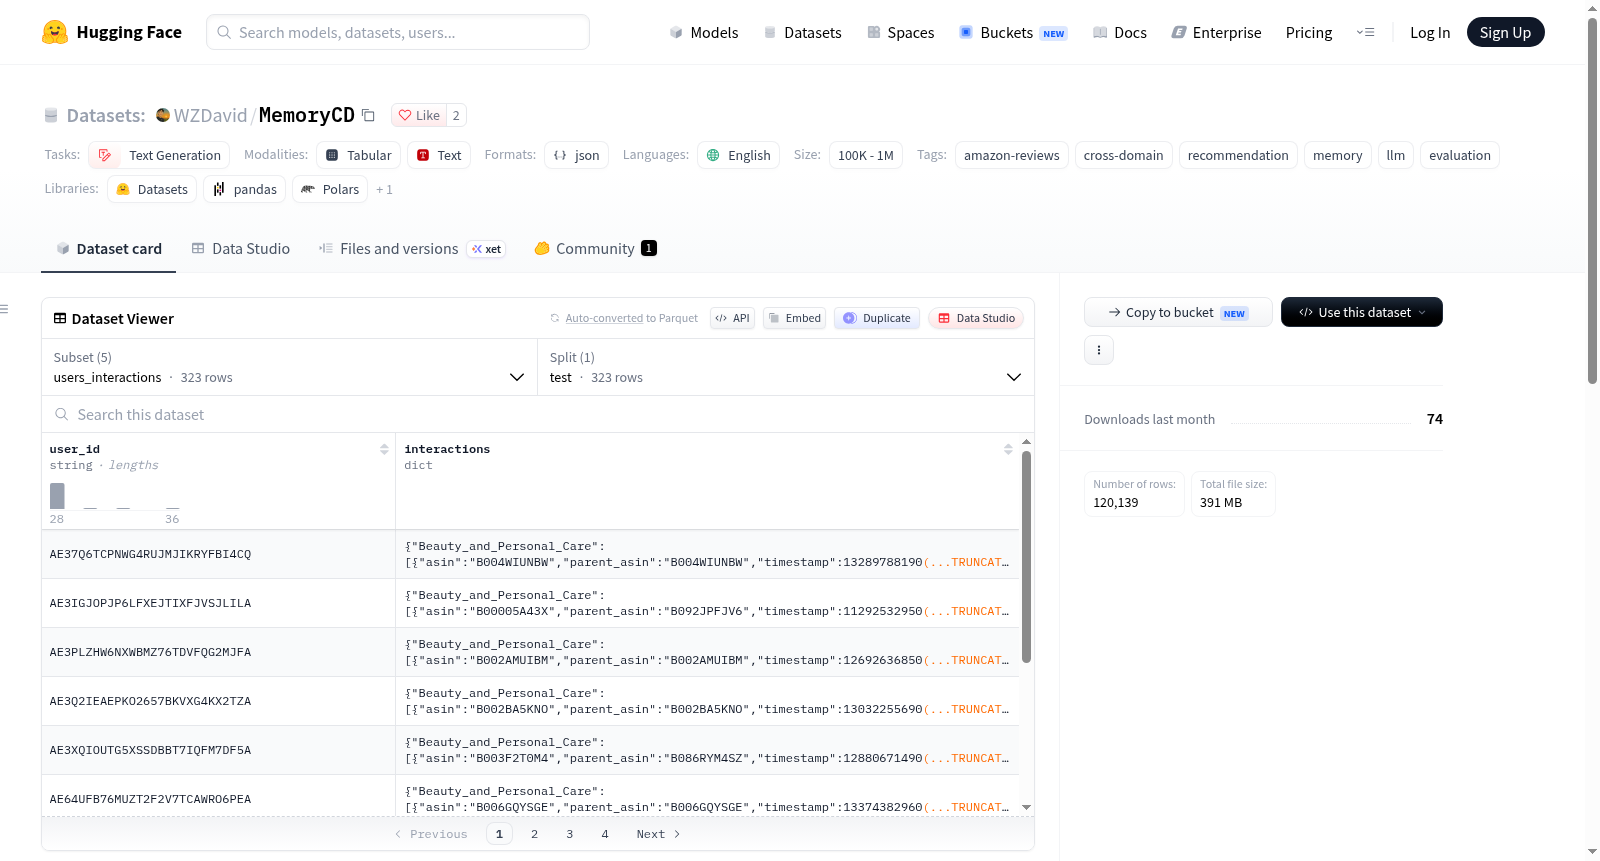
MemoryCD是一个基于Amazon Reviews 2023的过滤跨域子集,专为内存增强大型语言模型(LLM)评估设计。该数据集包含多个配置:users_interactions包括323个用户的交互记录,而meta_personal_care、meta_books、meta_electronics和meta_home分别包含33,475、48,054、25,441和60,900个项目,这些项目覆盖了所有用户引用的167,870个唯一parent_asin,确保100%覆盖率。所有配置仅提供测试拆分,用于评估目的,且价格字段已统一标准化为浮点型或空值。

MemoryCD is a filtered cross-domain subset of Amazon Reviews 2023 for memory-augmented LLM evaluation. It includes multiple configs: users_interactions with 323 user interactions, and meta_personal_care, meta_books, meta_electronics, and meta_home containing 33,475, 48,054, 25,441, and 60,900 items respectively, covering 167,870 unique parent_asin referenced by all users with 100% coverage. All configs expose a single test split for evaluation only, and the price field is normalized to float or null across all meta files.

提供机构:
WZDavid
搜集汇总
数据集介绍
WZDavid/MemoryCD 数据集图片
构建方式
MemoryCD脱胎于Amazon Reviews 2023这一大规模电商评论语料,旨在为记忆增强型大语言模型构建跨域评测基准。其构建以用户交互记录为锚点,首先从原始数据中筛选出323名具有跨域行为的用户,继而精确回溯这些用户所涉及的全部商品,覆盖美妆个护、图书、电子、家居厨房四个品类,形成四个元数据配置文件,共包含167870个唯一商品标识,实现用户引用商品的全量覆盖。构建过程中对价格字段进行统一归一化处理,转换为浮点型或空值,以保障跨域数据的一致性与可用性。
特点
该数据集以跨域推荐与记忆机制评测为核心定位,呈现出若干鲜明特征。数据仅提供测试划分,专用于评估场景,避免训练集泄露带来的偏差。四个元数据文件与用户交互记录严格对应,商品覆盖率百分之百,确保评测的完整性与可追溯性。品类跨越美妆个护、图书、电子与家居厨房,域间差异显著,有利于检验模型在异构偏好迁移中的记忆保持与泛化能力。价格字段的规范化处理进一步提升了跨域比较的公平性,使数据在结构上兼具广度与精度。
使用方法
研究者和开发者可通过Hugging Face数据集库便捷加载MemoryCD,分别指定users_interactions及所需meta配置并选取test划分即可获取相应数据。典型用法是加载用户交互记录与一个或多个品类元数据,将用户历史行为作为记忆上下文输入大语言模型,在跨域商品推荐或偏好推理任务中评估模型的记忆增强效果。由于所有配置仅含测试集,该数据适合直接用于零样本或记忆注入式的推理评测,亦可作为基准与现有推荐系统或大语言模型进行对比,以衡量跨域记忆能力的优劣。
背景与挑战
背景概述
随着大语言模型在推荐系统领域的深入应用,如何有效评估其记忆增强能力成为亟待探索的前沿课题。MemoryCD数据集于2025年前后由研究者构建,衍生自McAuley-Lab发布的Amazon Reviews 2023大规模评论语料,旨在为记忆增强型大语言模型提供跨域评估基准。该数据集聚焦于跨域推荐场景,通过筛选323名具有跨域行为特征的活跃用户及其关联的167870件商品,覆盖美妆个护、图书、电子产品和家居厨房四个品类,构建了一个真实且精细的评测环境。其核心研究问题在于检验大语言模型在跨域推荐中利用用户历史交互记忆进行知识迁移与偏好推断的能力。作为专门面向记忆增强评估的资源,MemoryCD为推荐系统与大语言模型交叉研究提供了标准化的测试平台,推动了跨域场景下模型记忆机制的可复现研究。
当前挑战
跨域推荐本身面临用户行为稀疏、领域间语义鸿沟与偏好迁移不确定等固有难题,MemoryCD所服务的记忆增强大语言模型评估更需应对模型能否准确调用跨域历史记忆并泛化至目标域的挑战。在构建过程中,如何从海量Amazon评论数据中精准识别具有跨域行为的用户并确保其交互记录的完整性构成首要难点,同时需解决不同品类元数据字段异构、商品标识映射复杂以及价格等属性规范化等问题。数据集的评测场景要求模型在单次推理中融合多域记忆信息,对上下文长度、记忆检索效率与领域适应性均提出严苛要求。此外,仅提供测试集的设计虽简化了评测流程,但也意味着模型性能高度依赖预训练阶段的知识获取与记忆机制的泛化能力,如何避免领域偏移与过拟合成为实际应用中的关键挑战。
常用场景
经典使用场景
在个性化推荐系统的学术探索中,MemoryCD数据集最为经典的使用场景是评估记忆增强型大语言模型在跨域情境下的推荐效能。研究者通常将323名用户的跨域交互序列作为查询语境,结合四个商品元数据域(美妆个护、图书、电子、家居厨房)构建动态记忆库,要求模型在生成推荐时准确调用用户在不同领域的偏好历史。该数据集通过提供100%覆盖的商品元数据,支持模型在生成推荐理由或排序结果时检索到完整的物品属性,从而检验记忆机制在跨越品类边界时的保持与泛化能力。
实际应用
在工业级推荐场景中,MemoryCD能够服务于跨品类电商平台的记忆增强推荐模块。例如,当用户于图书品类表现出对历史传记的偏好后,系统可借助该数据集的评测框架验证模型能否将这一偏好泛化至电子品类的传记纪录片或家居品类的历史主题装饰品推荐中。323名用户的交互序列与167,870个商品元数据的紧密耦合,使得从业者可以模拟真实场景下的冷启动与跨域迁移,评估基于大语言模型的记忆系统在响应时间、存储开销与推荐准确性之间的权衡,从而指导线上系统的架构选型。
衍生相关工作
MemoryCD的发布激发了若干围绕跨域记忆增强推荐的研究工作。部分学者以此为基础,探索将用户交互历史压缩为可检索的外部记忆向量,并对比不同索引结构对推荐性能的影响;亦有工作将其用作大语言模型检索增强生成范式的评测集,分析商品元数据中的价格、类别等字段在生成式推荐中的贡献度。该数据集还间接推动了跨域用户建模的公平性研究,例如检验记忆机制是否对活跃度较低的用户产生系统性偏差。这些衍生工作共同丰富了记忆增强大语言模型在推荐领域的理论与实证版图。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

