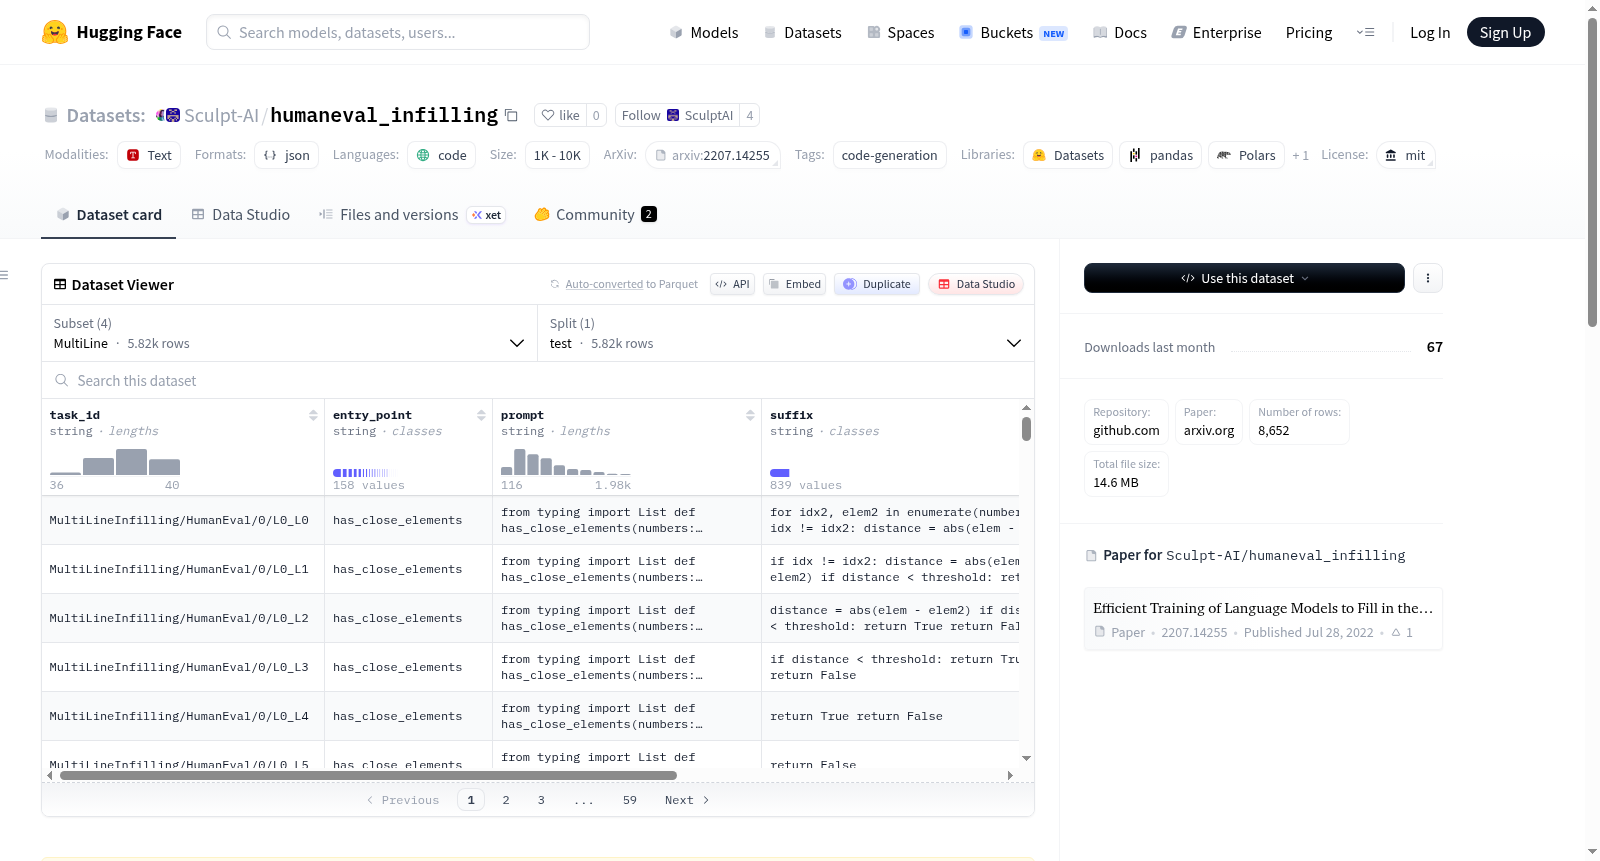
humaneval_infilling
收藏资源简介:
HumanEval-Infilling 是一个用于代码填充任务的基准数据集,源自用于评估代码生成模型的 HumanEval 基准。该数据集包含四个子集:HumanEval-MultiLineInfilling、HumanEval-SingleLineInfilling、HumanEval-RandomSpanInfilling 和 HumanEval-RandomSpanInfillingLight,分别包含 5815、1033、1640 和 164 个任务。每个数据条目包含以下特征:task_id、entry_point、prompt、suffix、canonical_solution 和 test。该数据集适用于文本到文本生成任务,特别是代码生成领域的研究和评估。
HumanEval-Infilling 是一款面向代码填充任务的基准数据集,其源自用于评估代码生成模型的HumanEval基准(HumanEval benchmark)。该数据集包含四个子集,分别为HumanEval-MultiLineInfilling、HumanEval-SingleLineInfilling、HumanEval-RandomSpanInfilling 与 HumanEval-RandomSpanInfillingLight,各子集包含的任务数量依次为5815、1033、1640及164个。每条数据条目均包含以下特征字段:task_id、entry_point、prompt、suffix、canonical_solution 及 test。本数据集适用于文本到文本生成(text-to-text generation)任务,尤其可用于代码生成领域的相关研究与模型评估工作。
OpenAI HumanEval-Infilling 数据集概述
数据集基本信息
- 数据集名称: OpenAI HumanEval-Infilling
- 创建者: 专家生成
- 语言: 代码
- 许可协议: MIT
- 多语言性: 单语言
- 任务类别: 文本到文本生成
- 标签: 代码生成
数据集来源
- 源数据集: 原始创建
- 相关仓库: https://github.com/openai/human-eval-infilling
- 相关论文: https://arxiv.org/pdf/2207.14255
数据集简介
HumanEval-Infilling 是一个用于填充任务的基准测试数据集,源自用于评估代码生成模型的 HumanEval 基准测试。
数据集结构
数据集包含四个子集,加载时需要指定子集名称。默认加载的子集是 HumanEval-SingleLineInfilling。
数据特征
每个子集包含以下特征字段:
task_identry_pointpromptsuffixcanonical_solutiontest
子集详情
-
HumanEval-MultiLineInfilling
- 数据文件路径:MultiLine/test.jsonl
- 任务数量:5,815
-
HumanEval-SingleLineInfilling
- 数据文件路径:SingleLine/test.jsonl
- 任务数量:1,033
-
HumanEval-RandomSpanInfilling
- 数据文件路径:RandomSpan/test.jsonl
- 任务数量:1,640
-
HumanEval-RandomSpanInfillingLight
- 数据文件路径:RandomSpanLight/test.jsonl
- 任务数量:164
使用示例
python from datasets import load_dataset ds = load_dataset("humaneval_infilling", "HumanEval-RandomSpanInfilling")
引用信息
@article{bavarian2022efficient, title={Efficient Training of Language Models to Fill in the Middle}, author={Bavarian, Mohammad and Jun, Heewoo and Tezak, Nikolas and Schulman, John and McLeavey, Christine and Tworek, Jerry and Chen, Mark}, journal={arXiv preprint arXiv:2207.14255}, year={2022} }