
遇见数据集

insilicomedicine/URSA-benchmarking-sets

收藏
Hugging Face2026-05-28 更新2026-06-14 收录
官方服务:

资源简介:

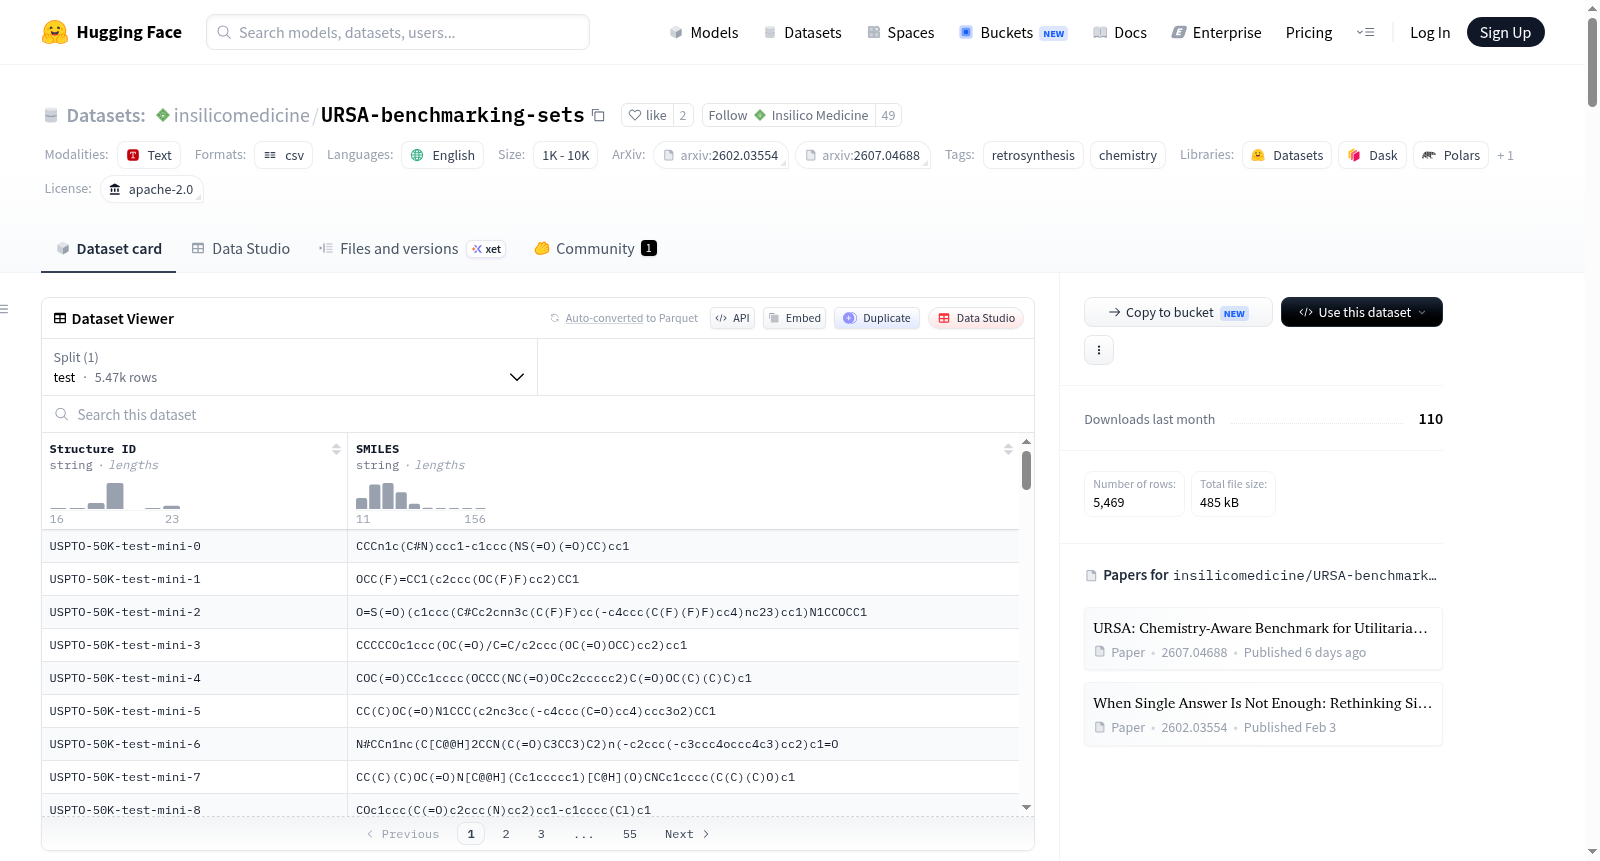
URSA基准测试集是一个用于单步逆合成(retrosynthesis)的基准数据集,来自Zagribelnyy等人(2026年)的研究。该数据集包含三个CSV文件:URSA-expert-2026.csv(包含100个专家精选的具有挑战性的药物化学目标分子,具有高复杂性、多样化的化学类型和典型的药物分子立体化学)、USPTO-50K-test.csv(从USPTO-50K测试集中精选的4,972个产品分子,经过筛选去除了可能影响基准语义的条目)和USPTO-50K-test-mini.csv(USPTO-50K-test的10%固定随机子样本,包含497个目标,用于快速迭代和低成本评估)。每个文件提供产品分子的SMILES表示(在适用时保留立体化学),旨在用于评估逆合成模型的性能。数据集基于Apache License 2.0许可发布,部分数据源自USPTO-50K测试集。

The URSA benchmark dataset is a standardized resource for evaluating single-step retrosynthesis, originating from the 2026 study by Zagribelnyy et al. This dataset comprises three CSV files: URSA-expert-2026.csv, which contains 100 expert-curated challenging pharmaceutically relevant target molecules with high complexity, diverse chemical scaffolds, and typical stereochemistry of drug-like molecules; USPTO-50K-test.csv, which includes 4,972 product molecules selected from the USPTO-50K test set, with entries that may compromise the semantic validity of the benchmark filtered out; and USPTO-50K-test-mini.csv, a fixed 10% random subsample of the USPTO-50K-test set containing 497 target molecules for rapid iteration and low-cost evaluation. Each file provides the SMILES representations of the product molecules, with stereochemistry preserved where applicable, and is intended for evaluating the performance of retrosynthesis models. This dataset is released under the Apache License 2.0, and part of its data is derived from the USPTO-50K test set.
提供机构:
insilicomedicine
搜集汇总
数据集介绍
insilicomedicine/URSA-benchmarking-sets 数据集图片
构建方式
URSA-benchmarking-sets数据集由Zagribelnyy等人于2026年构建,旨在为逆合成分析与反应合理性评估提供标准化基准。该数据集整合了两大任务家族:反应层次的可信度判断与逆合成目标集合。其中,反应可信度基准包含1000条由不同模型预测并经有机化学专家手工标注的反应,均衡分为500条合理与500条不合理。逆合成目标集合则涵盖多个子集:专家精选的100个高难度药物化学靶标、100个获批药物与临床候选分子靶标,以及来自USPTO-50K标准测试集的4972条精炼产物(经剔除32个伪影条目后获得),并额外提供其10%随机子采样版本以支持快速迭代。
特点
该数据集的核心特色在于其多层次、多视角的评估体系。反应可信度部分提供了专家二值标签与ChemCensor连续评分,可同时支持分类器训练与模型鲁棒性检验。逆合成目标集合则强调药物化学相关性,通过专家靶标与药物级分子覆盖真实应用场景,数据多样性高达0.85886。此外,USPTO-50K子集经过系统化清洗,排除了小分子产物与角色分配错误等伪影,确保基准语义纯净。所有数据均以标准化SMILES格式存储,保留立体化学信息,便于下游模型直接使用。
使用方法
使用该数据集极为便捷,用户可直接通过Hugging Face的datasets库按需加载具体CSV文件,例如`load_dataset('insilicomedicine/URSA-benchmarking-sets', data_files='URSA-reaction-plausibility-bench-2026.csv')`。对于逆合成任务,可加载`URSA-expert-2026.csv`、`USPTO-50K-test.csv`等文件进行单步或多步前驱预测。建议研究者根据实际需求选择子集:大型模型可使用完整USPTO-50K测试集进行标准评估,而快速原型开发可选用mini版本。在引用时,需同时标注文献与数据清洗细节以增强复现性。
背景与挑战
背景概述
逆合成分析是计算机辅助药物设计中的核心任务,旨在通过将目标分子逐步拆解为简单易得的起始原料,为有机合成路径规划提供关键支撑。近年来,随着深度学习技术的迅猛发展,基于神经网络的单步与多步逆合成预测模型层出不穷,然而,评估这些模型性能的基准数据集却长期存在构建标准不一、化学合理性缺失等问题。在此背景下,由InSilico Medicine研究团队的Bogdan Zagribelnyy等人于2026年共同创建的URSA-benchmarking-sets数据集应运而生。该数据集融合了反应级可信度判断与逆合成目标两大任务族,精心构建了包含专家标注的反应合理性基准、药物相关性目标分子集以及经严格清洗的USPTO-50K测试子集。凭借其精细的化学语义甄别与显著的实用导向,该基准迅速成为衡量逆合成模型在学术研究与现实应用场景中表现的重要标尺,有力推动了该领域评估体系的规范化与科学化。
当前挑战
该数据集所应对的核心领域挑战在于,现有逆合成模型评估基准普遍混杂了因数据处理错误而导致的语义噪声,例如将试剂或溶剂误标为产物、筛选极小分子量目标等,严重干扰了模型性能的真实度量。为克服这一障碍,数据集的构建过程要求对原始USPTO-50K测试集中5004个样本逐一核查,精心剔除了32个由角色分配错误、处理伪影和产物分子量小于100 Da引入的劣质条目。同时,如何从零构建一个能真实反映复杂药物化学场景的高质量专家基准,亦是巨大挑战,需有机化学专家对100个具有高复杂性、多样化化学类型与立体化学特征的靶标分子进行逐一手动审视与筛选。此外,还需平衡反应级合理性标注的主观性偏差,确保500个正负样本的专家标签与自动化评分工具在化学语义上达到高度一致,从而产出兼具信度与效度的基准数据。
常用场景
经典使用场景
URSA-benchmarking-sets数据集是化学信息学与逆合成分析领域的一项核心基准资源,广泛应用于反应合理性判别与逆合成路径规划两大经典任务。其反应合理性子集包含由有机化学专家手工标注的1000条反应(500条合理、500条不合理),用于评估模型对化学反应可行性的判断能力。在逆合成目标方面,该数据集整合了专家精心挑选的100个具有挑战性的药物化学靶点、100个已获批药物与临床候选分子,以及经过严格数据清理的USPTO-50K测试集(含4972条记录)及其约10%的快速迭代子集。这些资源构成了从单步逆合成到多步路线预测的标准化测试平台,使得研究者能够在统一、高质的基准上公平比较不同算法性能。
解决学术问题
该数据集直面逆合成评估中的两个根本性学术难题:其一,如何客观衡量反应合理性与逆合成模型的实际效用。传统数据集常包含溶剂错误标注为产物等伪影,导致评估失真;URSA通过专家人工清洗移除32条有问题的记录并去除低分子量靶点,显著降低了评估噪声。其二,现有基准多缺乏对药物化学相关复杂骨架和立体化学的覆盖,URSA-expert-2026和URSA-drugs-clinicals-2026专门针对这一空白,提供了结构多样度高(0.85886)、与真实药物开发场景紧密关联的测试目标,推动了逆合成模型从学术性指标向实用化药化评价的范式转变。该数据集的意义在于为整个社区建立了更可信、更贴近工业需求的评估标尺,从而引导研究方向向解决真实化学合成挑战倾斜。
衍生相关工作
基于URSA-benchmarking-sets,学界已涌现多项重要衍生工作。最直接的是伴随该数据集发布的ChemCensor反应合理性评分模型,它利用该基准进行训练与验证,能够输出0至5分制的合理性分数,为自动合成设计提供关键过滤信号。另一核心工作是URSA(Utilitarian Retrosynthesis Assessment)框架,该框架以本数据集为评估基础,系统性地重新思考了单步逆合成基准中单一答案假设的局限性,推动了多答案评估与提示工程技术的发展。此外,USPTO-50K清理版广泛被后续模型引用作为标准测试集,例如各类基于Transformer和图神经网络的逆合成模型均将其作为评估自身性能的对比基准。该数据集的专家与临床分子子集更启发了针对特定治疗领域逆合成难度的子课题研究,如天然产物类似物合成预测等。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

