
pli-masking-100k
收藏官方服务:
资源简介:
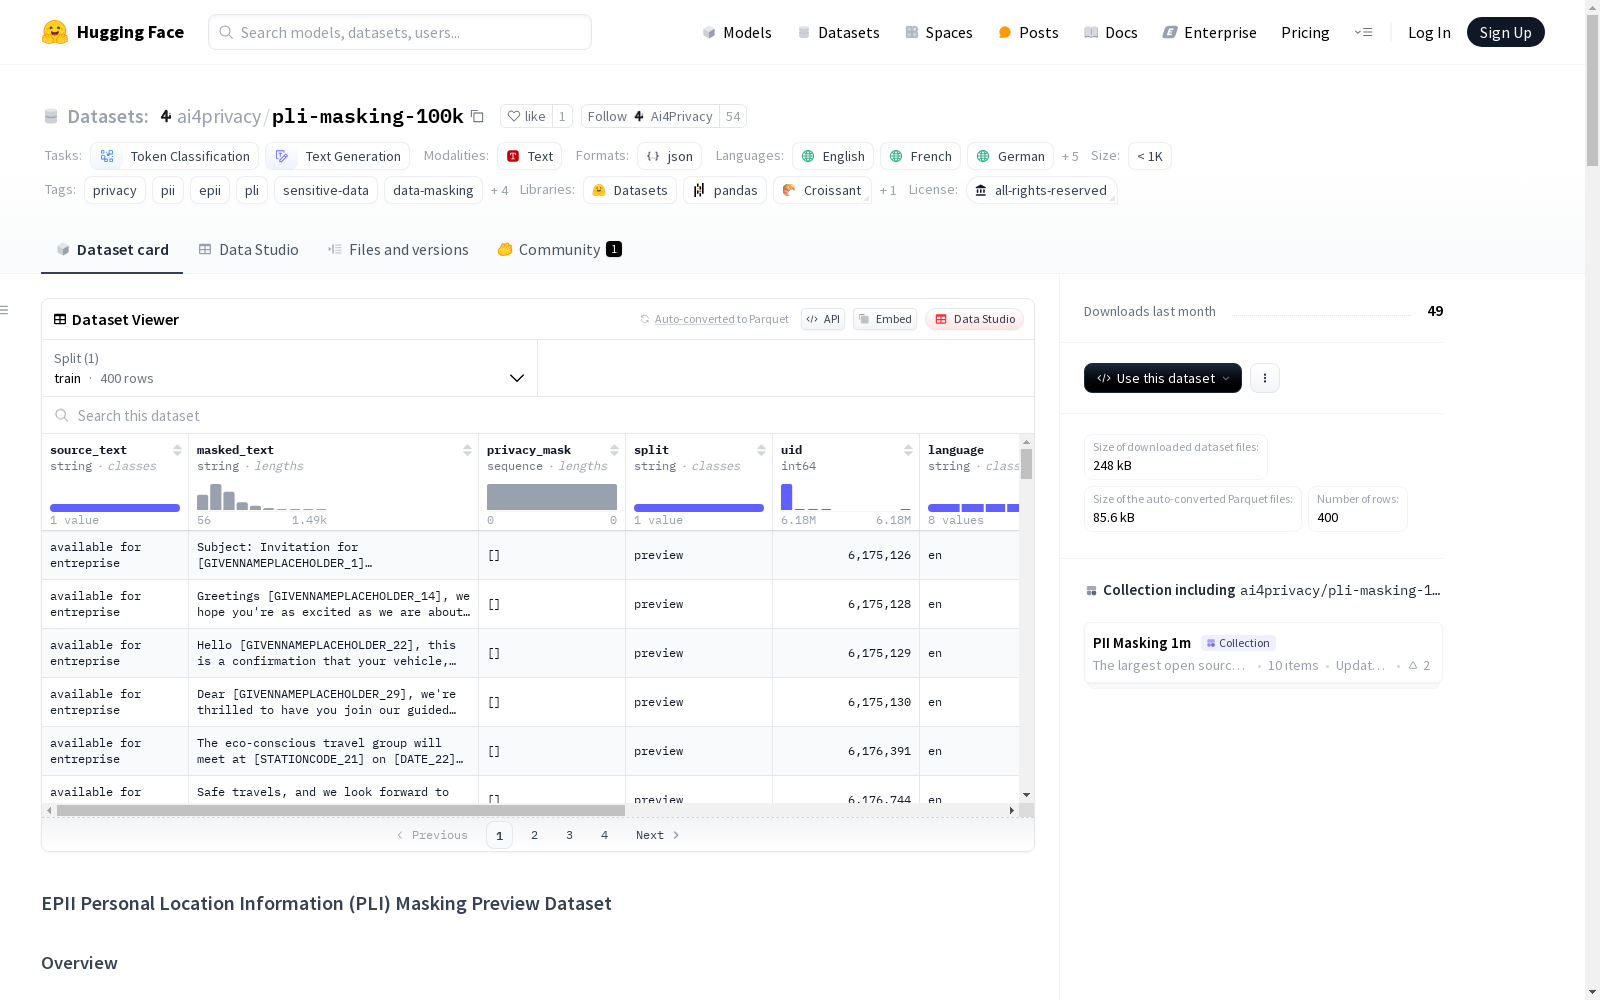
EPII个人位置信息(PLI)遮掩100k预览数据集是一个专为识别和遮掩文本数据中敏感的个人位置信息而设计的专业数据集。预览版包含400个样本,展示了数据结构、标签分类和质量,代表了完整商业数据集的100,000+条目。该数据集支持8种语言,适用于企业级应用,需要遵守如GDPR、CCPA、HIPAA等数据保护法规。
The EPII Personal Location Information (PLI) Redaction 100k Preview Dataset is a specialized dataset developed specifically to identify and redact sensitive personal location information in textual data. The preview version contains 400 samples, which showcase the data structure, label taxonomy and data quality, and represent the over 100,000 entries of the full commercial dataset. This dataset supports 8 languages, is applicable for enterprise-level applications, and requires compliance with data protection regulations such as GDPR, CCPA and HIPAA.
创建时间:
2025-04-22
搜集汇总
数据集介绍
构建方式
EPII Personal Location Information (PLI) Masking 100k数据集作为企业级隐私保护解决方案的组成部分,其构建过程严格遵循数据匿名化与合规性要求。该数据集从原始文本中系统性地提取了16类特定于个人位置信息的敏感标签,涵盖机场代码、地理坐标、IP地址等多种类型。采用多语言支持架构,核心语种(英、法、德等6种)已完成标准化处理,印地语和泰卢固语作为实验性语种纳入。数据以JSON Lines格式存储,每条记录包含原始文本、脱敏文本及元数据字段,完整版商业数据集则进一步提供详细的隐私掩码标注和分词标签。
使用方法
该预览数据集主要适用于技术评估场景,用户可通过解析jsonl文件获取掩码文本示例和基础元数据,用于了解数据结构和标签体系。完整商业版本则支持更复杂的应用流程:企业可将原始文本输入经该数据集训练的模型,自动识别并替换PLI标签所对应的敏感信息,生成符合隐私法规的脱敏文本。典型应用场景包括医疗记录去标识化、金融交易日志匿名处理等垂直领域,使用时需注意预览版不含原始文本和完整标注,实际部署需通过官方渠道获取商业授权,并严格遵循数据主权管辖地的合规要求。
背景与挑战
背景概述
EPII Personal Location Information (PLI) Masking 100k Preview Dataset由Ai4Privacy团队开发,旨在解决文本数据中敏感个人位置信息的识别与掩码问题。该数据集专为企业级应用设计,支持包括英语、法语、德语等在内的8种语言,尤其关注GDPR、CCPA等数据保护法规的合规需求。数据集的核心研究问题在于如何高效准确地识别和掩码文本中的个人位置信息,从而为隐私保护AI技术提供可靠的数据支持。其影响力主要体现在提升企业数据处理合规性、增强AI模型隐私保护能力等方面。
当前挑战
该数据集面临的挑战主要包括两个方面:领域问题的挑战和构建过程的挑战。在领域问题方面,如何准确识别多语言环境下的个人位置信息,尤其是实验性语言如印地语和泰卢固语,是一个显著的技术难点。此外,不同国家和地区对个人信息的定义和保护要求各异,数据集需要兼顾这些差异性以确保合规性。在构建过程中,数据标注的精确性和一致性是关键挑战,尤其是在处理复杂的地理坐标、时间信息等结构化数据时。同时,如何在保护隐私的前提下提供足够的数据多样性以支持模型训练,也是数据集构建中需要平衡的重要问题。
常用场景
经典使用场景
在隐私保护与合规性需求日益增长的背景下,EPII PLI Masking数据集为多语言文本中的个人位置信息识别与脱敏提供了标准化解决方案。该数据集特别适用于训练命名实体识别模型,通过标注16类敏感位置信息(如机场代码、地理坐标、IP地址等),帮助模型精准识别文本中的隐私数据片段。其跨语言特性(支持英、法、德等8种语言)使其成为全球化企业处理多语言客户数据时的基准工具。
解决学术问题
该数据集有效解决了隐私计算领域的关键挑战:如何在保持语义连贯性的前提下实现细粒度位置信息脱敏。通过提供标准化的标注体系,研究者可系统评估不同模型在识别地理坐标、车辆识别码等复杂PLI时的性能差异。其多语言标注数据尤其缓解了小语种隐私保护研究中数据匮乏的困境,为构建跨语言泛化的隐私保护模型提供了重要基线。
实际应用
在医疗健康领域,该数据集支持电子病历中地理位置信息的自动化脱敏,满足HIPAA合规要求;金融行业利用其处理客户交易记录中的IP地址和时区信息,符合PCI-DSS规范。物流企业则通过识别货运单据中的机场代码和车辆识别码,实现供应链数据的匿名化共享。这些应用显著降低了企业因数据泄露面临的合规风险。
数据集最近研究
最新研究方向
随着全球数据隐私法规的日益严格,个人位置信息(PLI)的保护成为隐私计算领域的前沿课题。EPII PLI Masking数据集针对多语言环境下的敏感位置信息识别与脱敏,为金融、医疗等高度监管行业提供了合规解决方案。当前研究聚焦于跨语言PLI检测模型的迁移学习能力优化,特别是在低资源语言如印地语和泰卢固语的实验性支持方面取得进展。该数据集通过16类精细标注体系,为地理坐标、交通站点代码等特殊PLI类型的识别提供了新的基准测试平台。在生成式AI快速发展的背景下,如何防止大语言模型泄露PLI数据成为新的研究方向,该数据集为构建安全可靠的对话系统提供了关键训练资源。
以上内容由遇见数据集搜集并总结生成


