
Phudish/amd-2021-llama-3.2-3b-n65536
收藏官方服务:
资源简介:
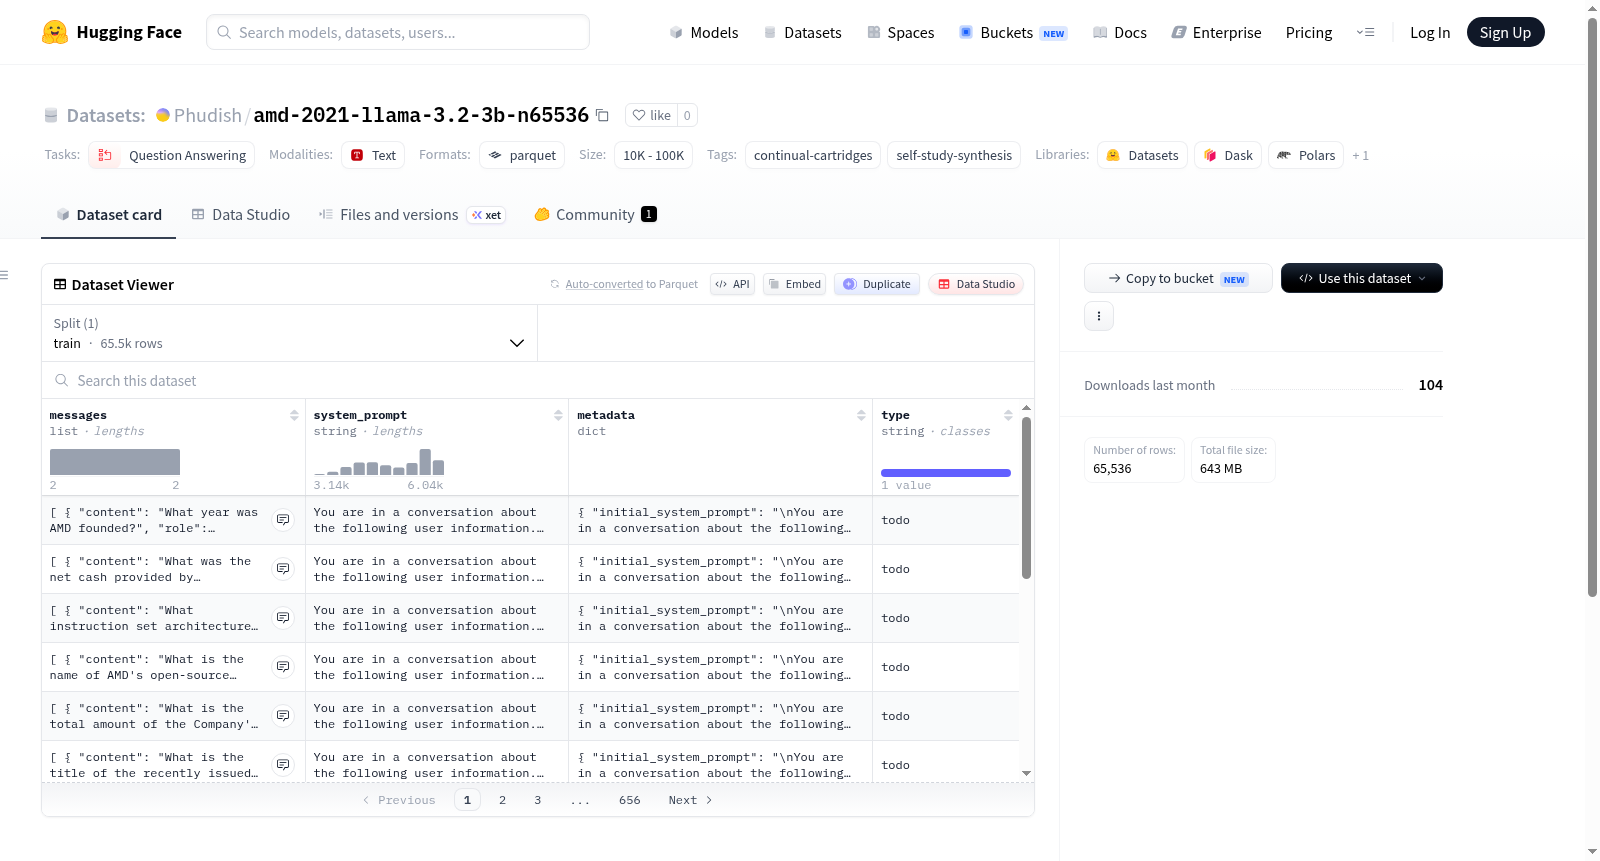
该数据集基于AMD-2021数据集,使用Llama 3.2 3B模型生成,包含65536个样本,专为问答任务设计。标签表明其可能涉及持续学习框架或合成数据生成技术,适用于自然语言处理中的问答系统训练和评估。
This dataset is based on the AMD-2021 dataset, generated using the Llama 3.2 3B model, containing 65,536 samples, and is specifically designed for question-answering tasks. Tags suggest it may involve continual learning frameworks or synthetic data generation techniques, suitable for training and evaluating question-answering systems in natural language processing.
提供机构:
Phudish搜集汇总
数据集介绍
构建方式
本数据集名为amd-2021-llama-3.2-3b-n65536,其构建基于持续精炼与自学习合成技术,通过将Llama 3.2-3B模型在特定领域内进行知识蒸馏与迭代优化,以生成面向问答任务的高质量数据集。具体而言,利用自监督合成方法从原始语料中提取并重组信息,形成具有长序列特征的样本,最终汇聚为一套包含65536个样本的问答数据集。
特点
该数据集最显著的特点在于其针对长上下文问答场景的精心设计,样本长度延伸至65536个token,能够有效支持对长篇文档或复杂对话的理解与推理。此外,数据集融合了持续精炼与自学习合成两大技术路线,确保了数据内容在领域专业性与回答准确性上的双重保障,为大型语言模型的微调与评估提供了坚实的基础。
使用方法
使用者可通过HuggingFace的datasets库便捷加载该数据集,只需执行简单的Python代码:`from datasets import load_dataset; ds = load_dataset("Phudish/amd-2021-llama-3.2-3b-n65536")`。加载后的数据集可直接用于模型微调、评估或作为问答任务的基准测试集,支持常见的数据预处理与批处理操作,便于无缝集成至现有的深度学习工作流中。
背景与挑战
背景概述
该数据集名为amd-2021-llama-3.2-3b-n65536,由Phudish研究团队基于Meta的Llama 3.2 3B模型构建,创建于2021年后,聚焦于持续学习(continual learning)与自监督合成(self-study synthesis)领域。核心研究问题在于如何在大规模语言模型上实现高效的知识继承与参数扩展,以应对长序列任务(如n65536上下文窗口)的挑战。该数据集通过问题回答(question-answering)形式,为模型提供渐进式训练样本,推动了持续学习框架在低资源场景下的适应性研究,对提升模型在动态环境中的泛化能力具有重要影响。
当前挑战
该数据集所解决的领域挑战在于大语言模型在长上下文任务中易出现灾难性遗忘,即模型在增量学习新知识时丢失旧知识,同时自监督合成数据需平衡真实性与多样性,避免引入噪声。构建过程中面临的挑战包括:大规模参数(3B)下的高效微调策略设计,确保n65536超长序列的上下文连贯性;合成样本的质量控制,避免语法或逻辑偏差;以及数据集规模与计算资源之间的权衡,需在有限标注成本下覆盖足够广泛的任务场景,以实现持续学习的稳定性与可扩展性。
常用场景
经典使用场景
作为基于Meta LLaMA 3.2-3B微调的持续学习问答数据集,amd-2021-llama-3.2-3b-n65536在高效参数更新与知识继承的研究中扮演着关键角色。该数据集最经典的场景在于评估大语言模型在连续训练过程中对近期知识的记忆能力与旧知识的遗忘程度,尤其适用于分析一次性学习(Continual Learning)框架下模型对时序问答数据的适应性。研究者通常利用该数据集中的长序列样本(n65536)来检验模型在处理超长上下文时的回答准确性与连贯性,从而为构建具有持续学习能力的问答系统提供基准。
解决学术问题
该数据集的核心价值在于解决大语言模型在持续学习场景下常见的灾难性遗忘问题。通过构造时序化问答样本,它允许学术界系统性地研究模型在接收新知识后,如何维持对旧知识的准确检索与推理能力。amd-2021-llama-3.2-3b-n65536的出现填补了持续学习领域缺少针对超长上下文与自监督合成数据评估的空白,推动了诸如弹性权重巩固(EWC)、内存重放等增量学习策略在语言模型上的改进,其影响在模型部署的终身学习与知识更新场景中尤为显著。
衍生相关工作
该数据集衍生了若干探索参数高效持续学习方法的工作,包括基于低秩适应(LoRA)的模块化知识注入、提示池(Prompt Pool)策略在问答任务中的迁移,以及利用合成数据进行知识蒸馏以保持模型稳定性的研究。同时,amd-2021-llama-3.2-3b-n65536推动了持续学习评测基准(如ContinualQA)的建立,相关研究进一步对比了不同回放机制与正则化技术对模型长序列问答性能的影响,为后续像L2P(Learning to Prompt)和DualPrompt这类代表性方法提供了重要的实验数据基础。
以上内容由遇见数据集搜集并总结生成


