
huggingartists/i-dont-know-how-but-they-found-me
收藏官方服务:
资源简介:
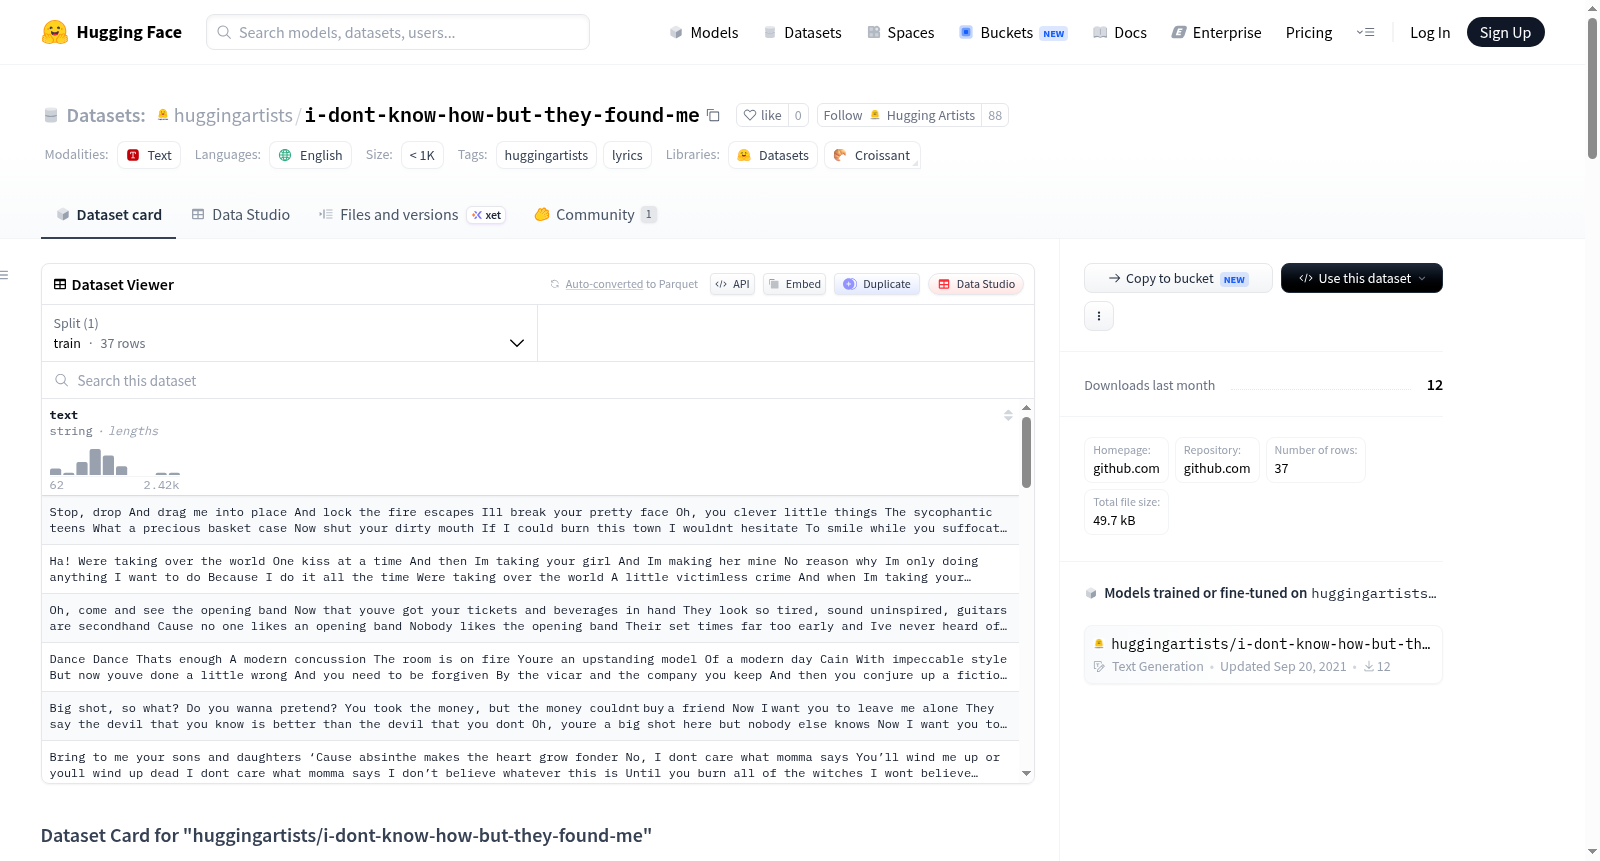
该数据集包含从Genius解析的歌词数据,旨在用于生成歌词。数据集大小为0.064932 MB,包含37个训练样本,没有验证和测试集。数据集的结构包括一个text字段,用于存储歌词文本。
This dataset contains lyric data parsed from Genius, and is intended for lyric generation tasks. It has a size of 0.064932 MB, including 37 training samples with no validation or test sets. The dataset structure includes a "text" field for storing lyric texts.
提供机构:
huggingartists原始信息汇总
数据集概述
数据集名称
"huggingartists/i-dont-know-how-but-they-found-me"
数据集摘要
该数据集是从Genius解析的歌词数据,旨在用于HuggingArtists模型生成歌词。
支持的任务和排行榜
[更多信息待补充]
语言
英语(en)
数据集结构
数据字段
text: 字符串类型,包含歌词文本。
数据分割
train: 37条数据validation: 未提供test: 未提供
数据加载示例
python from datasets import load_dataset
dataset = load_dataset("huggingartists/i-dont-know-how-but-they-found-me")
数据集创建
来源数据
[更多信息待补充]
注释
[更多信息待补充]
个人和敏感信息
[更多信息待补充]
使用数据时的考虑
数据集的社会影响
[更多信息待补充]
偏见讨论
[更多信息待补充]
其他已知限制
[更多信息待补充]
附加信息
数据集管理员
[更多信息待补充]
许可信息
[更多信息待补充]
引用信息
@InProceedings{huggingartists, author={Aleksey Korshuk} year=2021 }
搜集汇总
数据集介绍
构建方式
在音乐与自然语言处理的交叉领域中,歌词数据集的构建对于生成式模型的发展至关重要。huggingartists/i-dont-know-how-but-they-found-me 数据集源自著名的歌词平台 Genius,通过系统化地爬取与解析该乐队(I DONT KNOW HOW BUT THEY FOUND ME)的歌词文本,形成了结构化的语料库。整个构建流程聚焦于文本的纯净性与完整性,每条数据仅保留歌词正文,去除了元数据与无关标识,最终生成的数据集大小约为0.065 MB,包含37条训练样本,为小规模但高质量的歌词生成任务奠定了基础。
特点
该数据集的核心特点在于其专一性与简洁性。数据仅包含单一的 'text' 字段,存储完整的歌词字符串,格式统一且无需额外预处理,便于直接接入各类文本生成管道。作为 HuggingArtists 项目的一部分,它专注于特定艺术家的歌词风格,使得模型能够学习到该乐队独特的词作韵律与表达习惯。此外,数据集虽小,但提供了灵活的划分方案,用户可依据自定义比例(如90%训练、7%验证、3%测试)通过简单代码实现数据分割,适应不同规模的实验需求。
使用方法
使用该数据集极为便捷,兼容 Hugging Face 的 datasets 库,用户仅需一行代码即可完成加载:`dataset = load_dataset('huggingartists/i-dont-know-how-but-they-found-me')`。加载后的数据集以字典形式呈现,默认包含 'train' 分割。为进行模型训练与评估,可借助 NumPy 库按需切分为训练集、验证集与测试集,具体通过 `np.split` 函数结合预设比例实现。这一设计降低了使用门槛,使研究者能快速将数据应用于歌词生成、风格迁移或文本分析等任务,尤其适合探索小样本学习与音乐文本生成的交叉领域。
背景与挑战
背景概述
在自然语言处理与音乐信息检索的交叉领域,歌词生成任务因其融合了语言韵律、情感表达与艺术创作的多重复杂性,逐渐成为研究者关注的焦点。由Aleksey Korshuk于2021年主导创建的HuggingArtists项目,旨在通过构建艺术家专属的歌词数据集,推动基于Transformer的文本生成模型在音乐创作领域的应用。该数据集聚焦于美国独立摇滚乐队I DONT KNOW HOW BUT THEY FOUND ME,从Genius平台系统采集其全部37首歌曲的英文歌词,形成轻量级但高度专业化的语料库。作为HuggingArtists系列中针对特定音乐人的数据集之一,它为探索小样本学习场景下的歌词风格迁移、艺术人格建模等课题提供了独特的研究样本,对理解当代独立音乐的语言特征与生成式创作范式具有开创性意义。
当前挑战
该数据集面临的核心挑战体现在两个层面。在领域问题层面,歌词生成需同时满足语义连贯性、押韵结构、情感强度与音乐节奏感等多维约束,远超普通文本生成的技术要求;而仅有37条样本的极小规模数据,使得模型难以捕捉艺术家的完整创作风格与词汇偏好,易陷入过拟合或生成内容同质化困境。在构建过程中,数据采集完全依赖Genius平台的用户提交内容,缺乏官方授权的元数据校验,可能导致歌词版本错误、时间戳缺失或非标准分词等问题;此外,单来源数据采集模式无法覆盖乐队在不同专辑、现场演出或访谈中的即兴创作片段,限制了数据集对艺术家语言全貌的表征能力。
常用场景
经典使用场景
在自然语言处理与音乐智能创作的交汇领域,huggingartists/i-dont-know-how-but-they-found-me数据集为歌词生成任务提供了精炼而富有艺术个性的语料基础。该数据集汇集了美国独立流行乐队I DONT KNOW HOW BUT THEY FOUND ME的原创歌词,经过结构化处理后,特别适用于训练面向特定艺术家风格的语言模型。研究者可借助此数据集,探索如何通过小样本学习捕捉乐队独特的叙事口吻、修辞偏好与韵律节奏,从而在可控文本生成中复现其标志性的音乐文学特质。
解决学术问题
该数据集有效回应了音乐文本生成领域中的两个关键学术挑战:其一,如何在小规模语料条件下实现高保真的艺术家风格迁移,传统大模型依赖海量数据,而本数据集以仅37条训练样本验证了参数高效微调(如LoRA)在歌词模仿中的可行性;其二,为计算韵律学与情感计算研究提供了结构化素材,通过分析歌词中重复的意象模式与情绪张力,推动了从符号序列到情感语义映射的理论探索。这一工作弥合了音乐学与自然语言处理之间的方法论鸿沟。
衍生相关工作
围绕该数据集衍生出的经典工作主要集中在HuggingArtists项目框架内,该框架通过统一接口将多艺术家歌词数据集与预训练语言模型(如GPT-2)衔接,开创了“艺术家风格迁移微调”的标准化流程。后续研究在此基础上引入了对比学习策略,通过负采样增强模型对不同乐队语体差异的辨识力。另有工作将其与音乐音频特征联合建模,探索歌词-旋律跨模态生成的可能性,推动了多模态音乐智能领域的发展。
以上内容由遇见数据集搜集并总结生成


