electricsheepafrica/africa-cancer-late-stage
收藏资源简介:
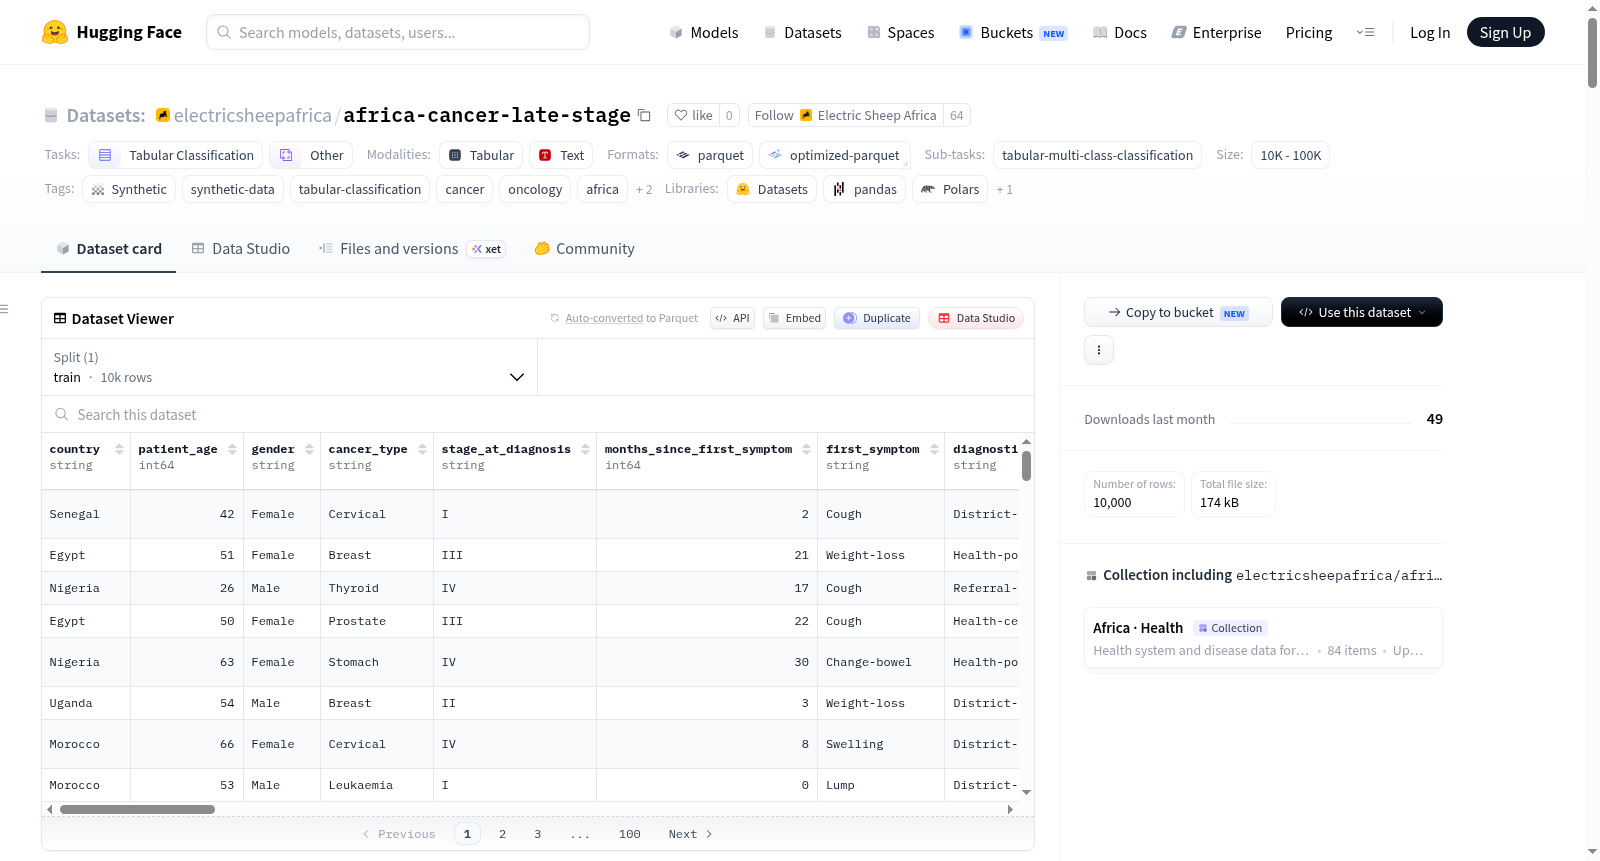
一个针对非洲人群癌症诊断阶段的合成表格数据集。捕捉了从首次症状到治疗开始的诊断过程。
标签: - 合成数据(synthetic) - 合成数据集(synthetic-data) - 表格分类(tabular-classification) - 癌症 - 肿瘤学(oncology) - 非洲 - 医疗保健 - 晚期(late-stage) 任务类别: - 表格分类(tabular-classification) - 其他 任务ID: - 表格多分类(tabular-multi-class-classification) 语言:[] 数据集名称:非洲癌症晚期诊断数据集(Cancer Late-Stage Diagnosis Dataset) 样本量范围:10000 < n < 100000 # 非洲癌症晚期诊断数据集 ## 数据集说明 本数据集为面向非洲人群的癌症诊断分期合成表格数据集,完整记录患者从首次出现症状至启动治疗的全诊断流程。 ## 数据集统计指标 | 指标 | 数值 | |----------|-------| | 总样本量 | 10,000 | | 阳性样本(标签=1) | 5,000 | | 对照样本(标签=0) | 5,000 | | 覆盖国家 | 20个 | | 时间覆盖范围 | 2019–2024年 | | 特征数量(原始+工程化特征) | 40余个 | | 缺失值占比 | 0%(完整合成数据集) | | 数据格式 | 表格型逗号分隔值(CSV) | | 随机种子 | 42 | ## 类别平衡与分布 本数据集采用严格的50/50平衡采样,以避免下游模型出现类别不平衡偏差。国家采样遵循反映非洲人口与疾病负担分布的流行病学权重。所有分类特征均保留为字符串标签,以提升可解释性。 ## 研究空白 非洲70%~80%的癌症患者确诊时已处于III/IV期。诊断延迟问题严峻,治疗可及性极低,感染相关性癌症占比居高,且儿童肿瘤学预后结果极差。 ## 非洲医疗保健现状 - 28个非洲国家无放射治疗设备 - 多数国家全国病理医师数量不足10人 - 乳腺癌5年生存率:非洲为40%,北美为90% - 人乳头瘤病毒(HPV)与乙型肝炎病毒(HBV)疫苗接种覆盖率不足 ## 信息来源 | 信息来源 | 链接 | |--------|-----| | 世界卫生组织癌症专题(WHO Cancer) | https://www.who.int/health-topics/cancer | | 非洲癌症研究网络(AFCRN) | https://afcrn.org/ | | 国际癌症研究机构(IARC) | https://www.iarc.who.int/ | | 国际抗癌联盟(UICC) | https://www.uicc.org/ | | 非洲肿瘤学培训与研究协作组织(AORTIC) | https://www.aortic-africa.org/ | ## 数据列详情 | 列名 | 数据类型 | 描述 | |--------|------|-------------| | country | 字符串 | 国家 | | patient_age | 整数 | 患者年龄 | | gender | 字符串 | 性别 | | cancer_type | 字符串 | 癌症类型 | | stage_at_diagnosis | 字符串 | 确诊分期 | | months_since_first_symptom | 整数 | 首次症状出现后至确诊的月数 | | first_symptom | 字符串 | 首发症状 | | diagnostic_facility_type | 字符串 | 诊断机构类型 | | pathology_confirmed | 整数 | 病理确诊情况 | | imaging_available | 整数 | 是否具备影像学检查 | | biomarker_tested | 整数 | 是否进行生物标志物检测 | | hpv_status | 字符串 | 人乳头瘤病毒(HPV)感染状态 | | hbv_status | 字符串 | 乙型肝炎病毒(HBV)感染状态 | | hiv_status | 整数 | 人类免疫缺陷病毒(HIV)感染状态 | | diabetes | 整数 | 是否患有糖尿病 | | tobacco_use | 整数 | 烟草使用情况 | | alcohol_use | 整数 | 酒精摄入情况 | | family_history | 整数 | 癌症家族史 | | previous_cancer | 整数 | 既往癌症病史 | | comorbidity_count | 整数 | 合并症数量 | | insurance_type | 字符串 | 保险类型 | | treatment_accessed | 整数 | 是否接受治疗 | | treatment_modality | 字符串 | 治疗方式 | | distance_oncology_km | 整数 | 至肿瘤专科机构的距离(公里) | | oncologist_available | 整数 | 附近是否有肿瘤医师 | | radiotherapy_available | 整数 | 是否具备放射治疗条件 | | chemotherapy_available | 整数 | 是否具备化学治疗条件 | | palliative_available | 整数 | 是否具备姑息治疗条件 | | clinical_trial_access | 整数 | 是否可参与临床试验 | | time_to_treatment_days | 整数 | 至启动治疗的天数 | | lost_to_followup | 整数 | 是否失访 | | survival_12m | 整数 | 12个月生存情况 | | label | 整数 | 标签:1=晚期癌症,0=早期癌症 | ## 工程化特征 | 工程化特征 | 描述 | |---------|-------------| | diagnostic_delay_severity | 诊断延迟严重程度(首次症状至确诊月数+确诊分期) | | diagnostic_capacity_score | 诊断能力评分(病理检查+影像学检查+生物标志物检测) | | treatment_access_barrier | 治疗可及性障碍(机构类型+距离+专科医师资源) | | comorbidity_burden | 合并症负担(合并症数量+HIV感染状态+生活方式) | | socioeconomic_vulnerability | 社会经济脆弱性(保险类型风险) | | high_risk_cancer | 高风险癌症标记(晚期/死亡标记) | ## 特征工程方法 复合评分基于文献与临床指南推导的领域专属权重构建,所有评分均保留至小数点后两位以确保可复现性。原始特征列保留了各组成部分的原始贡献度,便于研究人员重构或调整复合评分。 **高风险标记**为二分类指标,当多个风险维度同时超过阈值时触发。该设计优先保证敏感性(覆盖绝大多数高风险病例)而非完美特异性,适用于分诊与筛查场景。 ## 特征重要性说明 基于初步随机森林(Random Forest)分析结果: - 复合风险评分通常位列前5个最重要的特征 - 国家指示变量可提供显著的地理分布信号 - 时间特征(年份、季节)可捕捉长期趋势 - 基础设施与患者个体变量间的交互效应具有统计学意义 - 务必在留出测试集上验证特征重要性,以避免数据泄露(leakage) ## 支持的应用场景 - 晚期癌症预测 - 诊断延迟分析 - 治疗脱落预测 - 死亡率预测 - 医疗资源分配 - 筛查优先级排序 - 姑息治疗需求评估 ## 高级建模方法 - **生存分析(Survival analysis)**:针对存在事件时间结局的数据集,可使用Cox比例风险模型构建风险轨迹 - **多任务学习(Multi-task learning)**:联合预测标签与中间结局(如并发症类型、严重程度分级) - **代价敏感学习(Cost-sensitive learning)**:在筛查场景中,将假阴性的权重设置高于假阳性 - **不确定性量化(Uncertainty quantification)**:使用保序回归预测或贝叶斯方法标记低置信度预测结果,以供人工复核 - **因果推断(Causal inference)**:基于机构类型或国家进行倾向得分匹配,以评估干预措施的效应 - **联邦学习(Federated learning)**:无需集中数据即可在模拟医院节点间训练模型 - **可解释人工智能(Explainable AI, XAI)**:SHAP与LIME值可帮助临床医师理解模型生成的风险评分 ## 使用示例 python from datasets import load_dataset dataset = load_dataset("electricsheepafrica/africa-cancer-late-stage", split="train") df = dataset.to_pandas() python import pandas as pd from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import classification_report, roc_auc_score df = pd.read_csv("data/processed/cancer_features.csv") X = df.select_dtypes(include=["int", "float"]).drop(columns=["label"]) y = df["label"] X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=42) clf = RandomForestClassifier(random_state=42) clf.fit(X_train, y_train) print(classification_report(y_test, clf.predict(X_test))) print("ROC-AUC:", roc_auc_score(y_test, clf.predict_proba(X_test)[:, 1])) ## 数据生成流程 1. 针对晚期癌症且存在诊断延迟的病例生成阳性样本 2. 针对早期确诊的病例生成对照样本 3. 针对早期确诊且经病理证实的样本进行数据泄露过滤 4. 保持5000+5000的平衡样本量 5. 生成诊断延迟严重程度与治疗可及性障碍特征 6. 随机种子设置为42 ## 预处理建议 1. 对分类列(国家、机构类型、地区等)进行独热编码(One-hot encode) 2. 对连续特征进行标准化处理(Z-score或MinMax归一化),以适配基于距离的模型 3. 划分数据集时按国家进行分层采样,以保证地理分布代表性 4. 若需进行子采样,可使用SMOTE或类别权重调整;本数据集已实现平衡 5. 交叉验证:采用按国家分组的5折分层交叉验证,以检测模型对特定国家的过拟合 6. 特征选择:工程化复合评分具有较高的信息价值,需与原始特征对比评估 7. 数据泄露检查:确保从特征集中移除由标签衍生的列(如结局、确诊分期) ## 基准模型性能预期 | 模型 | 预期准确率 | 预期ROC-AUC | 备注 | |-------|------------------|------------------|-------| | 逻辑回归 | 0.72–0.78 | 0.78–0.84 | 可解释性优异的基准模型 | | 随机森林 | 0.82–0.88 | 0.88–0.93 | 可较好处理非线性交互效应 | | XGBoost / LightGBM | 0.85–0.91 | 0.91–0.95 | 表格数据建模最优表现 | | 神经网络(MLP) | 0.80–0.86 | 0.85–0.90 | 需进行特征缩放,存在过拟合风险 | | 线性支持向量机(Linear SVM) | 0.74–0.80 | 0.80–0.85 | 对特征缩放敏感 | 上述为80/20分层训练测试集上的近似性能范围,实际结果可能因特征工程与超参数调优而有所差异。 ## 统计特性 - **阳性样本**:从以高风险临床特征为中心的分布中采样,有意保留分布重叠以反映真实世界的异质性 - **对照样本**:从低风险特征分布中采样,但保留真实的方差;约10%的对照样本可能显示轻微的风险指标 - **数据泄露过滤**:移除临床分类应为阳性的对照样本,以保证类别间的清晰区分 - **国家权重**:基于世界卫生组织(WHO)/联合国儿童基金会(UNICEF)的疾病负担估计与人口规模推导 - **相关结构**:工程化特征与原始临床指标有意保留相关性;在线性模型中需避免重复计数 - **噪声注入**:连续变量添加均匀分布噪声,以避免模型过拟合于合成数据的精确阈值 - **时间一致性**:年份、季节与天气异常值的生成保持一致性(如干旱月份与作物减产相关联) ## 验证清单 在将本数据集用于研究或生产前,请完成以下检查: - [ ] 验证训练测试集中的类别平衡情况 - [ ] 检查工程化特征与标签间是否存在非预期的相关性 - [ ] 验证高风险标记在极端案例中的表现是否符合预期 - [ ] 确认国家分层不会虚假主导模型预测结果 - [ ] 通过完全留出一个或多个国家的数据测试模型泛化能力 ## 局限性 - 合成癌症登记数据 - 癌症类型简化处理 - 仅支持二分类生存结局 ## 伦理考量 - 保护患者隐私 - 避免使用确定性生存预测 - 保障早期检测的公平可及性 - 支持本地医疗能力建设 - 避免医疗旅游偏差 ## 数据治理与保护 - **匿名化处理**:所有记录均为合成数据,未包含任何真实患者、家庭或机构的标识信息 - **合成数据验证**:部署前需验证合成数据的分布与目标国家的真实监测数据一致 - **社区参与**:部署预测工具前需咨询当地卫生主管部门与社区群体 - **算法公平性**:审计模型在不同国家、性别与社会经济阶层间的性能差异 - **解释权**:若用于临床或政策决策,需提供可解释的模型输出 - **数据留存**:后续收集的任何真实数据需遵循机构与国家的数据保护政策 - **收益共享**:确保为数据集做出贡献或被数据集覆盖的社区能够从相关工具与研究成果中获益 - **开放科学**:在发表同行评议研究成果时,同步公开方法学、代码与模型卡片 ## 推荐数据集划分 - 训练集:70% - 验证集:15% - 测试集:15% ## 引用格式 bibtex @dataset{cancer_late_stage_africa_2024, title = {Cancer Late-Stage Diagnosis Dataset}, author = {Electric Sheep Africa}, year = {2024}, url = {https://huggingface.co/datasets/electricsheepafrica/africa-cancer-late-stage} } ## 许可协议 知识共享署名-相同方式共享4.0国际许可协议(CC BY-SA 4.0) ## 联系方式 electricsheepafrica@proton.me ## 版本历史 - v1.0 — 初始发布