遇见数据集

l0-qwen3-1.7b-compression-bs32-n16-32k-t1-no-eos-verl091-146102-rollouts

收藏
Hugging Face2026-09-30 更新2026-10-01 收录
官方服务:

资源简介:

该数据集为强化学习(RL)训练过程中生成的rollouts(轨迹响应)数据,专门用于压缩数学验证(compression MathVerify)任务。数据来自使用Qwen3-1.7B模型、批大小32、采样数16、序列长度32k、温度1、无EOS门控的训练实验。每个训练步骤提供一个经过验证的gzip压缩JSONL分片,每个分片包含512个响应。数据格式为标准JSONL,每条记录对应一个模型生成的输出。适用于强化学习中的策略优化、奖励建模或模型微调等场景。

This dataset consists of rollouts (trajectory responses) generated during reinforcement learning (RL) training, specifically for the compression MathVerify task. The data comes from training experiments using the Qwen3-1.7B model with batch size 32, sample count 16, sequence length 32k, temperature 1, and no EOS gating. Each training step provides a verified gzip-compressed JSONL shard, and each shard contains 512 responses. The data format is standard JSONL, where each record corresponds to an output generated by the model. It is suitable for policy optimization, reward modeling, or model fine-tuning in reinforcement learning scenarios.

创建时间:
2026-09-30
原始信息汇总

数据集概述

基本信息

  • 数据集名称:l0_Qwen3-1.7B_compression_bs32_n16_32k_t1_no_eos_verl091
  • 许可证:apache-2.0
  • 数据集类型:RL training rollouts(强化学习训练输出)

内容结构

  • 每个训练步骤对应一个已验证的 gzip JSONL 分片。
  • 每个分片包含 512 条响应。

数据处理说明

  • 采用 Historical compression MathVerify,在 thinking 之后进行验证。
  • 不使用 EOS gate。
搜集汇总
数据集介绍
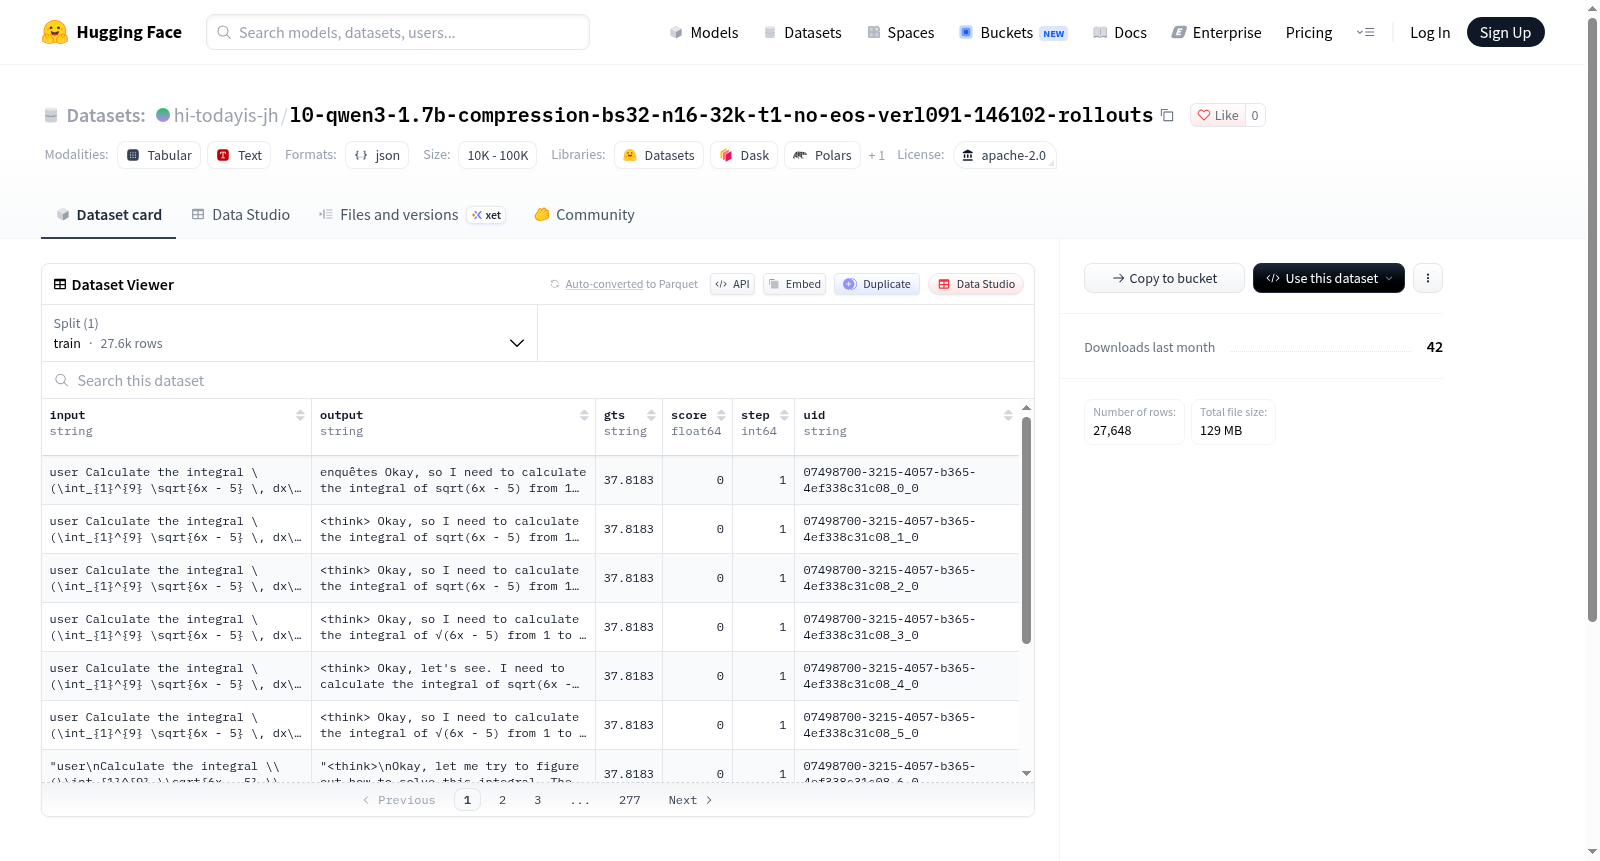
l0-qwen3-1.7b-compression-bs32-n16-32k-t1-no-eos-verl091-146102-rollouts 数据集图片
构建方式
该数据集源于强化学习训练过程中对Qwen3-1.7B模型进行压缩任务探索所生成的轨迹记录。构建时,每个训练步骤对应一个经过验证的gzip压缩JSONL分片,每片包含512条模型响应。这些响应的生成基于历史压缩任务,在模型完成思考过程后触发MathVerify验证机制,且未设置EOS门控条件,从而保留了更多潜在的推理路径。数据集的命名编码了批次大小、采样数、序列长度、温度参数及框架版本等关键配置,实现了对训练上下文的结构化封装。
特点
数据集的核心特征体现在其分片式组织与验证机制上。每片512条响应提供了细粒度的步级训练快照,gzip压缩格式在保证存储效率的同时维持了数据完整性。MathVerify的引入确保了每条响应在思考后经过数学验证,提升了数据的可靠性。无EOS门控的设计使得响应序列不因终止符而截断,保留了更完整的推理链。命名中嵌入的超参数信息(如bs32、n16、32k、t1)为实验复现提供了精确的配置线索,而verl091标识了所依赖的强化学习框架版本。
使用方法
使用该数据集时,需通过gzip解压获得JSONL格式文件,每一行对应一条模型响应记录。研究人员可按照训练步骤索引各分片,利用512条响应的批量结构进行策略优化或奖励建模分析。由于数据集标注了无EOS门控和MathVerify验证特性,使用者应在训练或评估中注意响应可能不包含结束符,需自行处理序列截断或填充。结合命名中的超参数,可复现特定压缩任务下的强化学习实验,或对比不同温度与采样数对模型推理行为的影响。该数据集适用于压缩任务下的策略梯度方法研究,以及验证机制对训练稳定性的消融分析。
背景与挑战
背景概述
随着大语言模型规模持续膨胀,推理阶段的压缩与加速成为部署落地的关键瓶颈,以强化学习驱动的压缩策略逐渐受到学界与工业界关注。该数据集由相关研究团队于2025年前后构建,依托Qwen3-1.7B基础模型,在32k上下文长度下以批大小32、每样本16条采样、温度1.0的配置开展rollout,记录每训练步经校验的gzip JSONL分片,每片含512条响应,且采用历史压缩MathVerify评测而省略EOS门控。其核心研究问题在于探索无EOS约束下RL训练对模型压缩行为的影响,为压缩感知的强化学习训练提供可复用的轨迹数据,对模型压缩与推理优化领域具有参考价值。
当前挑战
该数据集所针对的领域问题在于大语言模型在长上下文场景下的高效压缩与推理成本控制,需在保持输出质量的同时显著降低表示冗余,这一目标本身具有高度非凸与稀疏奖励特性。构建过程中,团队面临多重挑战:rollout数据需在无EOS门控条件下保证压缩行为的可验证性,MathVerify后验校验需与gzip分片存储保持一致,清洗与去重须避免训练步间的分布漂移,且固定采样配置可能引入响应多样性受限的风险。此外,去除EOS门控虽有利于观察压缩决策的连续性,却也增加了终止行为不可控与奖励信号稀疏的难度。
常用场景
经典使用场景
在强化学习驱动的大规模语言模型训练中,该数据集充当轨迹回放与策略优化的核心素材。其以gzip压缩的JSONL分片形式,按训练步序存储每一步的512条模型响应,为离线策略评估与在线策略迭代提供细粒度记录。典型用法包括:从分片内提取推理链与最终答案,计算数学验证奖励,进而更新策略网络;同时支持对压缩后思维链的完整性分析,无需依赖EOS门控,便于研究无终止符场景下的生成行为。
实际应用
在实际工程中,该数据集用于调试和监控基于Qwen3-1.7B的强化学习训练流程,尤其适用于压缩推理任务。开发人员可以逐分片加载回放,验证奖励计算逻辑的一致性,排查训练异常步次;亦可用于离线超参数搜索,比较不同压缩率与批量大小对策略收敛的影响。其gzip分片结构便于分布式存储与并行读取,适合集成到持续训练流水线中,作为策略更新前的经验池。
衍生相关工作
围绕该数据集,衍生出的经典工作包括基于分组相对策略优化的压缩推理训练方法,以及无EOS门控下的数学验证奖励建模研究。后续工作利用其分片结构,开展训练步间策略漂移分析、压缩思维链长度与答案正确性的相关性研究,并开发了针对JSONL分片的快速加载与过滤工具。这些工作共同促进了强化学习训练数据的标准化与可复用性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务