遇见数据集

scostiniano/storytelling_books_filipino

收藏
Hugging Face2022-11-24 更新2024-03-04 收录
官方服务:

资源简介:

该数据集包含148本菲律宾故事书,总计5,005个句子,45,792个标记和5,646个唯一标记。该NER模型目前仅支持菲律宾语,并且不包括专有名词、动词、形容词和副词。输入数据需要经过预处理,预处理代码将上传到GitHub。数据集的结构包括数据实例和字段描述,数据实例展示了标记和标签的示例,字段描述包括标记和标签的序列。数据集被分为训练集和验证集,训练集包含3,279个样本,验证集包含1,244个样本。

This dataset comprises 148 Philippine storybooks, with a total of 5,005 sentences, 45,792 tokens, and 5,646 unique tokens. This NER model currently only supports Filipino, and does not cover proper nouns, verbs, adjectives, and adverbs. Input data must undergo preprocessing, and the preprocessing code will be uploaded to GitHub. The dataset structure consists of data instances and field descriptions: data instances showcase examples of tokens and labels, while field descriptions detail sequences of tokens and labels. The dataset is split into training and validation sets, with the training set containing 3,279 samples and the validation set comprising 1,244 samples.

提供机构:
scostiniano
原始信息汇总

Filipino Storytelling Books 数据集概述

数据集描述

该数据集包含148本菲律宾故事书,总计5,005个句子,45,792个总词数,以及5,646个独特词数。此NER模型目前仅支持菲律宾语,且不包括专有名词、动词、形容词和副词。

语言信息

  • 语言:菲律宾语
  • BCP-47代码:菲律宾语

数据集结构

数据实例

示例数据结构如下: json [ { "tokens": [ "toot" ], "tags": [ 3 ] }, { "tokens": [ "hindi", "ako", "yun", "boltu" ], "tags": [ 3, 1, 3, 3 ] } ]

数据集字段

  • tokens: 字符串序列
  • tags: 类别标签序列,包含7个类别:[Animals, Humans_Body, Natural_Environment, O, Objects, Transportation, Urban_Environment]

数据集分割

  • 训练集:3279个样本
  • 验证集:1244个样本
搜集汇总
数据集介绍
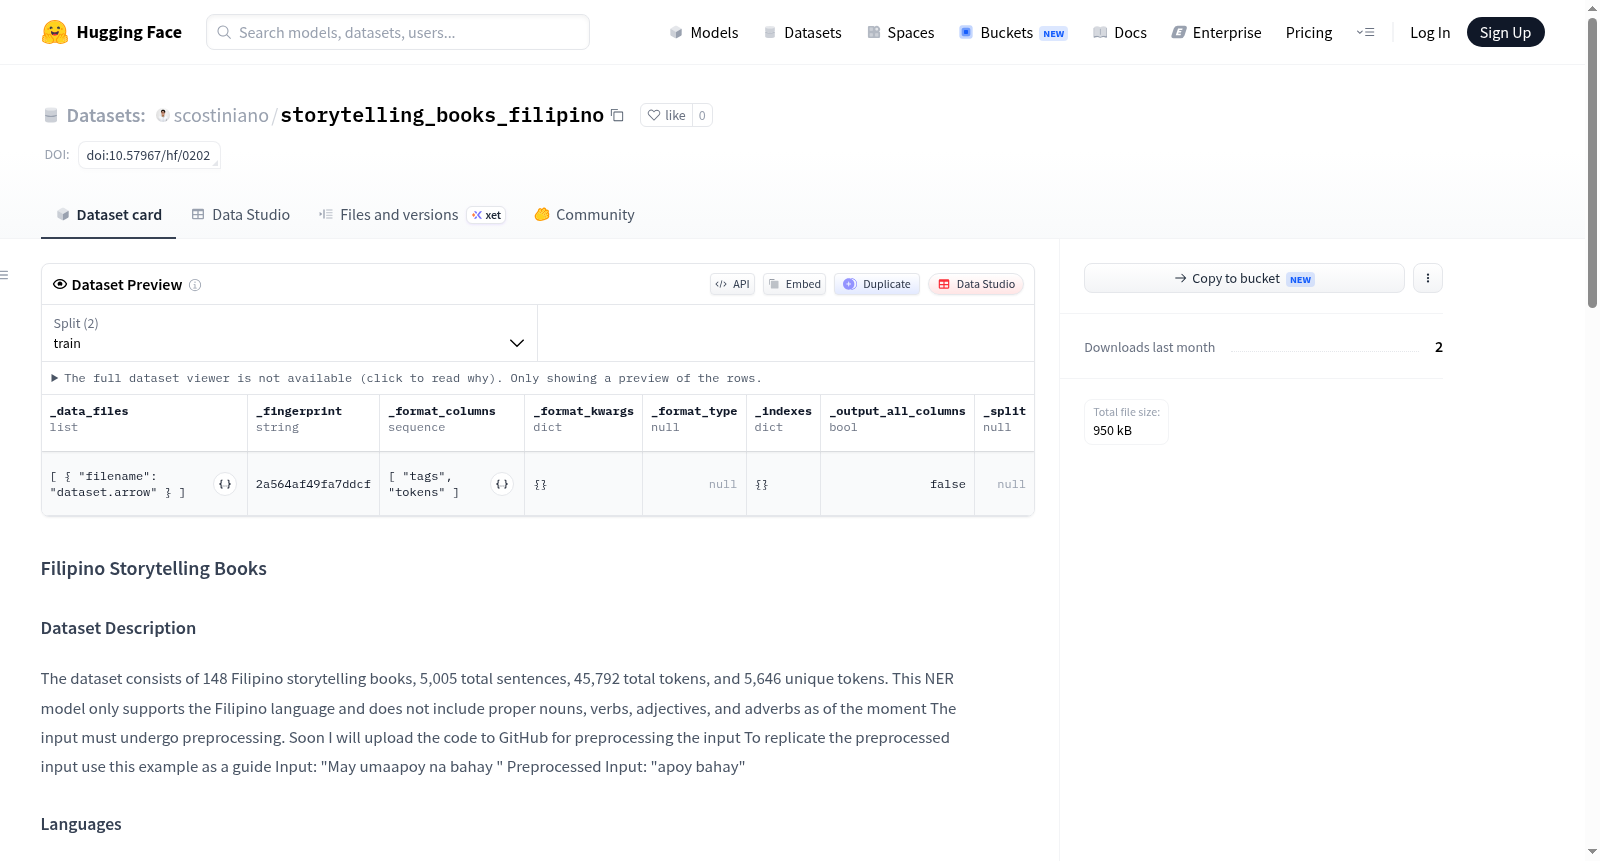
scostiniano/storytelling_books_filipino 数据集图片
构建方式
该数据集以148本菲律宾语故事书为原始语料,通过逐句提取与标注构建而成。数据采集过程中,首先对故事文本进行句子级别分割,共获得5,005个句子,涵盖45,792个词元及5,646个唯一词元。随后采用命名实体识别(NER)标注体系,为每个词元分配7类标签(动物、人类与身体、自然环境、非实体、物体、交通、城市环境),形成结构化的序列标注数据。数据集划分为训练集(3,279条)与验证集(1,244条),以支持模型的训练与评估。
使用方法
使用该数据集时,需遵循特定的预处理流程:输入文本需先经过词干提取与停用词移除,转化为简洁词元序列后方可输入模型。数据集以JSON格式提供,每个实例包含词元列表与对应标签列表,标签以整数编码表示实体类别。用户可直接加载训练集与验证集,用于微调序列标注模型(如BERT、BiLSTM-CRF),或作为基准评估菲律宾语NER系统的性能。当前数据集仅支持菲律宾语,且未提供实体类别名称的映射文件,用户需根据标签索引(0-6)自行关联7类实体含义。
背景与挑战
背景概述
在自然语言处理领域,命名实体识别(NER)是信息抽取的核心任务之一,然而大多数高性能NER模型集中于英语等资源丰富语言,低资源语言如菲律宾语的研究进展相对滞后。为弥合这一鸿沟,scostiniano等人于近期构建了scostiniano/storytelling_books_filipino数据集,该数据集源自148本菲律宾语故事书,包含5,005个句子、45,792个词元及5,646个独特词元,旨在推动菲律宾语的序列标注研究。该数据集聚焦于七类实体标注(如动物、人类/身体、自然环境等),为菲律宾语NER任务提供了标准化的训练与验证资源(训练集3,279样本,验证集1,244样本),填补了该语言在结构化信息抽取领域的空白,对促进东南亚语言的自然语言处理研究具有重要价值。
当前挑战
当前数据集面临多重挑战。首先,在领域问题层面,菲律宾语作为低资源语言,缺乏大规模、高质量的标注语料,该数据集仅涵盖148本故事书,数据规模有限,难以覆盖真实世界中多样的实体类型与上下文语境,制约了NER模型的泛化能力。其次,在构建过程中,数据集明确排除了专有名词、动词、形容词和副词等词类,导致标签体系不完整,无法处理复杂语义场景;此外,输入文本需经过特定预处理(如去除停用词、词干提取),但预处理代码尚未公开,增加了复现与应用的难度。这些限制使得模型在实际部署时可能面临实体识别率低、领域适应性差等瓶颈,亟需扩充语料规模并完善标注规范。
常用场景
经典使用场景
在自然语言处理领域,scostiniano/storytelling_books_filipino数据集以其独特的菲律宾语儿童故事文本为基底,成为命名实体识别(NER)任务在低资源语言中的经典实验平台。该数据集包含148本菲律宾语故事书,共计5005个句子和45792个词元,标注了七类实体标签,涵盖动物、人类与身体、自然环境、物体、交通及城市环境等语义范畴。研究者通常利用其训练和验证集划分(3279条训练样本与1244条验证样本),构建针对菲律宾语的序列标注模型,尤其关注无专有名词、动词、形容词及副词干扰下的纯实体识别能力,为低资源语言的NER基准测试提供了稀缺的标准化语料。
解决学术问题
该数据集直面菲律宾语在自然语言处理中标注资源匮乏的困境,解决了低资源语言领域缺乏高质量、领域聚焦的NER标注数据的学术难题。通过从儿童故事书中提取具有明确实体边界的文本,它助力研究者探索在有限标注样本下如何实现稳健的实体分类,尤其适用于对比预训练多语言模型与基于规则方法的性能差异。其意义在于为东南亚语言信息抽取研究提供了可复现的评估基准,推动了跨语言NER技术向资源稀缺语言的拓展,同时揭示了故事文本中实体分布的特殊性——如自然环境与动物类别的高频出现——对模型泛化能力的挑战。
实际应用
在实际应用中,该数据集驱动的NER模型可赋能菲律宾语教育科技领域的智能内容分析,例如自动识别儿童故事书中的角色、地点与物体,辅助构建互动式阅读推荐系统或个性化学习工具。此外,它支持文化遗产数字化项目,通过从民间故事中批量提取实体信息,促进菲律宾语语料的语义索引与知识图谱构建。在低资源语言信息检索场景中,基于该数据集训练的模型能提升对菲律宾语新闻、社交媒体文本中实体提及的识别准确率,为本地化搜索引擎与舆情监控系统提供核心技术支持。
数据集最近研究
最新研究方向
在自然语言处理领域,低资源语言的命名实体识别(NER)研究正逐渐成为前沿热点,尤其是针对菲律宾语等缺乏大规模标注语料的语言。该数据集通过整理148本菲律宾语故事书,构建了包含5005句、45792个token的标注语料,聚焦于动物、人体、自然环境、物体、交通、城市环境等六大实体类别。其独特之处在于采用基于形态学简化的预处理策略,剔除停用词与冗余成分以提升模型泛化能力。当前研究方向正围绕跨语言迁移学习与数据增强技术展开,旨在利用该数据集训练出能适应菲律宾语口语与书面语混合场景的轻量化NER模型。该工作不仅填补了菲律宾语信息抽取的空白,更推动了东南亚低资源语言在智能阅读、文化遗产数字化等应用中的落地,对促进语言多样性保护与AI普惠具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务