ULVR_all
收藏资源简介:
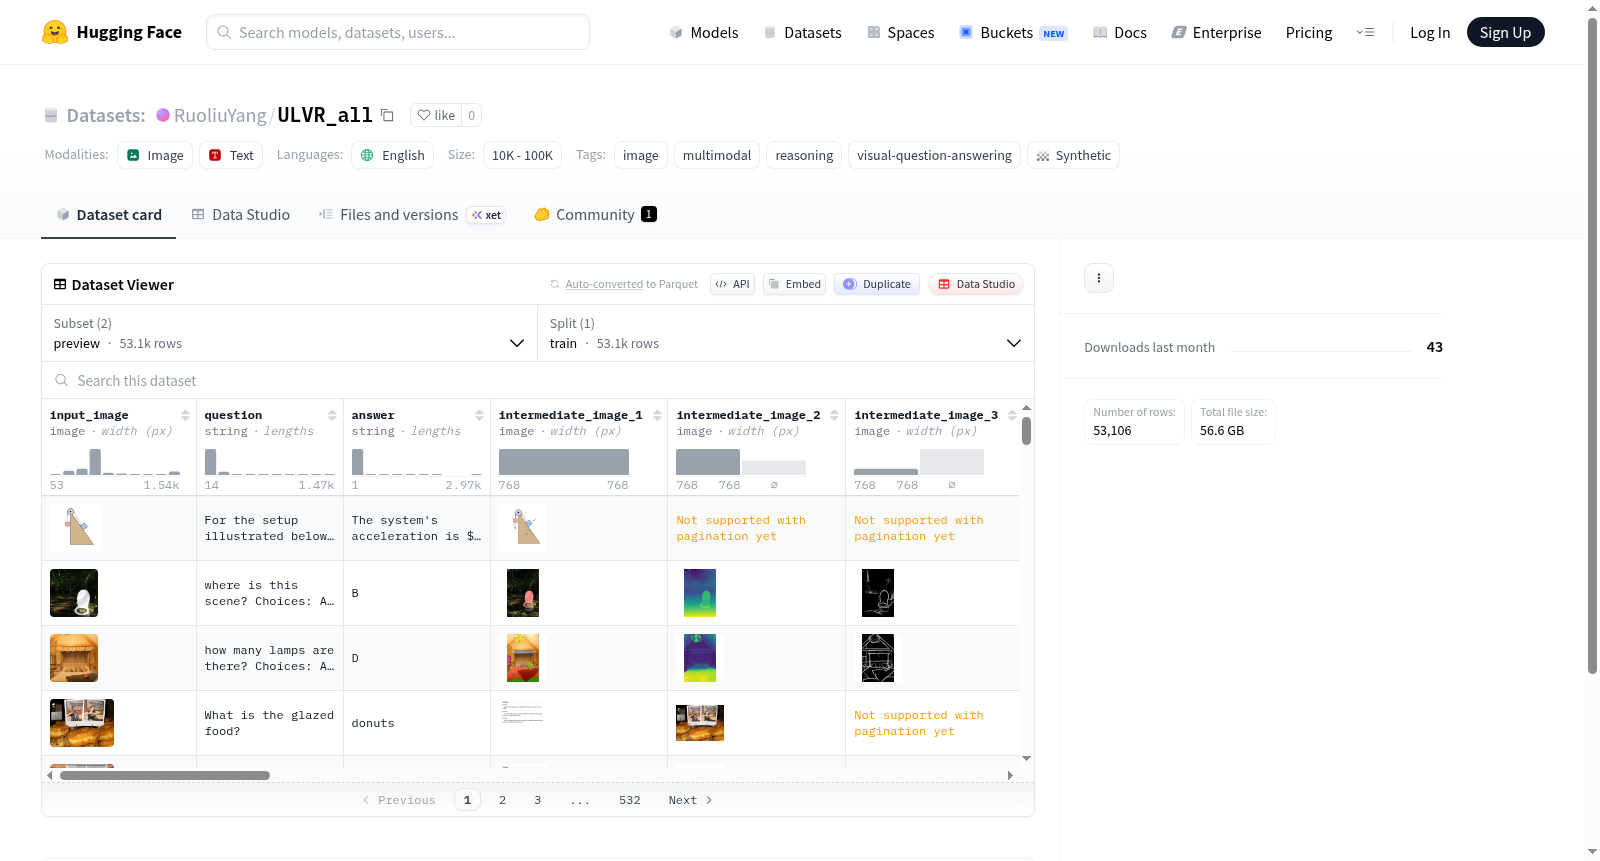
ULVR_all是一个多模态视觉问答推理数据集,包含53,106个样本,旨在支持图像理解和推理任务。数据集提供两种配置:preview配置便于浏览,每个样本包含输入图像、最多三个中间图像、问题、答案以及丰富的元数据(如类别、来源数据集、选项信息等);no_text配置专为Monet SFT训练设计,采用结构化格式,包含元数据(如数据集名称和样本ID)和数据序列,其中数据序列由角色和内容组成,内容可包含文本和图像类型。数据集语言为英语,规模介于1万到10万之间,标签表明其涉及图像、多模态、推理、视觉问答和合成数据。该数据集适用于视觉问答、多模态推理和模型训练等应用场景。
ULVR_all is a multimodal visual question answering (VQA) reasoning dataset consisting of 53,106 samples, developed to support image understanding and reasoning tasks. The dataset provides two configurations: the preview configuration enables convenient browsing, where each sample contains an input image, up to three intermediate images, a question, an answer, and rich metadata including category, source dataset, option information, etc.; the no_text configuration is specially designed for Monet SFT training, adopting a structured format that includes metadata (e.g., dataset name and sample ID) and data sequences. The data sequences are made up of roles and content, where the content can be either text or image type. The dataset is in English, with a scale ranging from 10,000 to 100,000 samples, and its tags indicate that it covers image, multimodal, reasoning, visual question answering and synthetic data. This dataset is applicable to application scenarios such as visual question answering, multimodal reasoning and model training.
数据集概述:ULVR_all
该数据集是一个面向多模态推理的视觉问答(VQA)数据集,包含 53,106 个样本,提供两种配置以满足不同的使用需求。
基本信息
- 数据集名称: ULVR_all
- 语言: 英语 (en)
- 样本规模: 10,000 < n < 100,000 (53,106 条)
- 标签: 图像、多模态、推理、视觉问答、合成数据
两种配置
1. preview(默认配置)
- 用途: 用于浏览和预览数据集内容
- 格式: parquet 文件 (
data/train-*.parquet) - 包含字段:
- 输入数据: 输入图像 (
input_image)、中间图像(最多3张:intermediate_image_1至intermediate_image_3) - 问答对: 问题 (
question)、答案 (answer) - 元数据: 样本ID (
id)、类别 (category)、来源数据集 (source_dataset)、来源ID (source_id)、选项JSON (choices_json)、是否有选项 (has_choices)、选项数量 (num_choices)、中间状态类型 (intermediate_state_types_json)、中间步骤数量 (num_intermediate_steps)、样本目录 (sample_dir)、输入图像路径 (input_image_path)、中间图像路径 (intermediate_image_paths_json)、元数据JSON (metadata_json)、原始文本数据JSON (original_text_data_json)
- 输入数据: 输入图像 (
2. no_text
- 用途: 用于 Monet SFT 训练格式
- 格式: JSONL 文件 (
no_text/train.jsonl) - 包含字段:
- metadata: 包含数据集名称 (
dataset_name) 和样本ID (sample_id) - data: 一个序列,每个元素包含:
- role: 角色(字符串)
- content: 一个序列,每个元素包含:
- type: 类型(字符串)
- text: 文本(字符串)
- image: 图像(字符串)
- metadata: 包含数据集名称 (
- 注意: 训练时需要
images/目录,并使用--dataset_root指向仓库根目录
数据特点
- 数据为合成生成,专注于多模态推理任务。
- 包含中间推理步骤的视觉信息(最多3张中间图像),支持逐步推理的评估。