
Bin1117/AnyEdit
收藏官方服务:
资源简介:
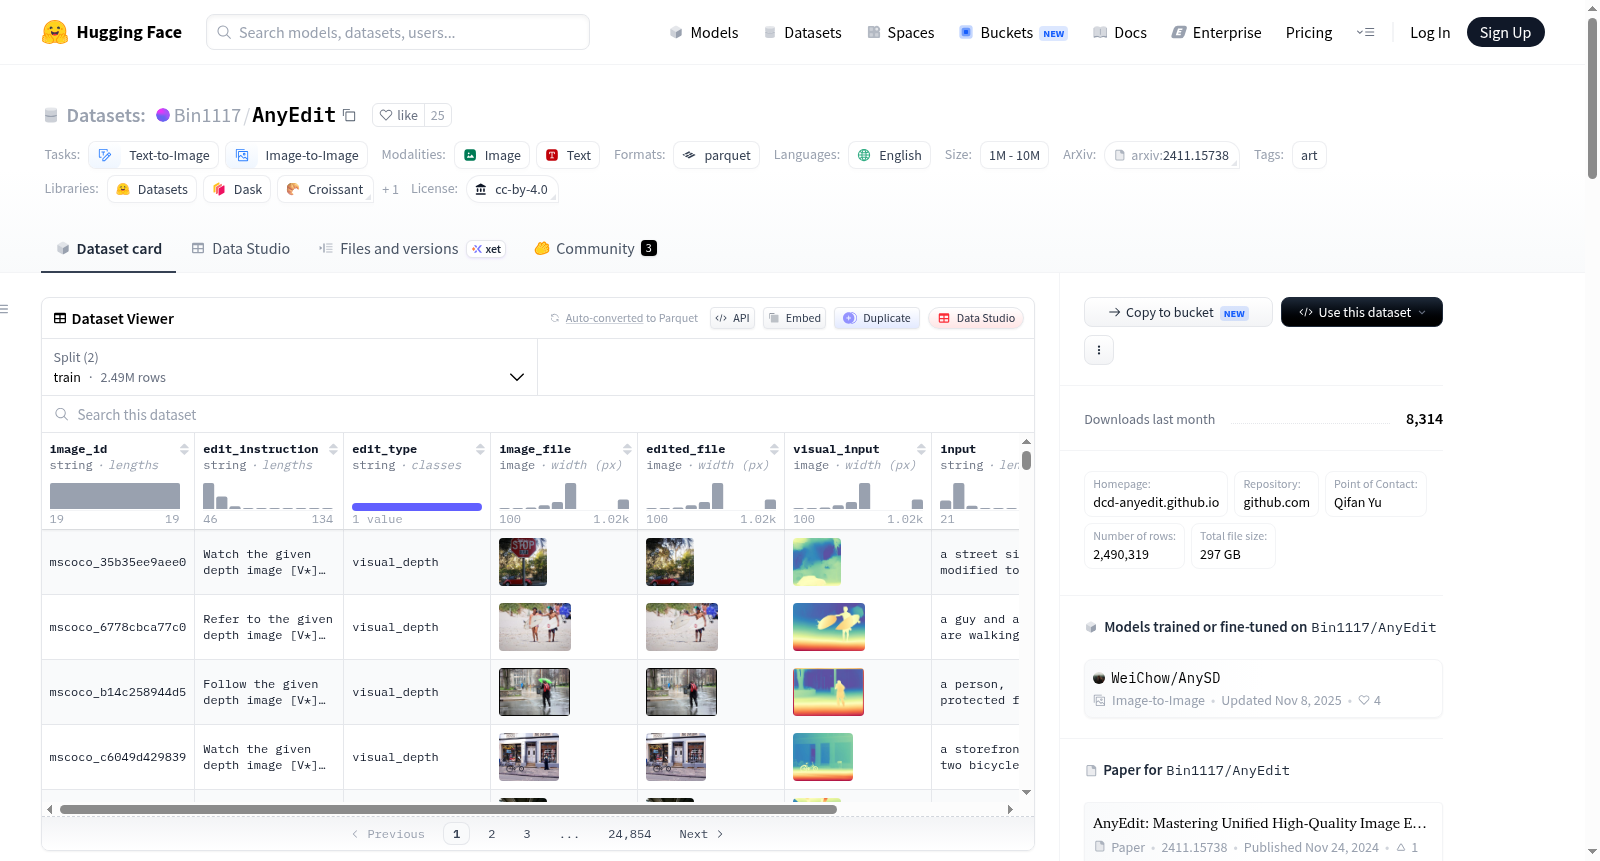
AnyEdit是一个全面的多模态指令编辑数据集,包含250万高质量的编辑对,涵盖25种编辑类型和五个领域。该数据集主要用于基于指令的图像编辑研究,支持文本到图像和图像到图像的转换。数据集的结构包括训练集、验证集和测试集,每个样本包含图像ID、编辑指令、编辑类型、原始图像文件、编辑后的图像文件、视觉输入、输入文本和输出文本等信息。
AnyEdit is a comprehensive multi-modal instruction editing dataset, comprising 2.5 million high-quality editing pairs spanning 25 editing types and five domains. The dataset categorizes image editing tasks into five groups based on different editing capabilities: local editing, global editing, camera move editing, implicit editing, and visual editing. The dataset structure includes training and validation sets, along with detailed instruction formats and file structures. The primary use of the dataset is for research on text-to-image and instruction-based image editing.
提供机构:
Bin1117搜集汇总
数据集介绍
构建方式
AnyEdit数据集由浙江大学研究团队构建,旨在解决指令驱动图像编辑中模型难以精准执行复杂用户指令的瓶颈。数据集以大规模、高质量为导向,系统性地将图像编辑任务划分为五大类别:局部编辑、全局编辑、相机运动编辑、隐式编辑及视觉编辑,共涵盖25种编辑类型与5个领域。构建过程中,团队通过自动化流程生成编辑指令与对应图像对,并辅以人工校验确保数据一致性,最终形成包含约248.5万训练样本和5000验证样本的高质量编辑对,每对数据均包含原始图像、编辑后图像、指令文本及编辑类型标注。
使用方法
用户可通过HuggingFace Datasets库便捷加载AnyEdit数据集。典型使用流程包括:调用load_dataset('Bin1117/AnyEdit')获取训练与验证分片;访问数据字典中的'image_file'、'edited_file'和'visual_input'字段提取原始图像、编辑结果及视觉参考图像;利用'edit_instruction'字段获取编辑指令文本。数据集支持直接用于微调文本到图像或图像到图像的编辑模型,也可作为基准测试评估编辑能力。开发者应参考官方仓库获取测试集以避免数据污染。
背景与挑战
背景概述
基于指令的图像编辑是计算机视觉与自然语言处理交叉领域的前沿研究方向,其目标在于通过自然语言指令精准修改图像中的特定元素。然而,现有模型在应对复杂用户指令时往往力不从心,这主要归因于训练数据质量低下且编辑类型匮乏。为突破这一瓶颈,浙江大学研究团队于2024年推出了AnyEdit数据集,由Qifan Yu等学者主导构建。该数据集包含约250万对高质量编辑样本,覆盖25种编辑类型与五大领域,包括局部编辑、全局编辑、相机运动编辑、隐式编辑及视觉编辑,为多模态指令编辑研究提供了前所未有的数据支撑。AnyEdit的发布显著推动了图像编辑模型的泛化能力与指令执行精度,成为该领域具有里程碑意义的基础资源。
当前挑战
AnyEdit所面临的挑战首先体现在领域问题层面:现有指令编辑模型在处理涉及常识推理、多模态输入或复杂场景变换的编辑任务时,常出现语义理解偏差与视觉不一致性,AnyEdit通过覆盖25种编辑类型试图缓解这一困境,但模型对隐式编辑(如基于常识的对象替换)的鲁棒性仍待验证。在构建过程中,数据集面临数据对齐与质量控制的严峻挑战,尽管团队通过重新上传流程解决了对齐问题,但海量样本(约250万对)的自动化标注与人工校验仍需平衡效率与准确性。此外,编辑类型的多样性导致数据分布不均衡,部分稀有编辑类型(如视觉材质转移)的样本量有限,可能影响模型训练时的稳定性与泛化能力。
常用场景
经典使用场景
AnyEdit数据集最经典的使用场景是基于指令的图像编辑任务,涵盖局部编辑、全局编辑、相机运动编辑、隐式编辑和视觉编辑五大类共25种编辑类型。研究者可利用该数据集训练模型,使其能够根据自然语言指令精准修改图像中的特定元素,例如改变物体颜色、替换背景、旋转视角或依据常识完成复杂编辑。该数据集包含250万对高质量编辑样本,为文本到图像和图像到图像的跨模态学习提供了丰富的训练资源,是推动指令驱动图像编辑技术发展的基石。
解决学术问题
AnyEdit数据集解决了当前指令图像编辑模型中普遍存在的编辑类型有限、数据质量低、复杂指令执行能力不足等学术难题。通过覆盖25种编辑类型和五个领域,它填补了多模态编辑数据在多样性和规模上的空白,使模型能够学习从简单颜色调整到复杂语义修改的广泛技能。该数据集的意义在于为统一图像编辑框架的构建提供了标准化基准,推动了编辑模型在泛化性和鲁棒性上的突破,其影响力体现在促进了文本到图像生成与编辑领域的交叉创新。
实际应用
在实际应用中,AnyEdit数据集训练出的模型可被集成到图像编辑软件、内容创作平台和自动化设计工具中,赋能用户通过自然语言轻松完成图像修饰、风格迁移、物体移除或场景重构等任务。例如,设计师可快速调整产品配色,摄影师可一键改变背景,社交媒体用户可个性化编辑照片。此外,该数据集还支持视觉输入编辑,允许用户提供参考图像,实现如材质迁移或风格模仿等高级功能,显著降低了专业图像编辑的门槛,提升了创作效率。
数据集最近研究
最新研究方向
AnyEdit数据集的最新研究方向聚焦于构建大规模、多类型、高质量的指令驱动图像编辑基准,以突破当前模型在处理复杂用户意图时的瓶颈。该数据集涵盖25种编辑类型与五大领域,包含250万对精细对齐的编辑样本,不仅支持局部与全局编辑,还引入视角变换、隐式常识推理及多模态视觉输入等前沿编辑范式,为文本到图像与图像到图像的双向生成任务提供了统一训练与评估平台。相关工作已在arXiv发表,并公开模型与数据,有望推动AIGC在创意设计、影视后期及交互式内容生成等热点场景中的实际落地与性能跃升。
以上内容由遇见数据集搜集并总结生成


