
multimolecule/archiveii.512
收藏官方服务:
资源简介:
ArchiveII是一个包含RNA序列及其二级结构的数据集,广泛用于RNA二级结构预测基准测试。该数据集包含2975个RNA样本,覆盖10个RNA家族,序列长度范围从28到2968个核苷酸。它常用于评估RNA二级结构预测方法,包括处理假结和非假结结构的方法,并被视为RNAStrAlign数据集的补充。
ArchiveII is a dataset of RNA sequences and their secondary structures, widely used in RNA secondary structure prediction benchmarks. ArchiveII contains 2975 RNA samples across 10 RNA families, with sequence lengths ranging from 28 to 2968 nucleotides. This dataset is frequently used to evaluate RNA secondary structure prediction methods, including those that handle both pseudoknotted and non-pseudoknotted structures. It is considered complementary to the RNAStrAlign dataset.
提供机构:
multimolecule搜集汇总
数据集介绍
构建方式
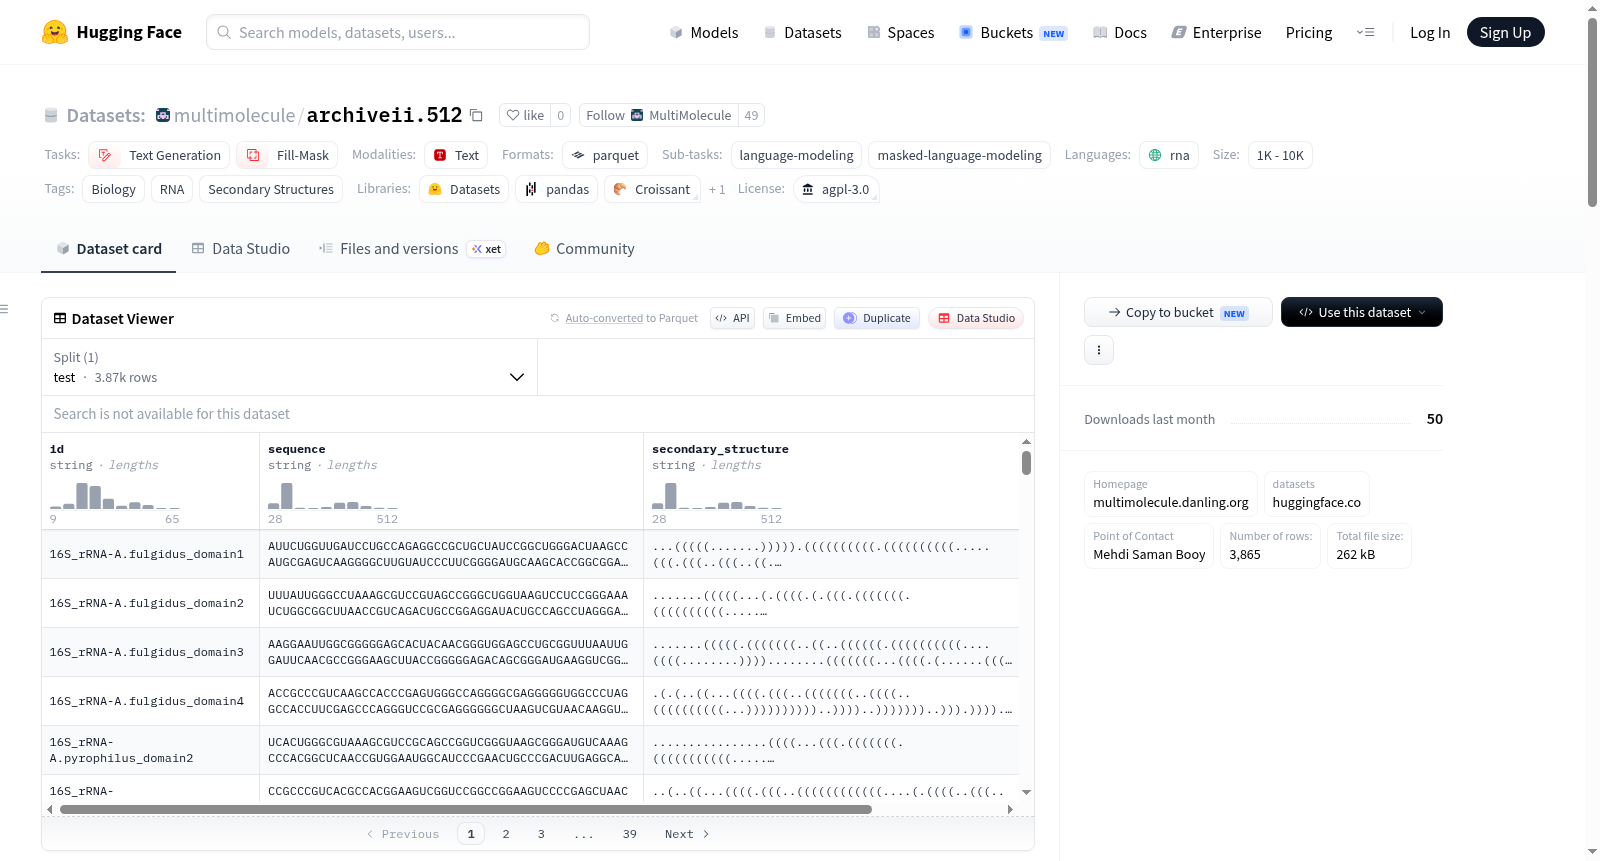
ArchiveII.512数据集源自经典的RNA二级结构基准测试集ArchiveII,由Mehdi Saman Booy等人构建。该数据集通过从原始ArchiveII中筛选序列长度不超过512个核苷酸的样本而得,共计包含来自10个RNA家族的若干条目,每条记录均收录了独特的标识符、标准碱基表示的核苷酸序列、采用点括号记号标注的二级结构,以及其归属的RNA家族信息。其构建旨在为RNA二级结构预测模型提供长度受限的评测数据,尤其适用于处理带假结与不带假结结构的统一评估。
特点
该数据集的核心特点在于其序列长度被严格限制在512个核苷酸以内,从而在保留ArchiveII数据集多样性的同时,聚焦于中等长度RNA分子的结构分析。涵盖10个不同的RNA家族,如16S rRNA和5S rRNA等,提供了丰富的家族多样性。二级结构表示采用bpRNA标准的三类符号(点、圆括号)来区分未配对与配对核苷酸,确保了结构信息的标准化与可解析性。这一特性使其成为评估深度学习模型在中等序列长度上预测性能的理想基准。
使用方法
使用ArchiveII.512数据集时,研究人员可直接从HuggingFace平台加载,因其兼容如transformers等主流框架,故适用于预训练语言模型及掩码语言建模任务。典型应用包括RNA二级结构预测模型的训练与评估,用户可按家族划分数据进行交叉验证,或结合RNAStrAlign等数据集进行补充训练。加载后,通过解析'sequence'与'secondary_structure'字段即可获取输入与标签,进而构建序列到结构的映射任务,有效支持新型深度学习算法的开发与验证。
背景与挑战
背景概述
ArchiveII数据集的创建可追溯至2022年,由Mehdi Saman Booy、Alexander Ilin和Pekka Orponen等研究人员于芬兰阿尔托大学构建,旨在为RNA二级结构预测提供标准化基准测试平台。该数据集整合了10个RNA家族的2975条序列,长度从28至2968个核苷酸不等,广泛涵盖了假结与非假结结构类型。作为RNA结构预测领域的经典资源,ArchiveII不仅被用于评估深度学习方法(如基于卷积神经网络的预测模型),还与RNAStrAlign数据集形成互补,共同推动RNA生物信息学的研究进展。其精选的序列与结构注释为比较不同算法性能提供了可靠参照,显著促进了该领域方法学的改进与创新。
当前挑战
数据集所解决的核心领域挑战在于RNA二级结构预测,特别是对长序列和复杂假结结构的高效建模。传统方法往往受限于序列长度或无法捕获远程相互作用,而ArchiveII通过提供多家族、跨度大的样本,促使研究者设计更适应实际生物场景的模型。构建过程中面临的挑战包括:从原始文献和数据库(如bpRNA、PDB)中手动筛选与标准化带注释的结构,确保不同来源序列的格式统一和结构一致性;筛选序列长度限制在512核苷酸以内的变体(archiveii.512)以适配计算资源,同时保留足够的代表性;以及协调不同RNA家族的多样性,避免类别不平衡对评估的干扰。
常用场景
经典使用场景
ArchiveII.512数据集专注于核糖核酸(RNA)二级结构预测的基准评估,其经典使用场景在于为算法模型提供标准化且多样化的训练与测试平台。该数据集精心筛选了来自10个RNA家族的序列,确保长度不超过512个核苷酸,从而在保持结构复杂性的同时降低计算负担。研究者常利用此数据集检验深度学习架构(如卷积神经网络与循环神经网络)在预测RNA折叠模式时的效能,尤其关注其对伪结(pseudoknot)与非伪结结构的辨识能力,为方法比较与性能优化奠定了坚实的数据基石。
解决学术问题
该数据集有效缓解了RNA二级结构预测领域长期面临的数据稀疏与异质性挑战,解决了因序列长度过长或家族失衡导致的模型泛化能力不足这一核心学术问题。通过提供标准化的短序列子集,ArchiveII.512使得研究者能够更公平地评估不同预测方法(包括基于传统热力学模型与新兴深度学习模型)的准确性、鲁棒性与效率。其意义在于推动了从单一家族检测向多家族统一评测的范式转变,显著提升了结构预测研究的可重复性与可比性,为揭示RNA功能调控机制提供了关键的基准参考。
衍生相关工作
ArchiveII.512的发布催生了一系列具有影响力的衍生工作,包括对原始Archivell数据集的细致清洗与分类,以及结合深度图神经网络(GNN)与迁移学习策略的预测模型创新。其中,基于该数据集的‘RNAformer’与‘SPOT-RNA’等后续研究,通过引入注意力机制与端到端学习范式,显著提升了伪结结构的预测精度。此外,该子集也促使研究者开发出针对长序列的分治策略,并与RNAStrAlign等互补数据集联合,构建了更完善的训练-评测体系,为RNA结构预测迈向通用化与自动化贡献了关键数据动力。
以上内容由遇见数据集搜集并总结生成


