
遇见数据集

co-legal-atoms

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

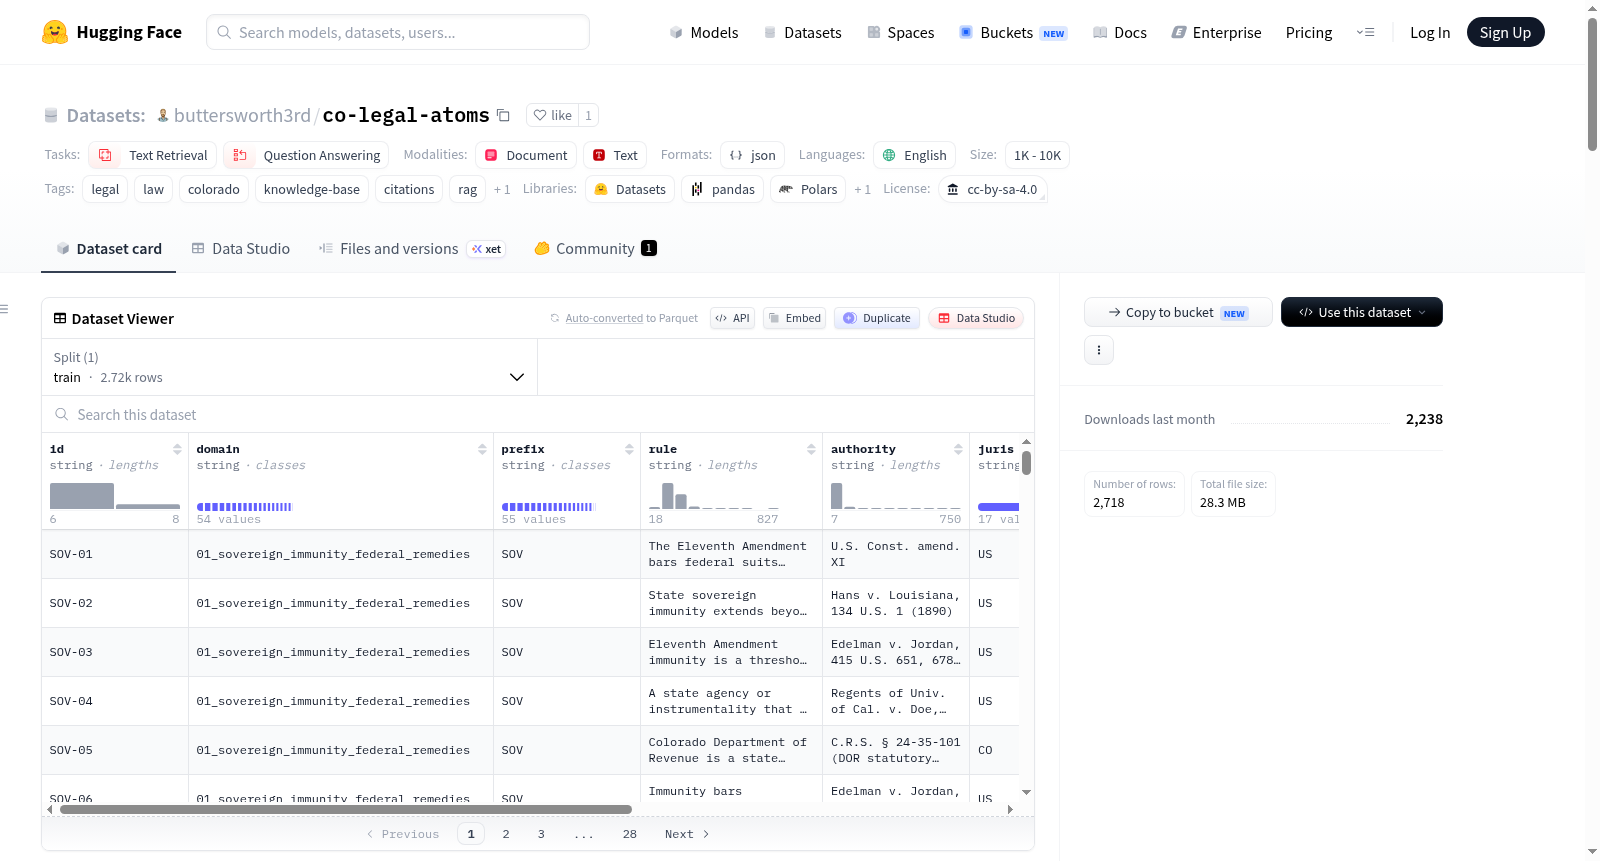
科罗拉多+美国原子化法律知识语料库是一个包含约2,600个原子化法律规则的标注知识库,涵盖科罗拉多州和美国联邦法律的54个领域。该数据集专为法律研究、检索增强生成(RAG)和问答任务设计。每个数据条目代表一个独立的法律命题,包含精确的权威引用(如法规、条例、规则、案例)、司法管辖区标记(US联邦或CO科罗拉多)、新鲜度状态评估(✓已验证、~需确认引用、?使用前需验证)以及相关规则的交叉引用。数据集采用项目无关设计,仅包含法律规则,不涉及任何个人、客户或案件事实。主要格式为Markdown表格(易于版本控制和文本搜索),同时提供扁平化的JSONL导出格式(atoms.jsonl)。数据规模为2,612个原子规则,其中2,486个标记为已验证状态,112个需确认引用,14个需在使用前验证。数据集还包含配套的分析层文件,如逻辑矩阵、概念索引和领域邻接关系,用于指导如何针对特定法律问题组合使用这些规则。数据集采用CC BY-SA 4.0许可证,但明确声明仅用于研究和参考目的,不构成法律建议,使用前必须验证原始权威来源。

The Colorado + United States Atomized Legal Knowledge Corpus is a labeled knowledge base containing approximately 2,600 atomized legal rules, covering 54 domains of Colorado state and U.S. federal laws. This dataset is specifically designed for legal research, Retrieval-Augmented Generation (RAG), and question answering tasks. Each data entry represents an independent legal proposition, containing precise authoritative citations such as statutes, ordinances, rules, and cases, jurisdiction markers (U.S. federal or CO Colorado), freshness status assessments (✓ Verified, ~ Citation to be confirmed, ? Requires verification before use), and cross-references to related rules. The dataset follows a project-agnostic design, containing only legal rules without involving any individuals, clients, or case facts. Its primary format is Markdown tables, which facilitate version control and text search, and it also provides a flattened JSONL export format (atoms.jsonl). In total, the dataset includes 2,612 atomized rules, among which 2,486 are marked as verified status, 112 require citation confirmation, and 14 need verification prior to use. The dataset also includes supporting analytical layer files such as logical matrices, concept indexes, and domain adjacency relationships, to guide the combination and application of these rules for specific legal issues. The dataset is licensed under CC BY-SA 4.0, but it is explicitly stated that it is only for research and reference purposes, does not constitute legal advice, and users must verify the original authoritative sources before use.
创建时间:
2026-06-22
搜集汇总
数据集介绍
co-legal-atoms 数据集图片
构建方式
本数据集以原子化法律规则为核心构建单元,共收录约2,600条科罗拉多州及美国联邦法律规则,覆盖54个法律领域。每条规则均提炼为单一法律命题,并附有精确的权威来源引用(成文法、规章、判例)、管辖权标签、时效性分级以及交叉引用链接。构建过程依赖分层验证机制,包括对原始权威文本的逐条核对、幻觉检测与真实性校准,所有修正记录均内嵌于各领域文件的页脚中。数据集包含完整的工具链与自动化维护引擎,支持从原始法律文本到原子化规则的批量生成与持续更新。
特点
该数据集的核心特点在于其原子化粒度与项目无关性。每条规则独立且自洽,不包含个人、客户或案件事实,可跨项目复用。规则经由时效性分级标记为已验证、待确认或待核查三种状态,便于用户按置信度筛选。数据集采用纯Markdown表格存储,支持Git差异比较与文本检索,并配备逻辑矩阵、概念索引与领域邻接矩阵等分析层,可引导用户按案由类型快速定位相关规则与要素。此外,数据集附有完整的来源文档库与法庭表格构建模块,扩展了法律实务应用场景。
使用方法
用户可将本数据集作为法律研究与检索基底使用。通过搜索关键词或查阅领域索引文件快速定位规则,再依据引用的权威原文进行独立核实。对于检索增强生成或微调场景,建议将Markdown表格解析为结构化记录(含编号、规则、权威来源、管辖权、状态与来源字段),并优先使用已验证状态的数据子集。数据集内置的逻辑矩阵可指导特定案由的法律分析路径,概念索引支持按法律概念反向查找相关规则。用户亦可参照开放的方法论与构建提示,利用附带工具自行构建同类法律知识库。
背景与挑战
背景概述
在法律人工智能领域,将庞杂、动态的法律文本转化为可供机器高效检索与推理的结构化知识表示,始终是制约智能法律助手发展的核心瓶颈。co-legal-atoms数据集由一名研究者主导,借助Claude等AI工具构建,旨在解决法律知识原子化、可验证与可重用的难题。该数据集于2024年创建,专注于美国科罗拉多州及联邦法律,将约2,600条法律规则细化为单一句子级“原子命题”,每一条均附精确的法典、判例或法规出处,并标注管辖区域与时效状态。其独特之处在于“项目无关性”——仅存储法律规则本身,不混入案件事实或个人信息,从而为检索增强生成(RAG)、法律问答系统及知识库微调提供了高质量、可溯源的基础数据。该工作采用CC BY-SA 4.0许可发布,并附详尽的构建方法论,对推动可解释、可验证的法律NLP研究具有重要示范意义。
当前挑战
该数据集所解决的领域问题核心在于法律文本的碎片化与非结构化带来的检索与推理困难。传统法律知识库要么过于粗粒度(整部法典),要么依赖于人工标注的成本高昂、难以扩展。co-legal-atoms通过原子化拆解,将法律命题降维至可独立验证的最小单元,并引入新鲜度分级(✓/~/?)以应对判例法随时效而变动的不确定性。在构建过程中,主要挑战包括:从半结构化法律原文中精准提取单一法律命题,避免信息丢失或错误增补;确保每个原子证据来源的权威性,并通过多轮人工与自动化验证(如反幻觉校验、引用回查)纠正AI生成中的偏差;处理不同子领域间交叉引用的逻辑关联,设计领域邻接矩阵和逻辑矩阵以支持跨领域法律分析;此外,数据集依赖于公共领域文本,但需在CC BY-SA协议下协调其与底层公共领域内容的授权关系,确保二次使用的合规性。
常用场景
经典使用场景
co-legal-atoms数据集是一套精细原子化的法律知识库,涵盖科罗拉多州及美国联邦法律的约2,600条原子化法律规则,横跨54个法律领域。其最经典的使用场景是作为法律检索增强生成(RAG)系统的核心知识底座,每条规则均附带精准引注、效力状态与新鲜度评级,能够显著提升法律问答系统在事实准确性与权威溯源方面的表现。研究者可借助该数据集构建面向法律实务的智能检索管道,实现对具体法律命题的高效定位与交叉验证。
解决学术问题
该数据集着力解决了法律自然语言处理领域中长期存在的知识碎片化与引注模糊性难题。传统法律语料库多保持文本完整性,难以高效提取并关联单一法律命题。co-legal-atoms通过原子化拆分与跨域引用机制,使每条规则均可独立检索、验证与组合。这一设计为法律知识图谱构建、规则逻辑推理以及多层级法律论证分析提供了可复现的基础设施,推动了法律文本结构化处理与细粒度信息抽取研究方法的演进。
衍生相关工作
基于co-legal-atoms数据集已衍生出一系列重要的法律知识工程与工具链工作。其中包括面向不同案由类型的逻辑矩阵(LOGIC_MATRICES.md),将原子规则按实体法问题类型组织为可执行的分析框架;概念索引与领域邻接矩阵(CONCEPT_INDEX.md与DOMAIN_ADJACENCY.md),实现了跨域法律规则的语义关联与知识融合。此外,该数据集还附带了完整的维护引擎(3b_engine),支持引注核查、虚假信息防护与知识缺口检测,为法律知识库的持续演化与质量控制奠定了可扩展的基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

