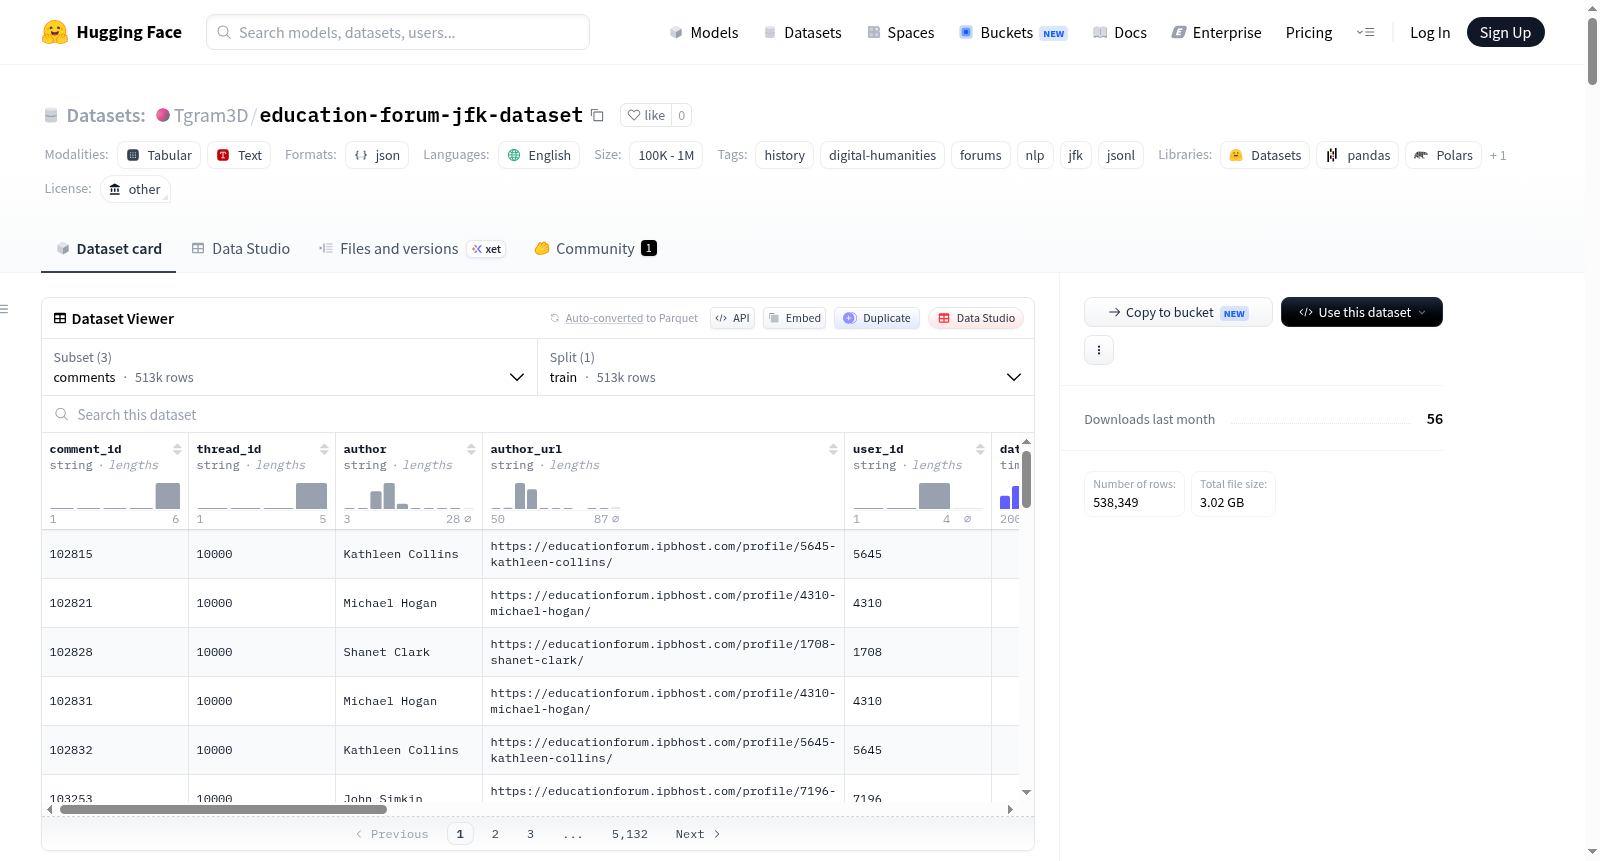
education-forum-jfk-dataset
收藏资源简介:
本数据集是一个结构化的公共讨论存档,核心内容源自教育论坛的“JFK刺杀辩论”板块,并扩展至该论坛其他精选讨论区。论坛汇集了超过二十年间历史学家、研究人员、作家、记者、教育工作者及研究社区成员的对话。数据集以JSON和JSONL格式整理,包含论坛元数据、讨论主题和用户评论,适用于历史研究、自然语言处理、信息检索、数字人文及长期存档等目的。具体规模包括46个讨论区、25,187个讨论主题和513,116条评论,时间跨度为2003年12月至2026年6月。数据组织为forums.jsonl(论坛元数据)、threads.jsonl(讨论主题元数据)和comments.jsonl(评论内容,含纯文本和HTML格式),并提供一个完整的线程存档压缩包。应用场景涵盖历史与数字人文研究、信息检索与RAG、NLP与大语言模型评估、论坛搜索引擎构建、引用网络分析、主题建模、时序分析、社交网络分析与文本挖掘。数据集仅包含公开内容,时间戳采用ISO 8601格式,标识符为字符串。
This dataset is a structured public discussion archive, with core content originating from the "JFK Assassination Debates" section of an educational forum, and expanded to include other curated discussion boards of the same forum. This forum has hosted conversations spanning over two decades among historians, researchers, writers, journalists, educators, and members of the research community. The dataset is organized in JSON and JSONL formats, containing forum metadata, discussion threads, and user comments, and is suitable for applications including historical research, natural language processing, information retrieval, digital humanities, and long-term archival preservation. Specifically, it includes 46 discussion boards, 25,187 discussion threads, and 513,116 comments, with a time span from December 2003 to June 2026. The data is structured into three files: forums.jsonl (forum metadata), threads.jsonl (discussion thread metadata), and comments.jsonl (comment content, including both plain text and HTML formats), with a complete compressed thread archive also provided. Its application scenarios cover historical and digital humanities research, information retrieval and Retrieval-Augmented Generation (RAG), natural language processing (NLP) and large language model (LLM) evaluation, forum search engine construction, citation network analysis, topic modeling, temporal analysis, social network analysis, and text mining. The dataset only contains publicly available content, with timestamps in ISO 8601 format and identifiers as strings.
Education Forum 肯尼迪遇刺辩论数据集
数据集概述
该数据集包含 Education Forum 论坛中围绕 JFK 遇刺辩论 板块的公开讨论线程结构化存档。自 2.0 版本 起,数据集还纳入了 Education Forum 其他板块的精选讨论区。论坛涵盖二十多年间的讨论,参与者包括历史学家、研究人员、作家、记者、教育工作者及更广泛的研究社区。
数据统计
| 指标 | 数值 |
|---|---|
| 版本 | 2.0.1 |
| 论坛数 | 46 |
| 线程数 | 25,187 |
| 评论数 | 513,116 |
| 时间跨度 | 2003年12月 – 2026年6月18日 |
| 来源论坛 | Education Forum – JFK 遇刺辩论 |
数据格式
JSONL 格式(推荐)
数据集位于 threads_jsonl/ 目录下,包含三个文件:
forums.jsonl:每个论坛一条 JSON 记录,包含forum_id、title、url、category、thread_count、comment_countthreads.jsonl:每个讨论线程一条 JSON 记录,包含thread_id、forum_id、title、url、author、datetime、comment_count等comments.jsonl:每条论坛评论一条 JSON 记录,包含comment_id、thread_id、author、text、content_html(保留原始HTML结构)等
线程存档
EducationForum_ThreadArchive.zip 包含完整的线程归档,按论坛分类和层级组织,每个线程为一个独立 JSON 文档,保留完整元数据、HTML 和媒体引用。
文件关系
forums.jsonl → forum_id → threads.jsonl → thread_id → comments.jsonl
每个论坛包含一个或多个线程,每个线程包含一个或多个评论,可通过 thread_id 关联到父级论坛。
主要论坛分布
| 论坛 | 线程数 | 评论数 |
|---|---|---|
| JFK 遇刺辩论 | 19,217 | 416,270 |
| 政治阴谋 | 1,794 | 23,492 |
| 政治讨论 | 532 | 24,463 |
| Watergate | 544 | 2,638 |
| Water Coolers | 7 | 14,085 |
| 其他论坛(共46个) | 3,093 | 31,758 |
辅助工具
utils.py 模块提供加载 JSONL 数据集和检索完整讨论线程的辅助函数,例如:
python from utils import get_thread_by_id thread, comments = get_thread_by_id("32102")
潜在用途
- 历史研究
- 数字人文
- 信息检索
- 检索增强生成 (RAG)
- 自然语言处理
- 大语言模型评估
- 论坛搜索引擎
- 引用网络分析
- 主题建模
- 时间序列分析
- 社交网络分析
- 文本挖掘
注意事项
- 时间戳采用 ISO 8601 格式
- 标识符(
forum_id、thread_id、comment_id、user_id)以字符串形式存储 - 部分访客帖子没有关联会员资料,
author_url为null - 数据集仅包含公开可访问的论坛内容